

Oui, le contenu de GPT-6 Astra est détectable dans les tests publiés actuels. Deux grandes études de fournisseurs ont signalé plus de 99 % des échantillons non édités et connus comme étant de l'IA qu'elles ont évalués, et une comparaison plus petite a révélé que cinq détecteurs différents ont tous signalé le même essai Astra. C'est une preuve solide que la production Astra peaufinée ne devient pas automatiquement invisible aux détecteurs d'IA.
Ce n'est pas une preuve que chaque détecteur attrapera chaque passage Astra. Plus important encore, un score élevé ne peut pas vous dire qui a écrit un document, quel modèle l'a produit, ou si une personne a utilisé l'IA du tout. La question utile n'est pas simplement "L'IA peut-elle détecter GPT-6 Astra ?" C'est ce que les preuves disponibles mesurent réellement, et ce qu'elles laissent sans réponse.
Réponse rapide : Le contenu de GPT-6 Astra est-il détectable ?
Pour une prose anglaise non éditée d'une longueur raisonnable, la réponse est souvent oui. Les résultats publics les plus solides disponibles en octobre 2026 vont dans la même direction, bien qu'ils proviennent de sociétés de détection et utilisent des échantillons, des seuils et des règles d'inclusion différents.
| Test publié | Matériel Astra testé | Résultat rapporté | Ce qu'il établit | Ce qu'il n'établit pas |
|---|---|---|---|---|
| Originality.ai | 1 000 réponses Astra connues dans cinq catégories d'écriture | 999 ont dépassé son seuil d'IA | Très haute détection de cet échantillon connu comme étant de l'IA avec un réglage de détecteur | Taux de faux positifs ou performance sur l'écriture humaine |
| Pangram | 986 réponses Astra évaluées à partir de prompts filtrés | 982 IA, 3 mixtes, 1 humain | Taux de classification entièrement IA très élevé pour les passages éligibles | Performance en dessous de son minimum de 50 mots ou sur des contrôles humains |
| Comparaison de cinq détecteurs | Un essai Astra de 300 mots | 5 outils sur 5 l'ont signalé ; quatre ont affiché leur score d'IA maximum | Plusieurs détecteurs se sont accordés sur cet essai particulier | Précision à l'échelle du modèle à partir d'un échantillon d'un seul document |
| Expérience sur la longueur des passages | 40 textes Astra présentés en quatre longueurs | 9/40 détectés à 25 mots, 29/40 à 50, et 40/40 à 100 et 200 | La longueur peut modifier matériellement le résultat d'un détecteur | Une longueur minimale universelle pour chaque détecteur |
La conclusion pratique est simple : un article Astra complet est plus susceptible de produire un signal de détection significatif qu'une phrase copiée. Même alors, "signalé" signifie que l'écriture correspondait aux modèles que le détecteur associe à l'IA. Cela ne signifie pas que l'outil a récupéré une étiquette GPT-6 cachée.
Ce que GPT-6 Astra change – et ce qu'il ne change pas
OpenAI positionne GPT-6 Astra comme son modèle le plus performant pour le raisonnement exigeant, la recherche, le codage, l'utilisation informatique et la création de documents. Il est conçu pour suivre des instructions détaillées et soutenir un travail complexe, ce qui peut produire des brouillons plus cohérents et utiles que la réponse stéréotypée d'un chatbot.
La documentation du modèle elle-même note également une tendance à la mise en forme détaillée et aux phrases récurrentes, à moins que l'utilisateur ne spécifie un style d'écriture différent. Cette observation aide à expliquer pourquoi une capacité et une détectabilité améliorées peuvent coexister. Un document peut être précis, bien organisé et fluide tout en présentant des régularités qu'un classificateur statistique remarque.
C'est là que les gens font souvent le mauvais raccourci. Une meilleure prose ne semble pas nécessairement plus humaine à un détecteur, car les détecteurs n'évaluent pas la prose pour son intelligence ou son utilité. Ils estiment si ses schémas linguistiques ressemblent au matériel de leurs données d'entraînement d'IA et humaines.
L'écriture maladroite n'est pas non plus automatiquement générée par l'IA. Les humains répètent les transitions, utilisent des structures d'essai formulaires et écrivent également des phrases génériques. Un détecteur lit des schémas, pas l'intention, la paternité ou l'historique derrière le curseur.
Ce que les tests de détection de GPT-6 Astra publiés ont révélé
Les études principales semblent remarquablement cohérentes. Leurs méthodes, cependant, répondent à des questions plus étroites que ce que les titres suggèrent parfois.
Originality.ai : 999 réponses sur 1 000 ont dépassé le seuil
Originality.ai a généré et scanné 1 000 réponses Astra en anglais : 200 blogs, 200 textes conversationnels, 200 réponses expositives, 200 réponses d'actualité et 200 critiques. Il a considéré un score d'au moins 0,50 en mode « AI Allowance 15% » comme détecté.
Tous les échantillons de blogs, d'exposés, d'actualités et de critiques ont dépassé ce seuil. La catégorie conversationnelle a renvoyé 199 détections sur 200, soit 999 sur 1 000 au total. Le seul résultat en dessous du seuil était de l'écriture conversationnelle.
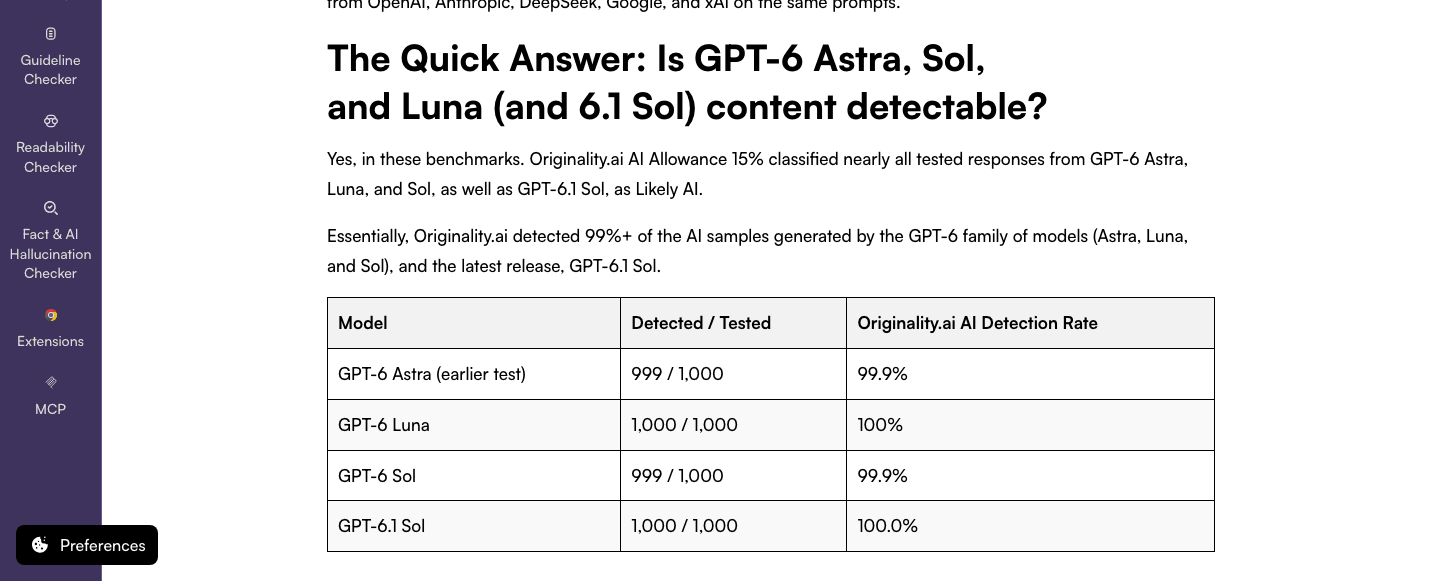
Il s'agit d'un résultat de détection d'IA connue solide pour ce détecteur et ce réglage. Ce n'est pas une étude d'exactitude complète car il n'y avait pas de collection correspondante d'écriture humaine. Sans négatifs humains, l'étude ne peut pas montrer à quelle fréquence le même détecteur pourrait signaler une personne.
Pangram : Quatre productions n'ont pas été entièrement classées comme IA
Pangram a commencé avec 1 032 réponses Astra à des prompts filtrés de première interaction de Chatbot Arena. Il n'a pas évalué 46 réponses contenant moins de 50 mots, laissant 986 passages éligibles.
Parmi ceux-ci, 982 ont été classés comme IA, trois comme mixtes et un comme humain. Les résultats non-IA incluaient des formats courts ou créatifs tels qu'un e-mail, une explication et un poème. Ce détail est important car les erreurs n'étaient pas réparties uniformément sur un ensemble uniforme de longs essais.
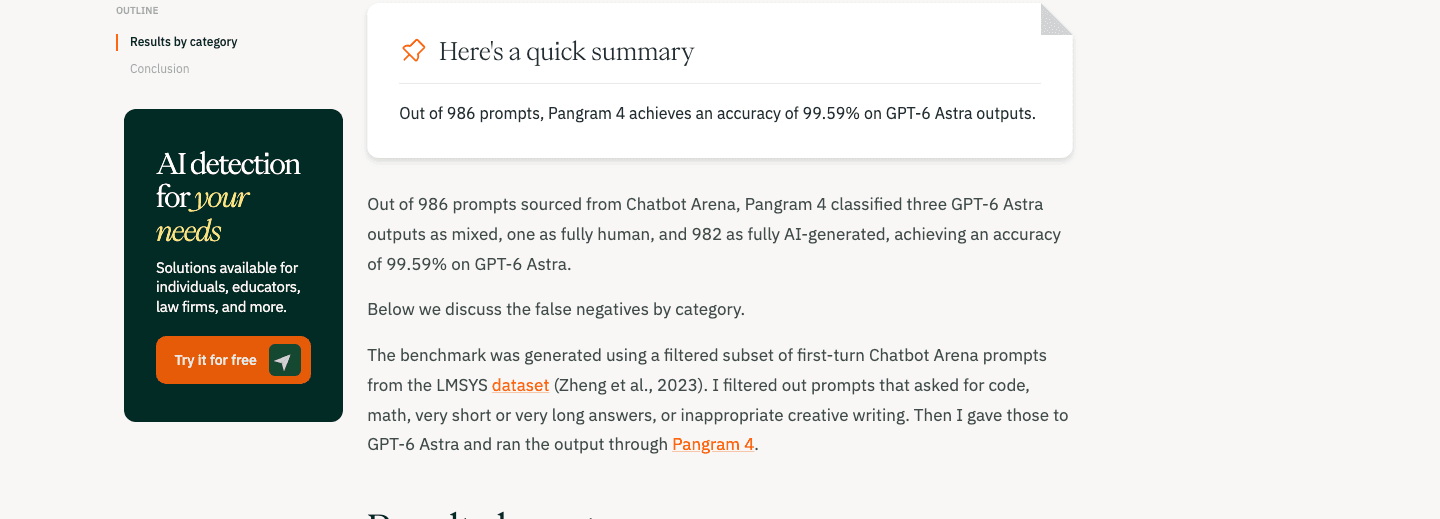
L'étude soutient un taux de détection élevé pour le texte Astra qui répondait à l'exigence de longueur de Pangram. Elle ne nous dit pas comment les réponses courtes exclues auraient été notées, et elle ne contient pas non plus de groupe de contrôle humain pour estimer les faux positifs.
Cinq détecteurs se sont accordés sur un essai Astra
Une étude plus petite a pris un essai Astra de 300 mots et l'a scanné avec Phrasly, GPTZero, Pangram, Copyleaks et QuillBot. Chaque outil a signalé l'essai. Quatre ont renvoyé leur score d'IA maximum affiché, tandis que QuillBot a renvoyé 82 % d'IA.
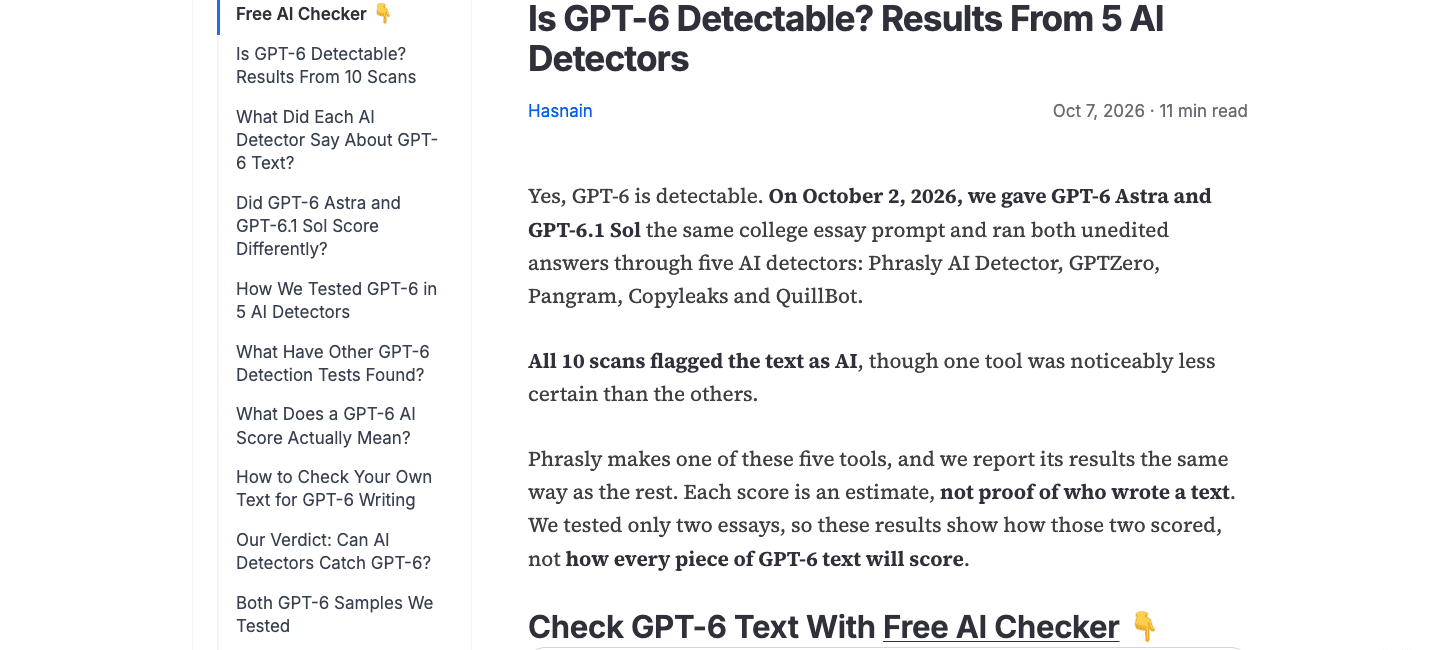
Cette comparaison est utile car elle maintient le texte constant tout en changeant le détecteur. Elle montre que l'accord entre les outils est possible, mais elle montre également que leurs pourcentages ne sont pas interchangeables. Un score de 82 % et un score maximum peuvent conduire à la même étiquette pratique tout en provenant de modèles et d'échelles différents.
Un seul essai ne peut pas établir la performance de cinq détecteurs sur des blogs, des e-mails, des rapports techniques et des brouillons édités. C'est un aperçu inter-outils, pas un classement.
Le même texte est devenu plus difficile à détecter lorsqu'il a été raccourci
Le résultat le plus révélateur est peut-être la plus petite étude. Des chercheurs ont pris 40 passages Astra connus et ont montré au même détecteur les 25, 50, 100 ou 200 premiers mots de chaque passage. Seule la quantité de texte visible a changé.
À 25 mots, 9 passages sur 40 ont été détectés. À 50 mots, 29 passages sur 40 ont été détectés. À 100 et 200 mots, les 40 ont dépassé le seuil.
Cela n'établit pas une règle universelle de 100 mots. Cela montre pourquoi la vérification d'une phrase isolée peut produire une fausse assurance : il peut ne pas y avoir suffisamment de langage pour que le détecteur trouve un modèle stable.
Notre réanalyse : 99,9 % de détection n'est pas 99,9 % de précision en situation réelle
Les chiffres publiés permettent un calcul indépendant utile. Un résultat d'échantillon est une estimation, nous avons donc recalculé des intervalles de confiance de Wilson approximatifs à 95 % au lieu de traiter chaque pourcentage comme exact.
| Nombre publié | Taux observé | Intervalle approximatif à 95 % | Interprétation prudente |
|---|---|---|---|
| Originality.ai : 999/1 000 | 99,90 % | 99,44 %-99,98 % | Taux de détection élevé sur des échantillons Astra connus dans le cadre du réglage rapporté |
| Originality.ai conversationnel : 199/200 | 99,50 % | 97,22 %-99,91 % | Résultat solide, mais moins précis car l'échantillon de la catégorie est plus petit |
| Pangram entièrement IA : 982/986 | 99,59 % | 98,96 %-99,84 % | Taux de classification entièrement IA élevé parmi les productions éligibles évaluées |
Ces intervalles renforcent la conclusion selon laquelle les taux de détection d'IA connue rapportés étaient élevés. Ils ne comblent pas la moitié manquante de l'expérience.
Pour mesurer un détecteur dans le monde réel, nous avons besoin de documents d'IA et de documents humains. C'est la seule façon de voir si un outil détecte l'IA sans accuser trop de personnes.
| Métrique | Les études Astra-seulement peuvent-elles la calculer ? | Pourquoi c'est important |
|---|---|---|
| Taux de détection sur le texte d'IA connu | Oui | Montre à quelle fréquence l'outil détecte les échantillons d'IA qui lui ont été donnés |
| Taux de faux négatifs | Oui | Montre combien d'échantillons d'IA connus ont été manqués selon les règles du test |
| Spécificité | Non | Nécessite du texte humain pour mesurer à quelle fréquence le travail humain est correctement validé |
| Faux positifs | Non | Nécessite du texte humain pour compter à quelle fréquence des personnes sont signalées à tort |
| Précision | Non | Dépend à la fois des faux positifs et de la fréquence du texte d'IA dans la population vérifiée |
| Précision globale | Non | Nécessite des exemples positifs et négatifs, plus un équilibre de classes défini |
Appeler 999 sur 1 000 « 99,9 % de précision » suppose implicitement que la seule erreur possible est de manquer l'IA. Dans une salle de classe, une salle de rédaction ou un processus d'embauche, signaler à tort un humain est une erreur différente et souvent plus lourde de conséquences. Les tests Astra-seulement n'ont pas été conçus pour la mesurer.
Pourquoi le même texte GPT-6 Astra peut obtenir des scores différents
Les résultats des détecteurs sont sensibles au document qui leur est soumis. Le nom d'un modèle seul ne peut pas prédire le score final.
La longueur du passage modifie le signal disponible. Un e-mail de 20 mots et un rapport de 1 000 mots peuvent provenir du même modèle mais offrir des quantités de preuves très différentes. Les scores faibles sur de courts extraits méritent une interprétation particulièrement prudente.
Le genre modifie le modèle linguistique. Dans le test d'Originality.ai, l'écriture conversationnelle contenait la seule erreur. Les classifications non entièrement IA de Pangram incluaient des formats tels qu'un poème, un e-mail et une courte explication. Un détecteur calibré sur des essais peut se comporter différemment sur un dialogue ou une prose créative.
Le prompt façonne la sortie. Astra peut suivre des contraintes détaillées concernant le ton, la structure, le public et les exemples. Deux personnes utilisant le même modèle peuvent recevoir un texte avec un rythme et une spécificité très différents.
Les versions et les seuils des détecteurs diffèrent. Chaque outil définit ses propres étiquettes, données d'entraînement, longueur minimale et seuil de décision. Un pourcentage d'un service n'est pas un score que vous pouvez comparer point par point avec un autre.
L'édition humaine modifie le texte examiné. L'ajout de preuves originales, la réorganisation d'un argument, la correction de faits et la réécriture à partir de connaissances personnelles peuvent altérer le modèle statistique. Cela ne donne pas une recette fiable pour éviter la détection, et cela n'efface pas la nécessité de divulguer l'utilisation de l'IA lorsqu'une politique l'exige.
Un détecteur peut-il dire que GPT-6 Astra l'a écrit ?
Non. Un détecteur de texte typique n'identifie pas le modèle exact qui a produit un passage. Aucun des cinq outils de la comparaison inter-détecteurs n'a nommé Astra ; ils ont renvoyé des variantes d'IA, mixtes, humaines ou un score de probabilité.
| Question | Un détecteur de texte peut-il y répondre ? |
|---|---|
| Ce passage ressemble-t-il à des modèles associés à l'écriture IA ? | Il peut l'estimer, avec incertitude. |
| L'IA a-t-elle été impliquée quelque part dans le processus d'écriture ? | Pas de manière fiable à partir du texte final seul. |
| GPT-6 Astra a-t-il spécifiquement produit ce passage ? | Non. Le score n'identifie pas le modèle exact. |
| Qui a entré le prompt ou édité la sortie ? | Non. Cet historique est en dehors du texte. |
| Le document viole-t-il une politique scolaire ou professionnelle ? | Non. Cela nécessite la politique, le contexte et le jugement humain. |
La formulation la plus défendable est donc « le passage a été signalé comme étant de type IA », et non « le détecteur a prouvé que cela a été écrit par GPT-6 Astra ».
Comment vérifier le texte GPT-6 Astra avec Lynote
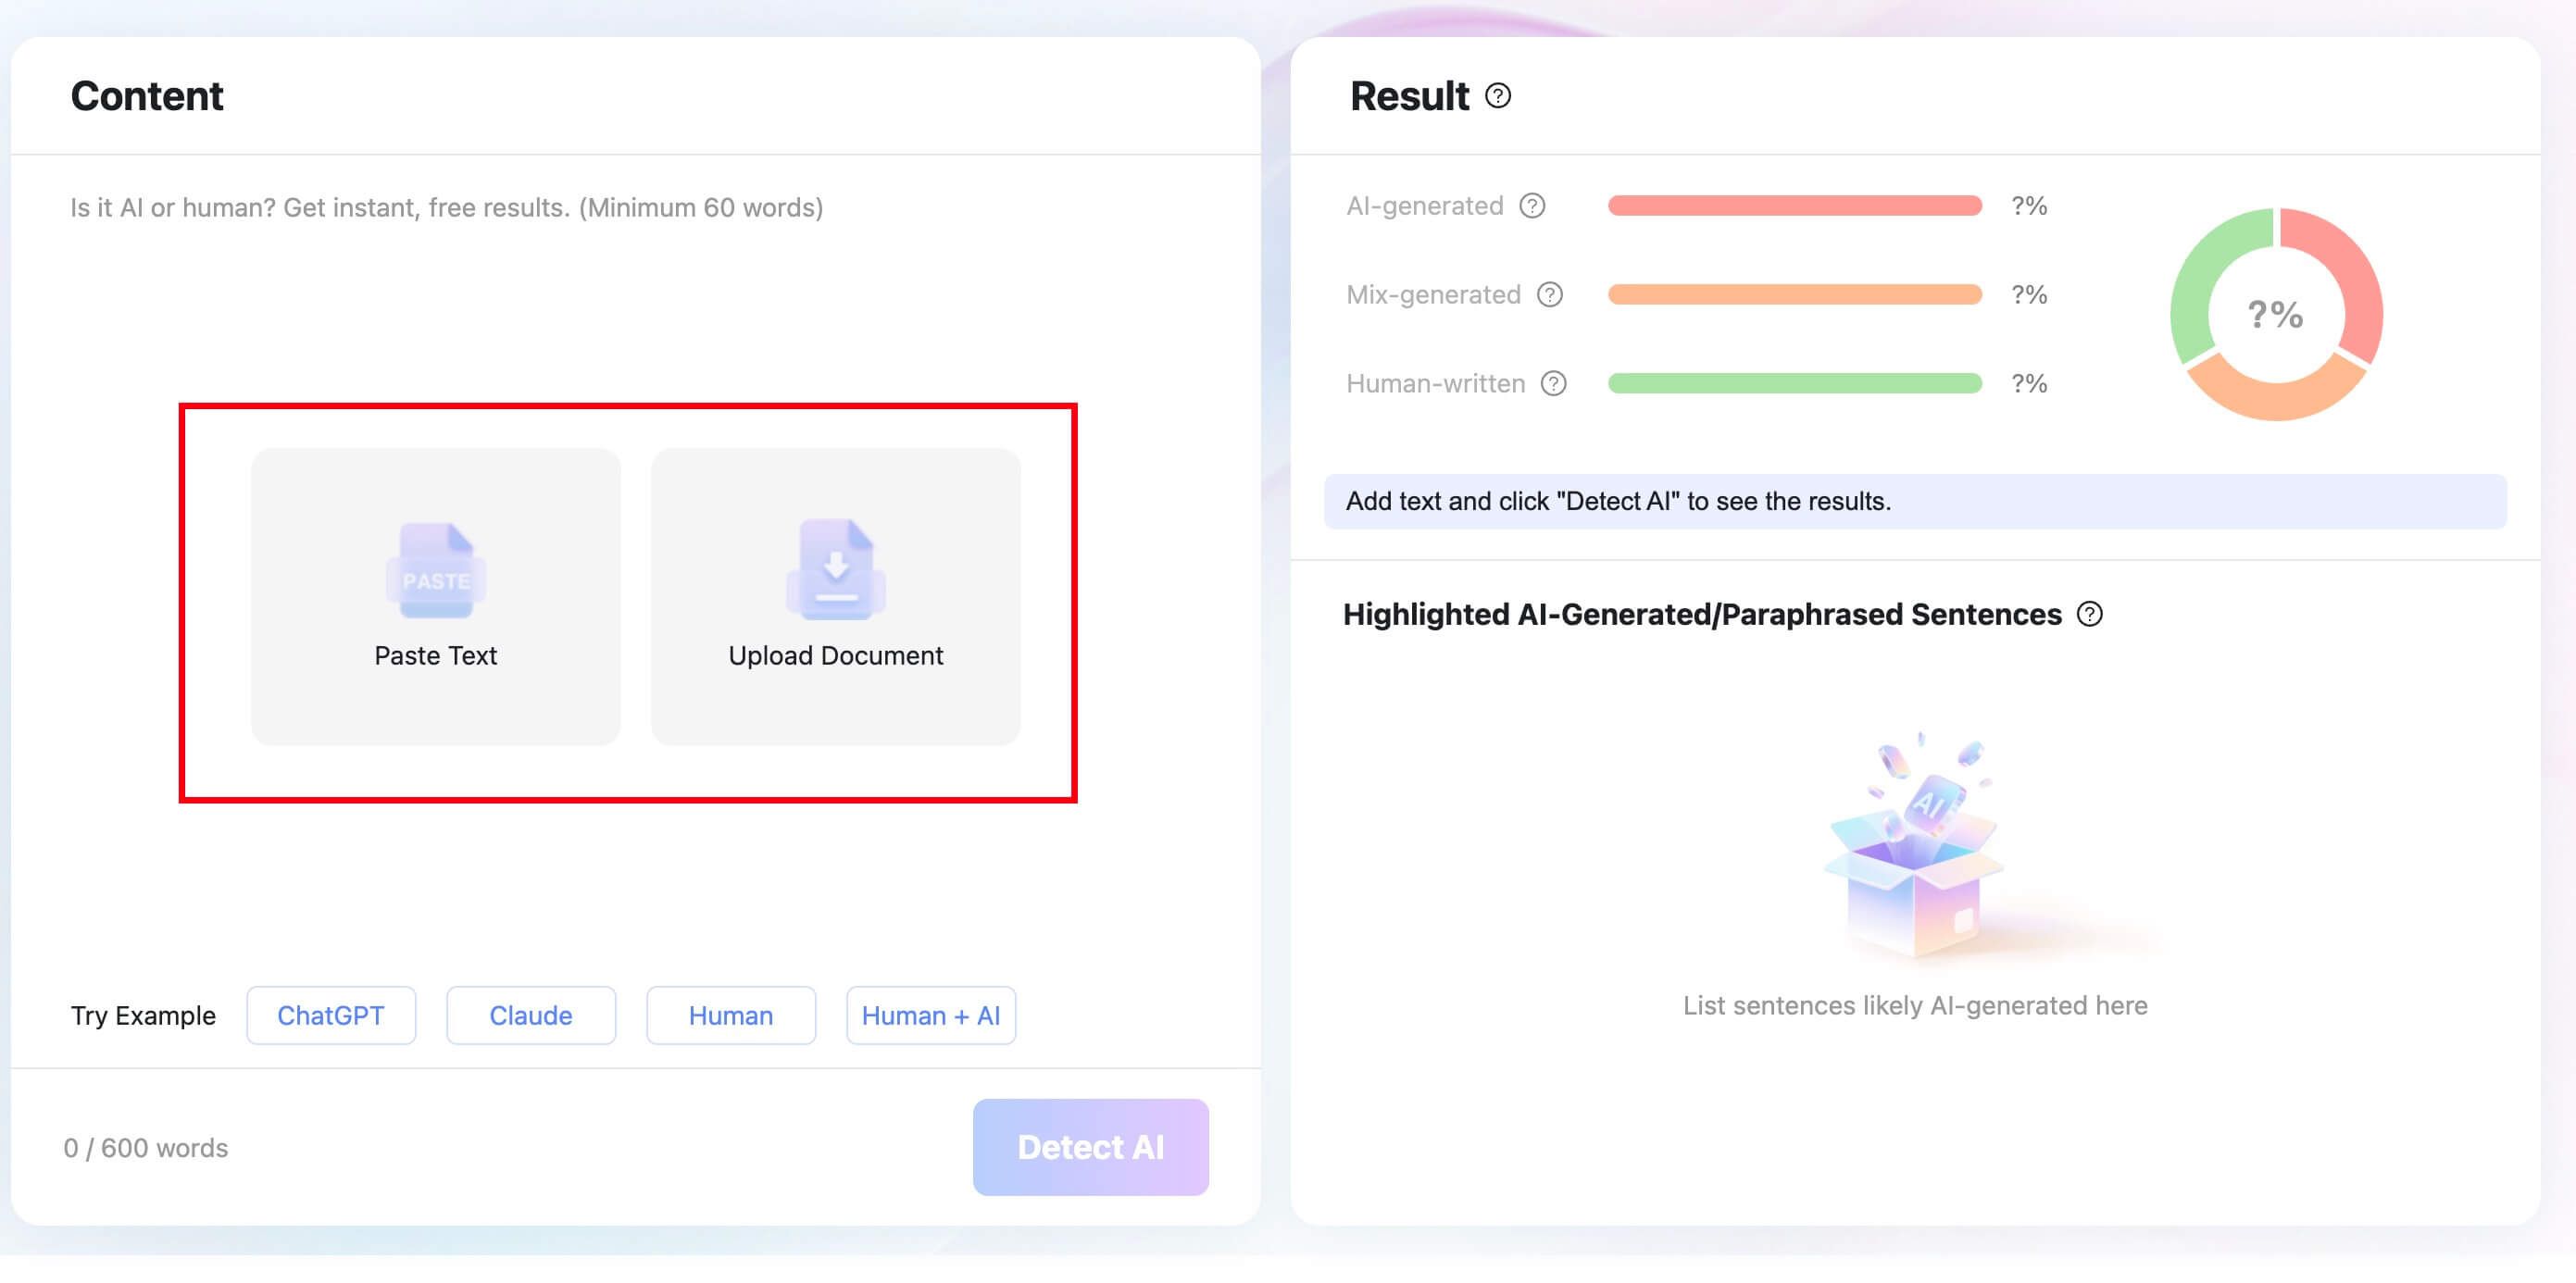
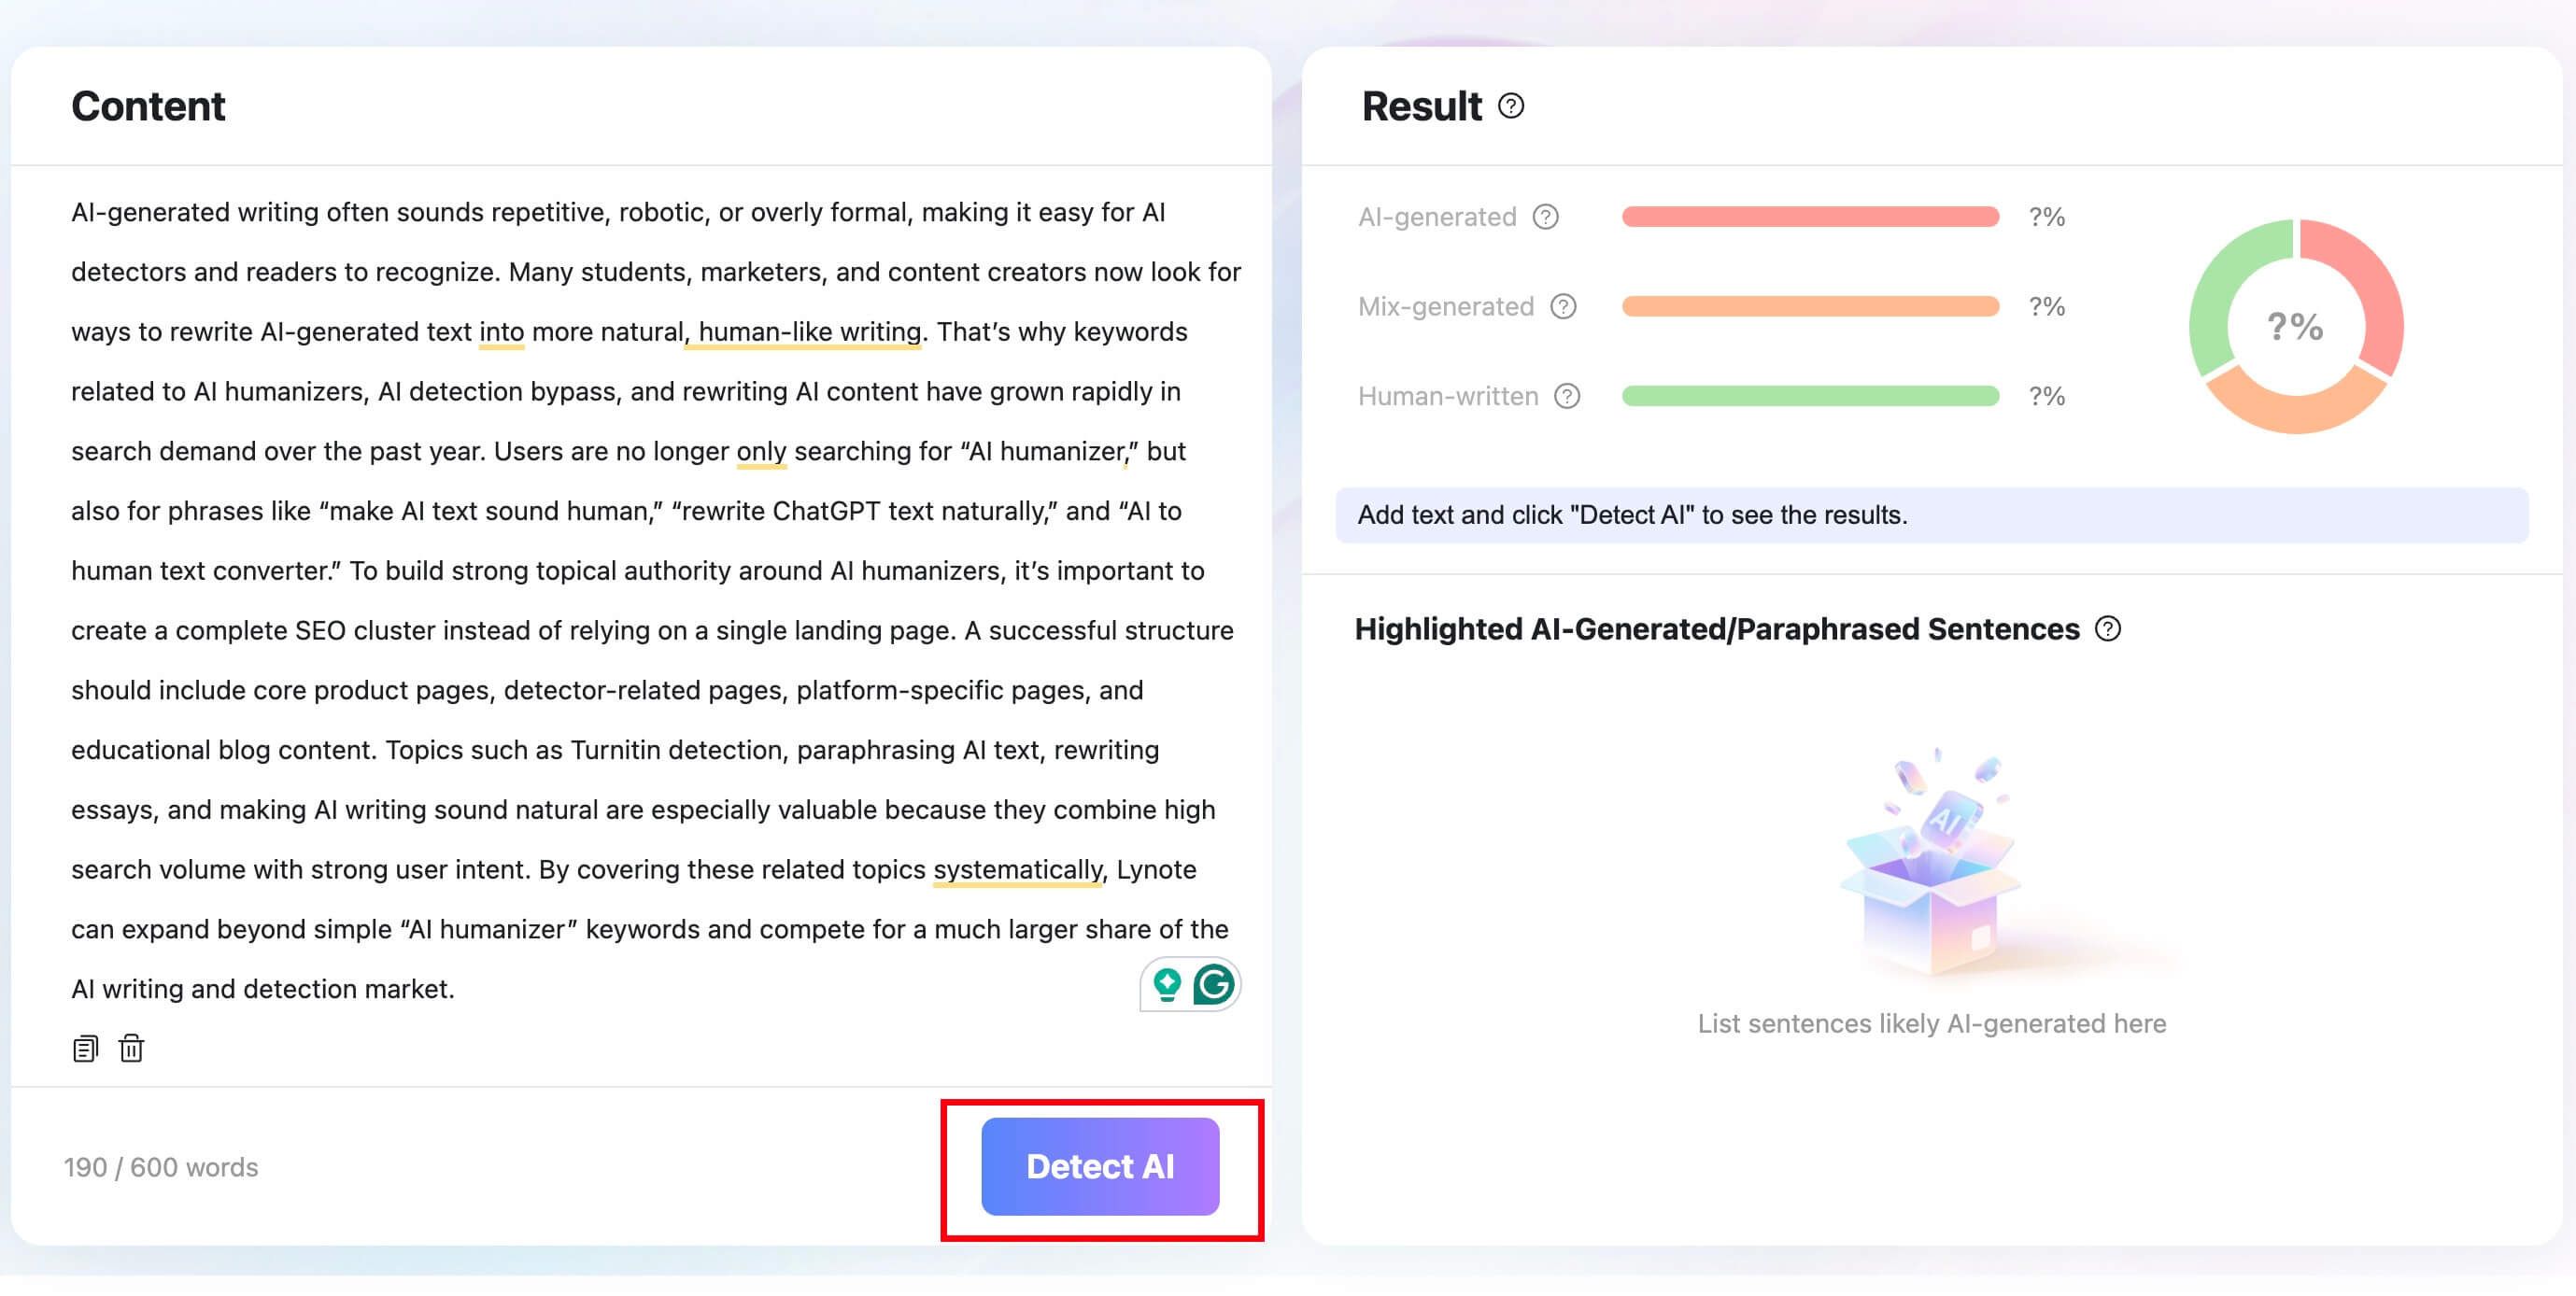
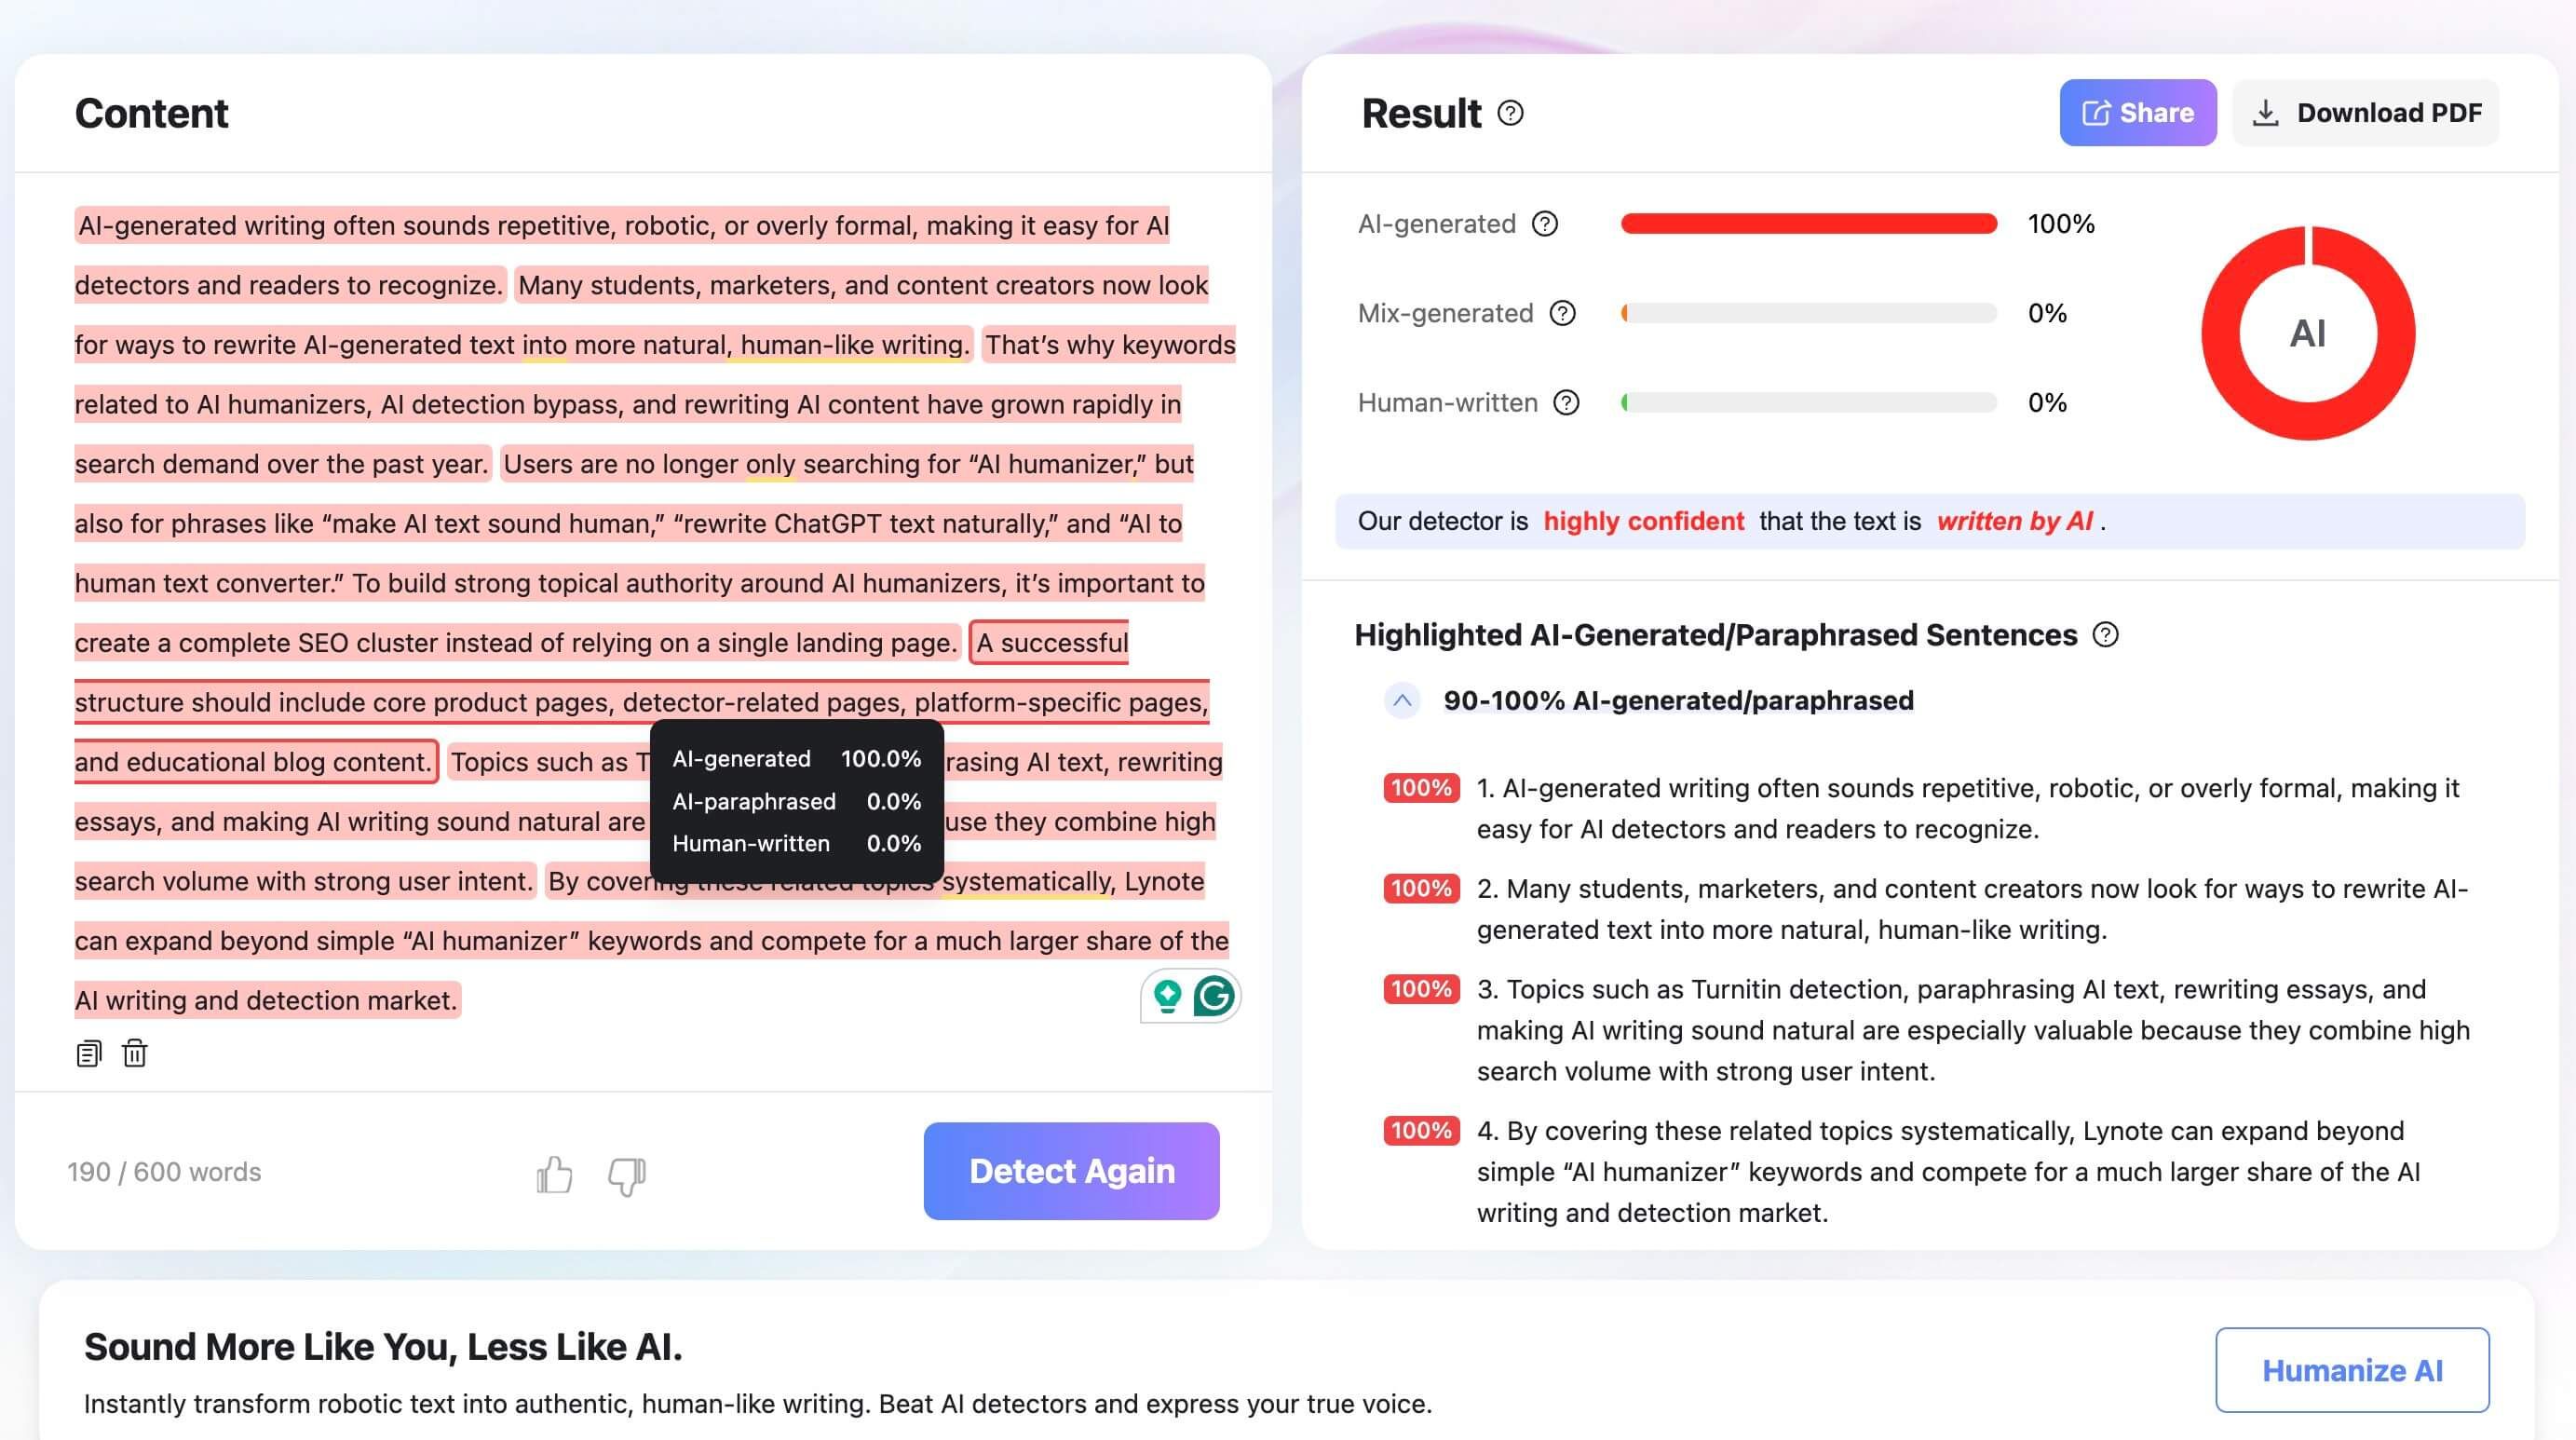
Si vous souhaitez examiner un brouillon complet plutôt que de deviner à partir de quelques phrases, Lynote AI Detector offre un flux de travail simple de première passe. Il sépare son résultat en pourcentages générés par l'IA, mixtes et écrits par des humains, et met en évidence les phrases pour un examen plus approfondi.
-
Collez le texte ou téléchargez un document. Utilisez la zone de texte pour une vérification rapide, ou téléchargez un fichier DOCX, PDF ou TXT pris en charge. Soumettez une section significative plutôt qu'une ligne isolée lorsque cela est possible.
-
Lancez l'analyse. Cliquez sur Détecter l'IA et laissez l'outil analyser le texte soumis.
-
Examinez le résultat complet. Lisez les pourcentages d'IA, mixtes et humains ensemble, puis inspectez les phrases mises en évidence au lieu de réagir uniquement au plus grand nombre.
-
Comparez le signal avec des preuves extérieures au détecteur. Examinez les brouillons, l'historique des versions, les sources citées, les notes et l'explication de l'auteur avant de tirer une conclusion.
Le résultat peut vous dire où chercher. Il ne peut pas vous dire qui a écrit le document ni si son utilisation de l'IA était autorisée.

Comment interpréter un score d'IA élevé ou faible
Un score ne devient utile que s'il modifie ce que vous examinez ensuite.
| Si le score est élevé | Si le score est faible |
|---|---|
| Lisez les passages mis en évidence dans leur contexte. | Ne traitez pas le résultat comme une preuve qu'une personne l'a écrit. |
| Vérifiez les affirmations, les citations, les exemples et les changements inhabituels de ton. | Vérifiez si le passage est trop court pour un résultat stable. |
| Comparez le document avec les brouillons précédents ou l'historique des versions. | N'oubliez pas que les détecteurs peuvent manquer du texte d'IA et que les mises à jour des modèles peuvent modifier les performances. |
| Interrogez l'auteur sur le processus plutôt que de présenter le score comme un verdict. | Utilisez d'autres preuves si la paternité ou la conformité à la politique est importante. |
| Demandez un deuxième examen humain pour les décisions importantes. | Évitez de déclarer le document « vérifié humain » à partir d'une seule analyse. |
Pour les rédacteurs qui révisent leur propre travail, un score élevé n'est pas une instruction pour effectuer des substitutions aléatoires ou ajouter des erreurs délibérées. Une meilleure réponse est de vérifier chaque affirmation, de remplacer le remplissage générique par des preuves spécifiques et de s'assurer que l'argument final reflète votre propre compréhension.
Pour les éducateurs et les éditeurs, le détecteur doit lancer une révision, pas la terminer. Les preuves de processus vous en disent souvent plus qu'une probabilité attachée au brouillon final.
Le problème des faux positifs reste important
Des taux de détection d'IA connue élevés et des faux positifs peuvent coexister. Un détecteur peut détecter presque tous les échantillons Astra dans un benchmark tout en ayant des difficultés avec certains types d'écriture humaine.
Des chercheurs de Stanford ont précédemment découvert que les détecteurs GPT largement utilisés classaient fréquemment à tort l'écriture d'auteurs non anglophones. Une étude plus récente de 2026 a examiné 135 389 paires de manuscrits écrits par des humains avant et après une révision professionnelle en anglais. Sur 13 détecteurs, les taux de faux positifs rapportés couvraient toute la plage possible, et les mêmes modifications d'édition ont poussé différents détecteurs dans des directions opposées.
Cela ne signifie pas que chaque détecteur est inutile. Cela signifie que le style peut devenir une variable confondante : un phrasé formel, une grammaire cohérente, un vocabulaire limité ou une édition professionnelle peuvent affecter un score même lorsque la paternité n'a pas changé.
Les propres directives de Turnitin reflètent cette incertitude. Elles décrivent son rapport d'IA comme un point de données et affirment qu'il n'est pas destiné à fournir des réponses définitives de manière isolée.
C'est un conseil judicieux au-delà de l'éducation également. Une note, un emploi, une décision de publication ou une accusation ne devraient pas reposer sur un pourcentage opaque.
FAQ sur la détection de l'IA GPT-6 Astra
Turnitin peut-il détecter GPT-6 Astra ?
Turnitin peut signaler le texte généré par les modèles linguistiques plus récents lorsque l'écriture correspond aux modèles que son système associe à l'IA. Cependant, aucun benchmark public Turnitin spécifique à Astra examiné pour cet article n'établit un taux de détection, et Turnitin affirme que son rapport ne doit pas être utilisé comme une réponse définitive en soi.
Un détecteur d'IA peut-il identifier spécifiquement GPT-6 Astra ?
Non. Les résultats actuels des détecteurs estiment généralement si le texte semble généré par l'IA, mixte ou humain. Ils n'identifient pas de manière fiable Astra comme le modèle exact ni ne révèlent l'historique du prompt et de l'édition.
L'édition du texte GPT-6 Astra modifie-t-elle son score ?
Oui, cela peut. Une édition humaine significative modifie la formulation, la structure, les preuves et la voix, ce qui peut altérer l'estimation du modèle par un détecteur. La direction est imprévisible, et l'édition devrait améliorer la précision et la qualité de la paternité plutôt que de viser à manipuler un score.
De combien de texte un détecteur a-t-il besoin ?
Les exigences varient selon l'outil. Dans une expérience Astra, la détection sur les mêmes passages est passée de 9 sur 40 à 25 mots à 29 sur 40 à 50 mots et à la totalité des 40 à 100 mots. Ce résultat appartient à un seul détecteur, mais il montre pourquoi un passage complet est plus informatif qu'une phrase.
Le score d'IA le plus élevé possible est-il la preuve que Astra a écrit le texte ?
Non. C'est la classification la plus forte du détecteur selon son propre modèle et son échelle. Cela ne prouve pas quel modèle d'IA a été utilisé, qui l'a utilisé, ou si une personne a substantiellement édité le document.
L'écriture humaine peut-elle être signalée comme contenu GPT-6 ?
L'écriture humaine peut recevoir un score de type IA, surtout lorsqu'un détecteur réagit au style plutôt qu'à l'origine. L'écriture non anglophone, la prose académique très standardisée et le texte édité professionnellement méritent une prudence particulière car la recherche a documenté des faux positifs incohérents.
Un score faible est-il la preuve qu'un humain a écrit le texte ?
Non. Un score faible signifie que le détecteur n'a pas trouvé suffisamment de preuves associées à l'IA pour dépasser son seuil. Les passages courts, les genres inhabituels et les sorties d'IA éditées peuvent tous réduire la confiance de la détection.
Verdict final
GPT-6 Astra est détectable dans les tests publiés les plus solides disponibles à ce jour. Originality.ai a signalé 999 des 1 000 productions Astra connues, Pangram a entièrement classé 982 des 986 productions éligibles comme étant de l'IA, et cinq détecteurs distincts se sont accordés sur un essai Astra non édité.
Ces résultats soutiennent une conclusion étroite : les détecteurs actuels peuvent souvent reconnaître la prose Astra non éditée et de longue forme. Ils ne montrent pas que chaque détecteur est également fiable, que les textes courts ou édités se comporteront de la même manière, ou qu'un score prouve la paternité.
Utilisez la détection d'IA comme un triage. Donnez suffisamment de texte à l'outil, lisez les passages mis en évidence, puis vérifiez les preuves qu'un classificateur ne peut pas voir : brouillons, sources, contexte, historique d'écriture et la personne derrière le travail.
Écrit par Danny
Responsable Marketing Produit
Danny explique comment les fonctionnalités de Lynote s'intègrent dans de vrais flux de travail, de la productivité quotidienne aux cas d'utilisation de rédaction axée sur le produit. Voir tous les articles →