

はい、GPT-6 Astraのコンテンツは、現在公開されているテストで検出可能です。 2つの大規模なベンダー調査では、未編集の既知のAIサンプルを99%以上検出しました。また、小規模な比較では、5つの異なる検出器がすべて同じAstraのエッセイにフラグを立てました。これは、洗練されたAstraの出力がAI検出器によって自動的に見過ごされるわけではない、という強力な証拠です。
これは、すべての検出器がすべてのアストラの一節を検出できるという証明ではありません。さらに重要なのは、高いスコアだけでは、誰が文書を作成したのか、どのモデルが作成したのか、あるいは人がAIを全く使用しなかったのかを判断できないということです。有用な問いは、単に「AIはGPT-6 Astraを検出できるか?」ではありません。むしろ、利用可能な証拠が実際に何を測定し、何を未解明のままにしているか、という点にあります。
簡易回答:GPT-6 Astraのコンテンツは検出可能か?
適切な長さの未編集の英語散文であれば、多くの場合「はい」です。2026年10月に入手可能な最も強力な公開結果は同様の結果を示していますが、これらは検出器を提供する企業によるものであり、異なるサンプル、しきい値、および判定基準を使用しています。
| 公開テスト | テストされたAstraの素材 | 報告された結果 | 確立されたこと | 確立されなかったこと |
|---|---|---|---|---|
| Originality.ai | 5つの執筆カテゴリにわたる1,000の既知のAstra応答 | 999がAIしきい値を超えた | 1つの検出器設定におけるこの既知のAIサンプルの非常に高い検出率 | 誤検知率または人間の執筆に対するパフォーマンス |
| Pangram | フィルタリングされたプロンプトからの986のAstra応答のスコア | 982がAI、3が混合、1が人間 | 該当する文章に対する非常に高い完全AI分類率 | 50語の最小値以下または人間によるコントロールに対するパフォーマンス |
| 5つの検出器の比較 | 1つの300語のAstraエッセイ | 5つのツールのうち5つがフラグを立てた。4つは最大AIスコアを表示 | いくつかの検出器がその特定のエッセイで一致した | 1つの文書サンプルからのモデル全体の精度 |
| 文章長実験 | 4つの長さで表示された40のAstraテキスト | 25語で9/40、50語で29/40、100語と200語で40/40が検出された | 長さが検出器の結果を大きく変える可能性がある | すべての検出器に対する普遍的な最小長 |
実用的な結論は以下の通りです。完全なAstraの記事は、そこからコピーされた1文よりも、意味のある検出器信号を生成する可能性が高いです。その場合でも、「フラグが立てられた」とは、その文章が検出器がAIと関連付けるパターンに一致したことを意味します。それは、ツールが隠されたGPT-6のラベルを回復したことを意味するものではありません。
GPT-6 Astraが変えるもの、変えないもの
OpenAIは、GPT-6 Astraを、高度な推論、研究、コーディング、コンピューターの利用、および文書作成において最も高性能なモデルとして位置付けています。これは、詳細な指示に従い、複雑な作業を維持できるよう構築されており、典型的なチャットボットの回答よりも一貫性があり、より有用なドラフトを作成できます。
このモデル自身のドキュメントには、ユーザーが異なる執筆スタイルを指定しない限り、詳細な書式設定と繰り返し表現の傾向があることも指摘されています。この観察は、機能の向上と検出可能性が共存し得る理由を説明するのに役立ちます。文書は正確で、よく整理され、流暢である一方で、統計分類器が認識する規則性を示すことがあります。
ここで人々はしばしば誤った判断をしてしまいがちです。より良い散文が検出器にとって必ずしもより人間らしく見えるわけではありません。なぜなら、検出器は散文を知性や有用性の観点から評価するわけではないからです。彼らは、その言語パターンがAIおよび人間のトレーニングデータ内の素材に似ているかどうかを推定しているに過ぎません。
また、ぎこちない文章が自動的にAIによって書かれたものであるとは限りません。人間もまた、接続表現を繰り返し、定型的なエッセイ構造を用い、一般的な文章を書きます。検出器はパターンを読み取るものであり、意図、作者、またはカーソルの背後にある履歴を読み取るのではありません。
公開されたGPT-6 Astra検出テストの結果
主要な研究は驚くほど一貫しています。しかし、その方法は、見出しが示唆するよりも限定的な問いに答えています。
Originality.ai: 1,000件の応答のうち999件がしきい値を超えた
Originality.aiは、1,000件の英語のAstra応答(ブログ200件、会話文200件、説明文200件、ニュース応答200件、レビュー200件)を生成し、スキャンしました。AI Allowance 15%モードで0.50以上のスコアを検出されたとみなしました。
すべてのブログ、説明文、ニュース、レビューのサンプルがそのしきい値を超えました。会話カテゴリでは200件中199件が検出され、全体で1,000件中999件が検出されました。しきい値を下回った唯一の結果は会話文でした。
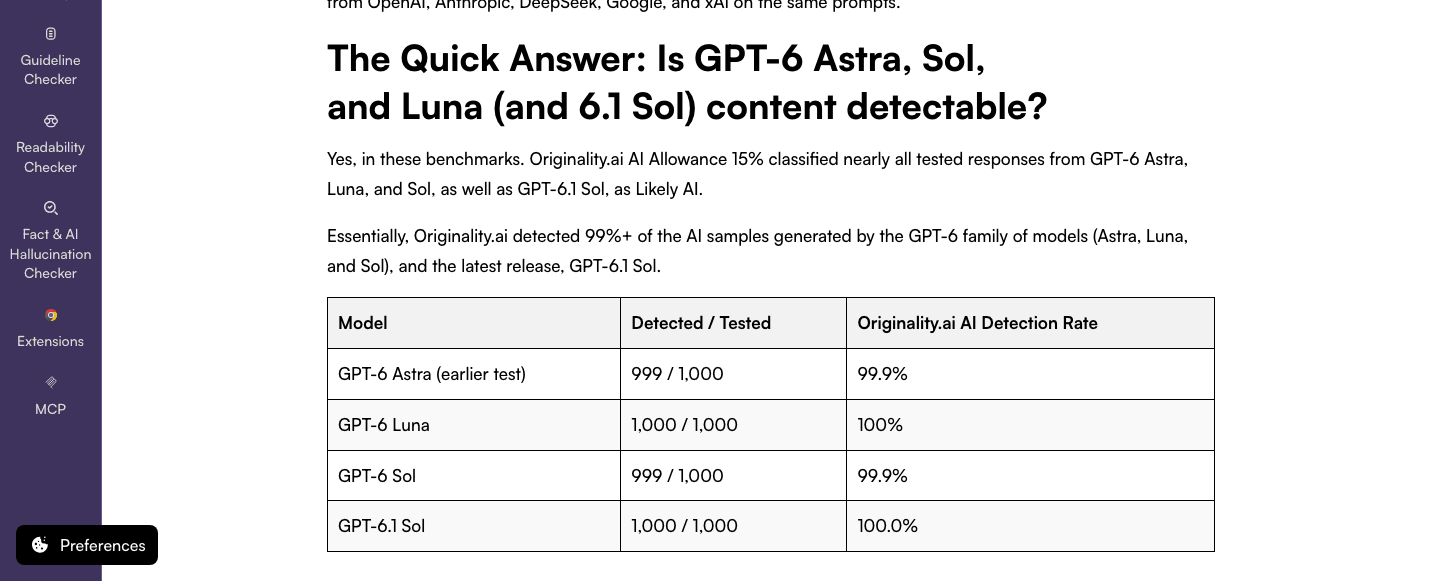
これは、その検出器と設定における強力な既知のAI検出結果です。人間が書いた文章の比較対象がなかったため、完全な精度研究ではありません。人間による陰性サンプルがないと、同じ検出器が人を誤ってAIと判定する頻度を示すことはできません。
Pangram: 4つの出力はAIとして完全に分類されなかった
Pangramは、フィルタリングされた最初のChatbot Arenaプロンプトに対する1,032件のAstra応答から開始しました。50語未満の46件の応答はスコア付けを行わず、986件の対象となる文章が残りました。
そのうち、982件がAI、3件が混合、1件が人間として分類されました。非AIの結果には、メール、説明、詩などの短い形式や創造的な形式が含まれていました。見逃しが均一な長文エッセイのセット全体に均等に分布していたわけではないため、この詳細は重要です。
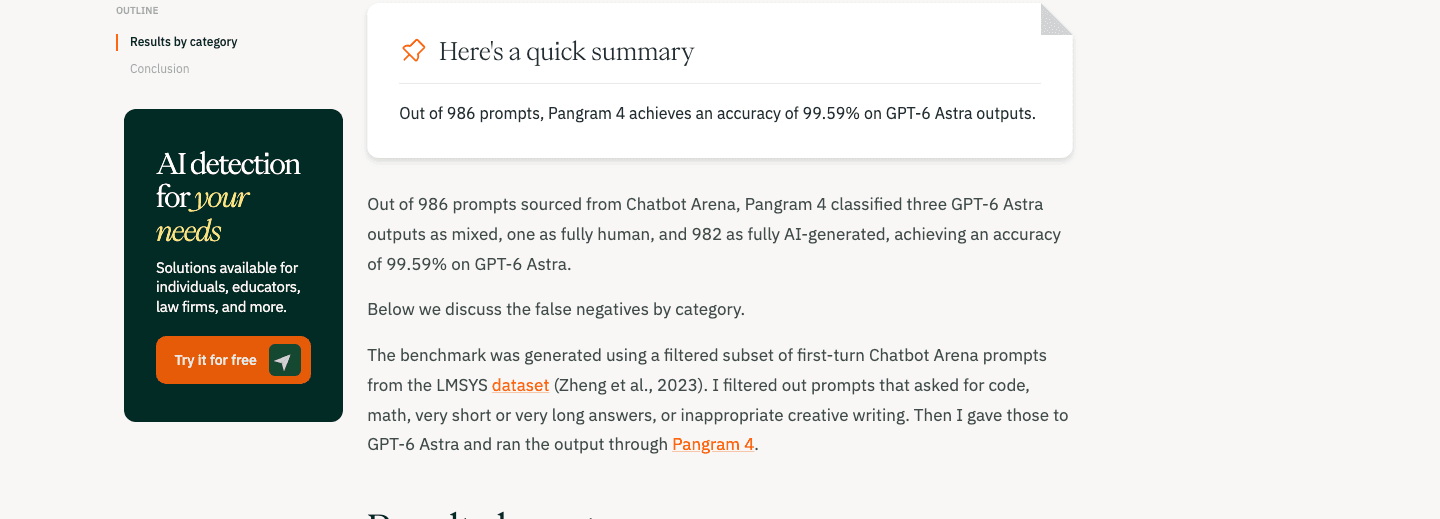
この研究は、Pangramの長さ要件を満たしたAstraテキストの高い検出率を示しています。除外された短い回答がどのようにスコア付けされたかは示されておらず、誤検知を推定するための人間による対照群も含まれていません。
5つの検出器が1つのAstraエッセイで一致
より小規模な研究では、1つの300語のAstraエッセイを取り上げ、Phrasly、GPTZero、Pangram、Copyleaks、QuillBotでスキャンしました。すべてのツールがそのエッセイにフラグを立てました。4つのツールは最大表示AIスコアを返し、QuillBotは82% AIを返しました。
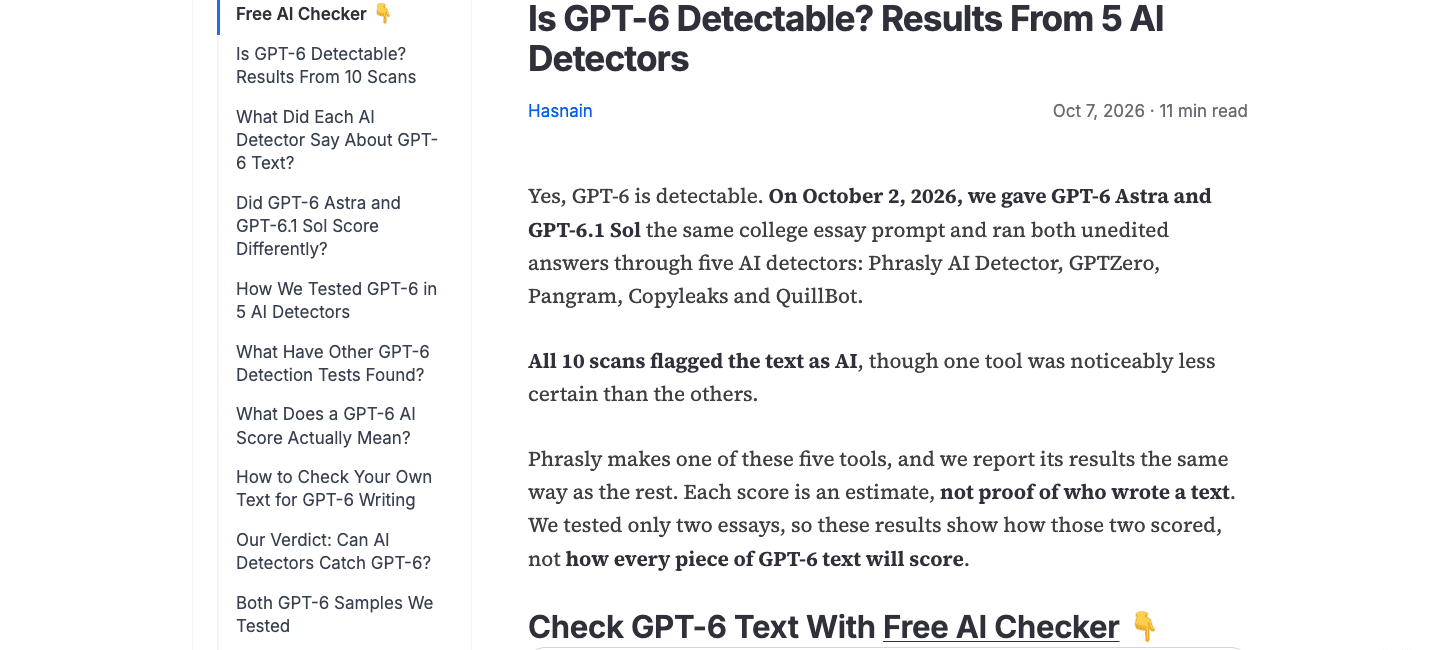
この比較は、検出器を変更しながらテキストを一定に保つため有用です。ツール間の合意が可能であることを示していますが、そのパーセンテージが互換性がないことも示唆しています。82%のスコアと最大スコアは、異なるモデルとスケールから来ていても、同じ実用的な判定結果につながる可能性があります。
1つのエッセイだけでは、ブログ、メール、技術レポート、編集されたドラフト全体にわたる5つの検出器のパフォーマンスを確立することはできません。これはツール間のスナップショットであり、ランキングではありません。
同じテキストが短縮されると検出が難しくなった
最も示唆に富む結果は、最も小規模な研究かもしれません。研究者たちは、40の既知のAstraの文章を取り上げ、同じ検出器に各文章の最初の25、50、100、または200語を示しました。目に見えるテキストの量だけが変更されました。
25語では、40の文章のうち9つが検出されました。50語では、40の文章のうち29が検出されました。100語と200語の両方では、40すべてがしきい値を超えました。
これは普遍的な100語ルールを確立するものではありません。しかし、孤立した文をチェックすることが誤った安心感を与えかねない理由を示しています。検出器が安定したパターンを見つけるのに十分な言語がない可能性があるからです。
私たちの再分析:99.9%の検出率は99.9%の現実世界での精度ではない
公開された数値は、有用な独立した計算を可能にします。サンプル結果は推定値であるため、各パーセンテージを正確なものとして扱うのではなく、おおよその95%ウィルソン信頼区間を再計算しました。
| 公開された数 | 観測された割合 | おおよその95%信頼区間 | 慎重な解釈 |
|---|---|---|---|
| Originality.ai: 999/1,000 | 99.90% | 99.44%-99.98% | 報告された設定における既知のAstraサンプルに対する高い検出率 |
| Originality.ai 会話型: 199/200 | 99.50% | 97.22%-99.91% | 強力な結果だが、カテゴリサンプルが小さいため精度は低い |
| Pangram 完全AI: 982/986 | 99.59% | 98.96%-99.84% | 対象となるスコア付き出力における高い完全AI分類率 |
これらの区間は、報告された既知のAI検出率が高かったという結論を裏付けています。しかし、実験の欠けている半分を補うものではありません。
現実世界で検出器を測定するには、AIと人間の両方の文書が必要です。それが、ツールがAIを検出する一方で、あまりにも多くの人々を誤ってAIと判定しないかどうかを確認する唯一の方法です。
| 指標 | Astraのみの研究で計算可能か? | なぜ重要か | | --- | --- | --- | --- | | 既知のAIテキストの検出率 | はい | ツールが与えられたAIサンプルをどれだけ頻繁に検出するかを示す | | 偽陰性率 | はい | テストルール下でどれだけの既知のAIサンプルが見逃されたかを示す | | 特異度 | いいえ | 人間の作業がどれだけ頻繁に正しくクリアされるかを測定するために人間のテキストが必要 | | 偽陽性率 | いいえ | 人々がどれだけ頻繁に誤ってフラグ付けされるかを数えるために人間のテキストが必要 | | 精度 | いいえ | 偽陽性と、チェックされている集団におけるAIテキストの一般的な頻度の両方に依存 | | 全体的な精度 | いいえ | 正と負の例、および定義されたクラスバランスが必要 |
1,000件中999件を「99.9%の精度」と呼ぶことは、唯一の誤りがAIを見逃すことであると暗黙のうちに仮定しています。教室、ニュースルーム、または採用ワークフローにおいて、人間を誤ってAIと判定することは、異なる、そしてしばしばより重大な誤りとなります。Astraのみのテストは、それを測定するように設計されていませんでした。
同じGPT-6 Astraテキストが異なるスコアになる理由
検出器の結果は、目の前の文書に左右されます。モデル名だけでは最終的なスコアを予測することはできません。
文章の長さが利用可能な信号量を変える。 20語のメールと1,000語のレポートは同じモデルから生成されたものでも、提供する証拠の量は大きく異なります。短い抜粋の低いスコアは、特に慎重な解釈が必要です。
ジャンルが言語パターンを変える。 Originality.aiのテストでは、会話文に唯一の検出漏れがありました。Pangramの完全AIではない分類には、詩、メール、短い説明などの形式が含まれていました。エッセイに調整された検出器は、対話や創造的な散文に対して異なる振る舞いをする可能性があります。
プロンプトが出力を形成する。 Astraは、トーン、構造、対象読者、例に関する詳細な制約に従うことができます。同じモデルを使用している2人が、非常に異なるリズムと具体性を持つテキストを受け取る可能性があります。
検出器のバージョンと閾値が異なる。 各ツールは、独自のラベル、トレーニングデータ、最小長、および決定閾値を定義しています。あるサービスからのパーセンテージは、別のサービスと一点一点比較できるスコアではありません。
人間の編集がレビュー対象のテキストを変える。 独自の証拠を追加したり、議論を再編成したり、事実を修正したり、個人的な知識に基づいて書き直したりすることで、統計パターンが変わる可能性があります。これは検出を回避するための信頼できる方法を提供するものではなく、ポリシーで義務付けられている場合にAIの使用を開示する必要性をなくすものでもありません。
検出器はGPT-6 Astraが書いたと判断できるか?
いいえ。一般的なテキスト検出器は、文章を生成した正確なモデルを特定しません。クロス検出器比較における5つのツールのいずれもAstraという名前を挙げませんでした。それらはAI、混合、人間、または確率スコアのバリエーションを返しました。
| 質問 | テキスト検出器はそれに答えられるか? |
|---|---|
| この文章はAIライティングに関連するパターンに似ていますか? | 不確実性を伴いますが、推定できます。 |
| 執筆プロセスのある段階でAIが関与していましたか? | 最終テキストだけでは確実に判断できません。 |
| GPT-6 Astraが具体的にこの文章を生成しましたか? | いいえ。スコアは正確なモデルを特定しません。 |
| 誰がプロンプトを入力したか、または出力を編集しましたか? | いいえ。その履歴はテキストの外部にあります。 |
| この文書は学校または職場のポリシーに違反していますか? | いいえ。それにはポリシー、コンテキスト、および人間の判断が必要です。 |
したがって、最も妥当な表現は「この文章はAIライクであるとフラグが立てられた」であり、「検出器がこれをGPT-6 Astraが書いたと証明した」ではありません。
LynoteでGPT-6 Astraテキストをチェックする方法
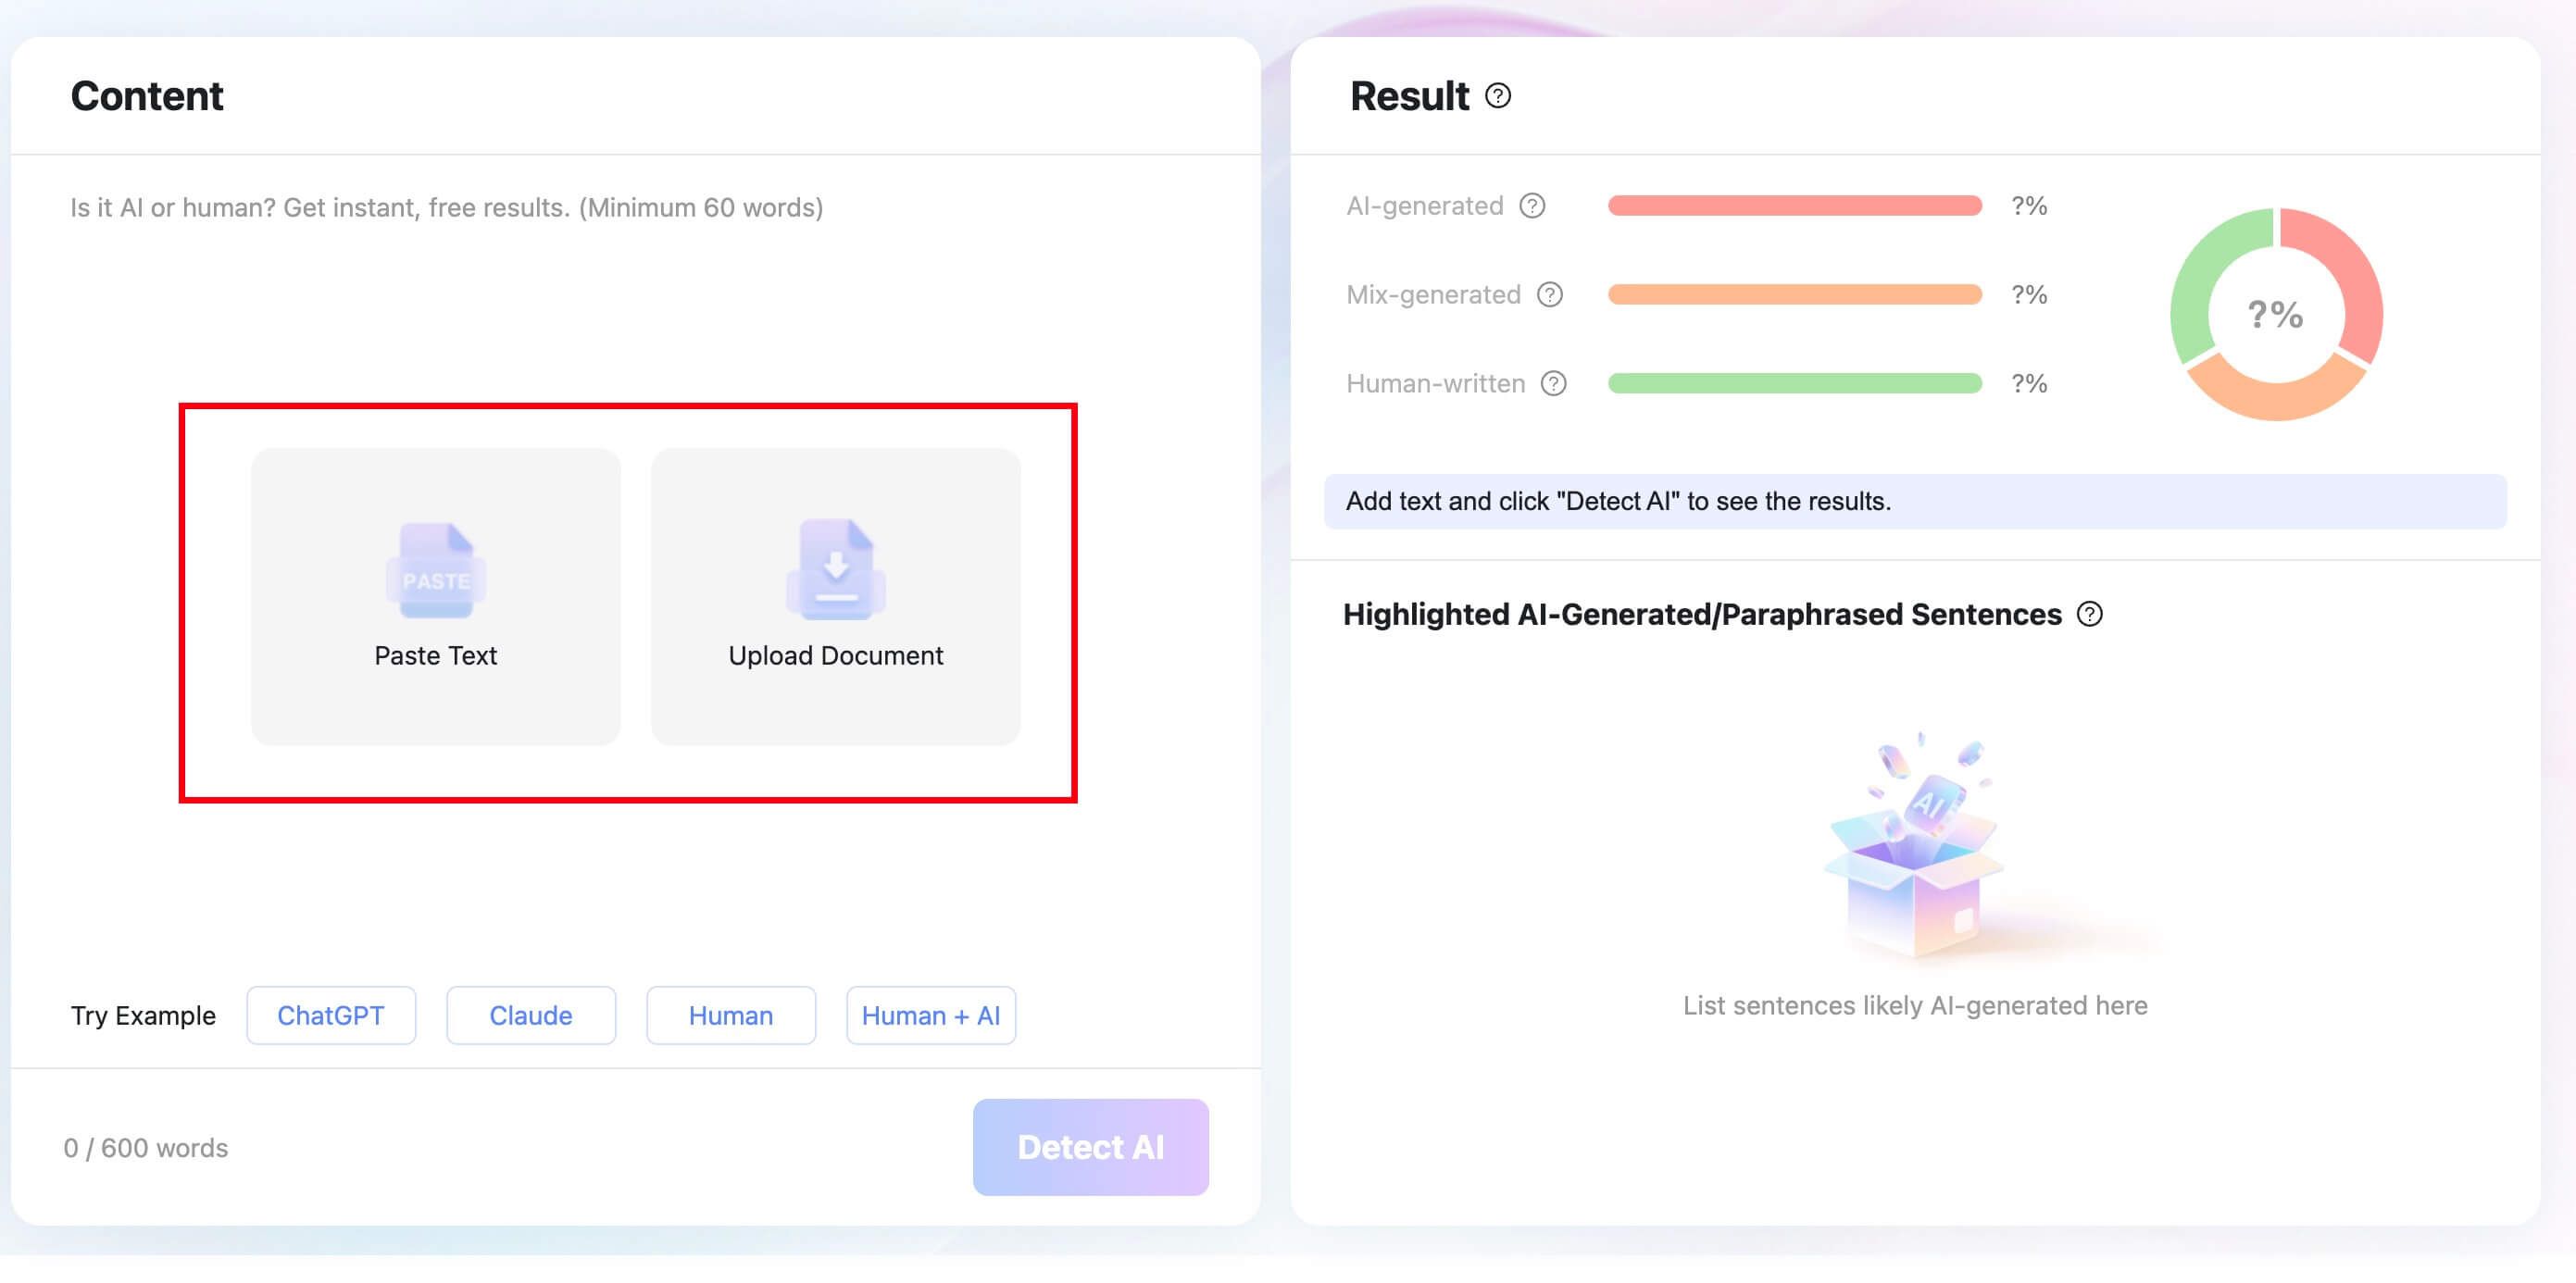
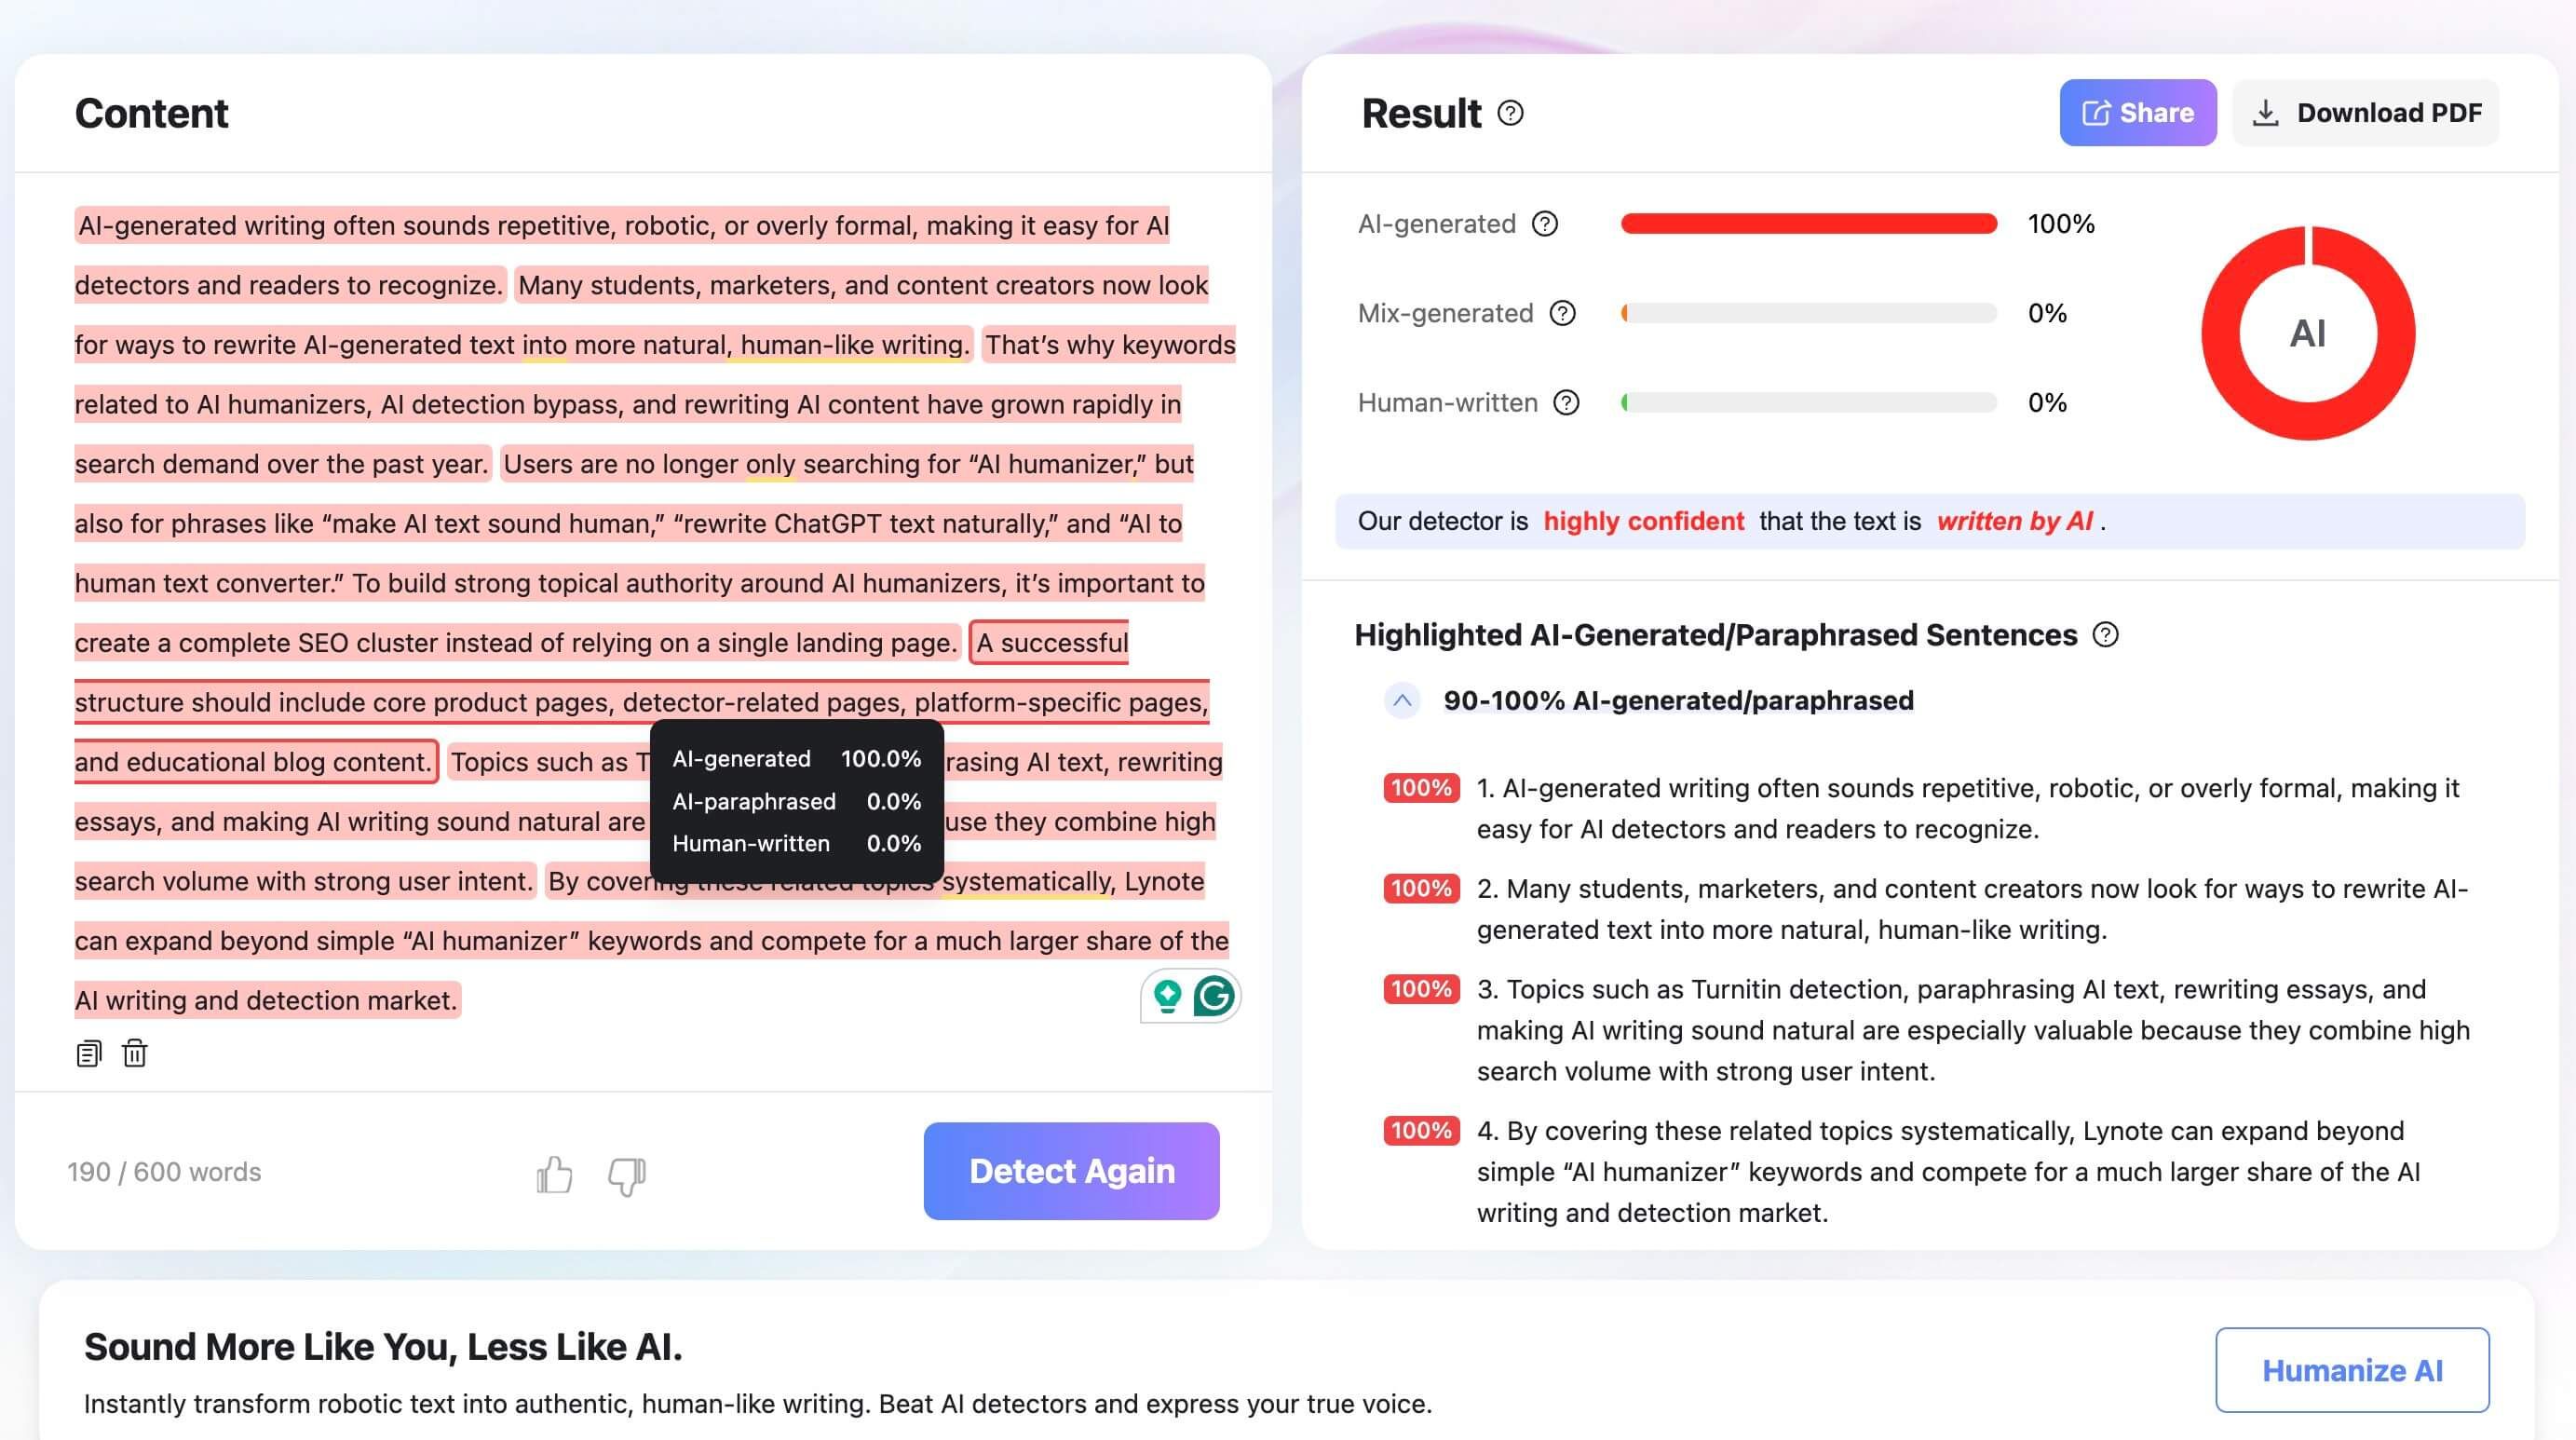
数文から推測するのではなく、完全なドラフトをレビューしたい場合は、Lynote AI検出器がシンプルな初回ワークフローを提供します。結果をAI生成、混合、人間が書いたものとしてパーセンテージに分け、詳細なレビューのために文章をハイライト表示します。
-
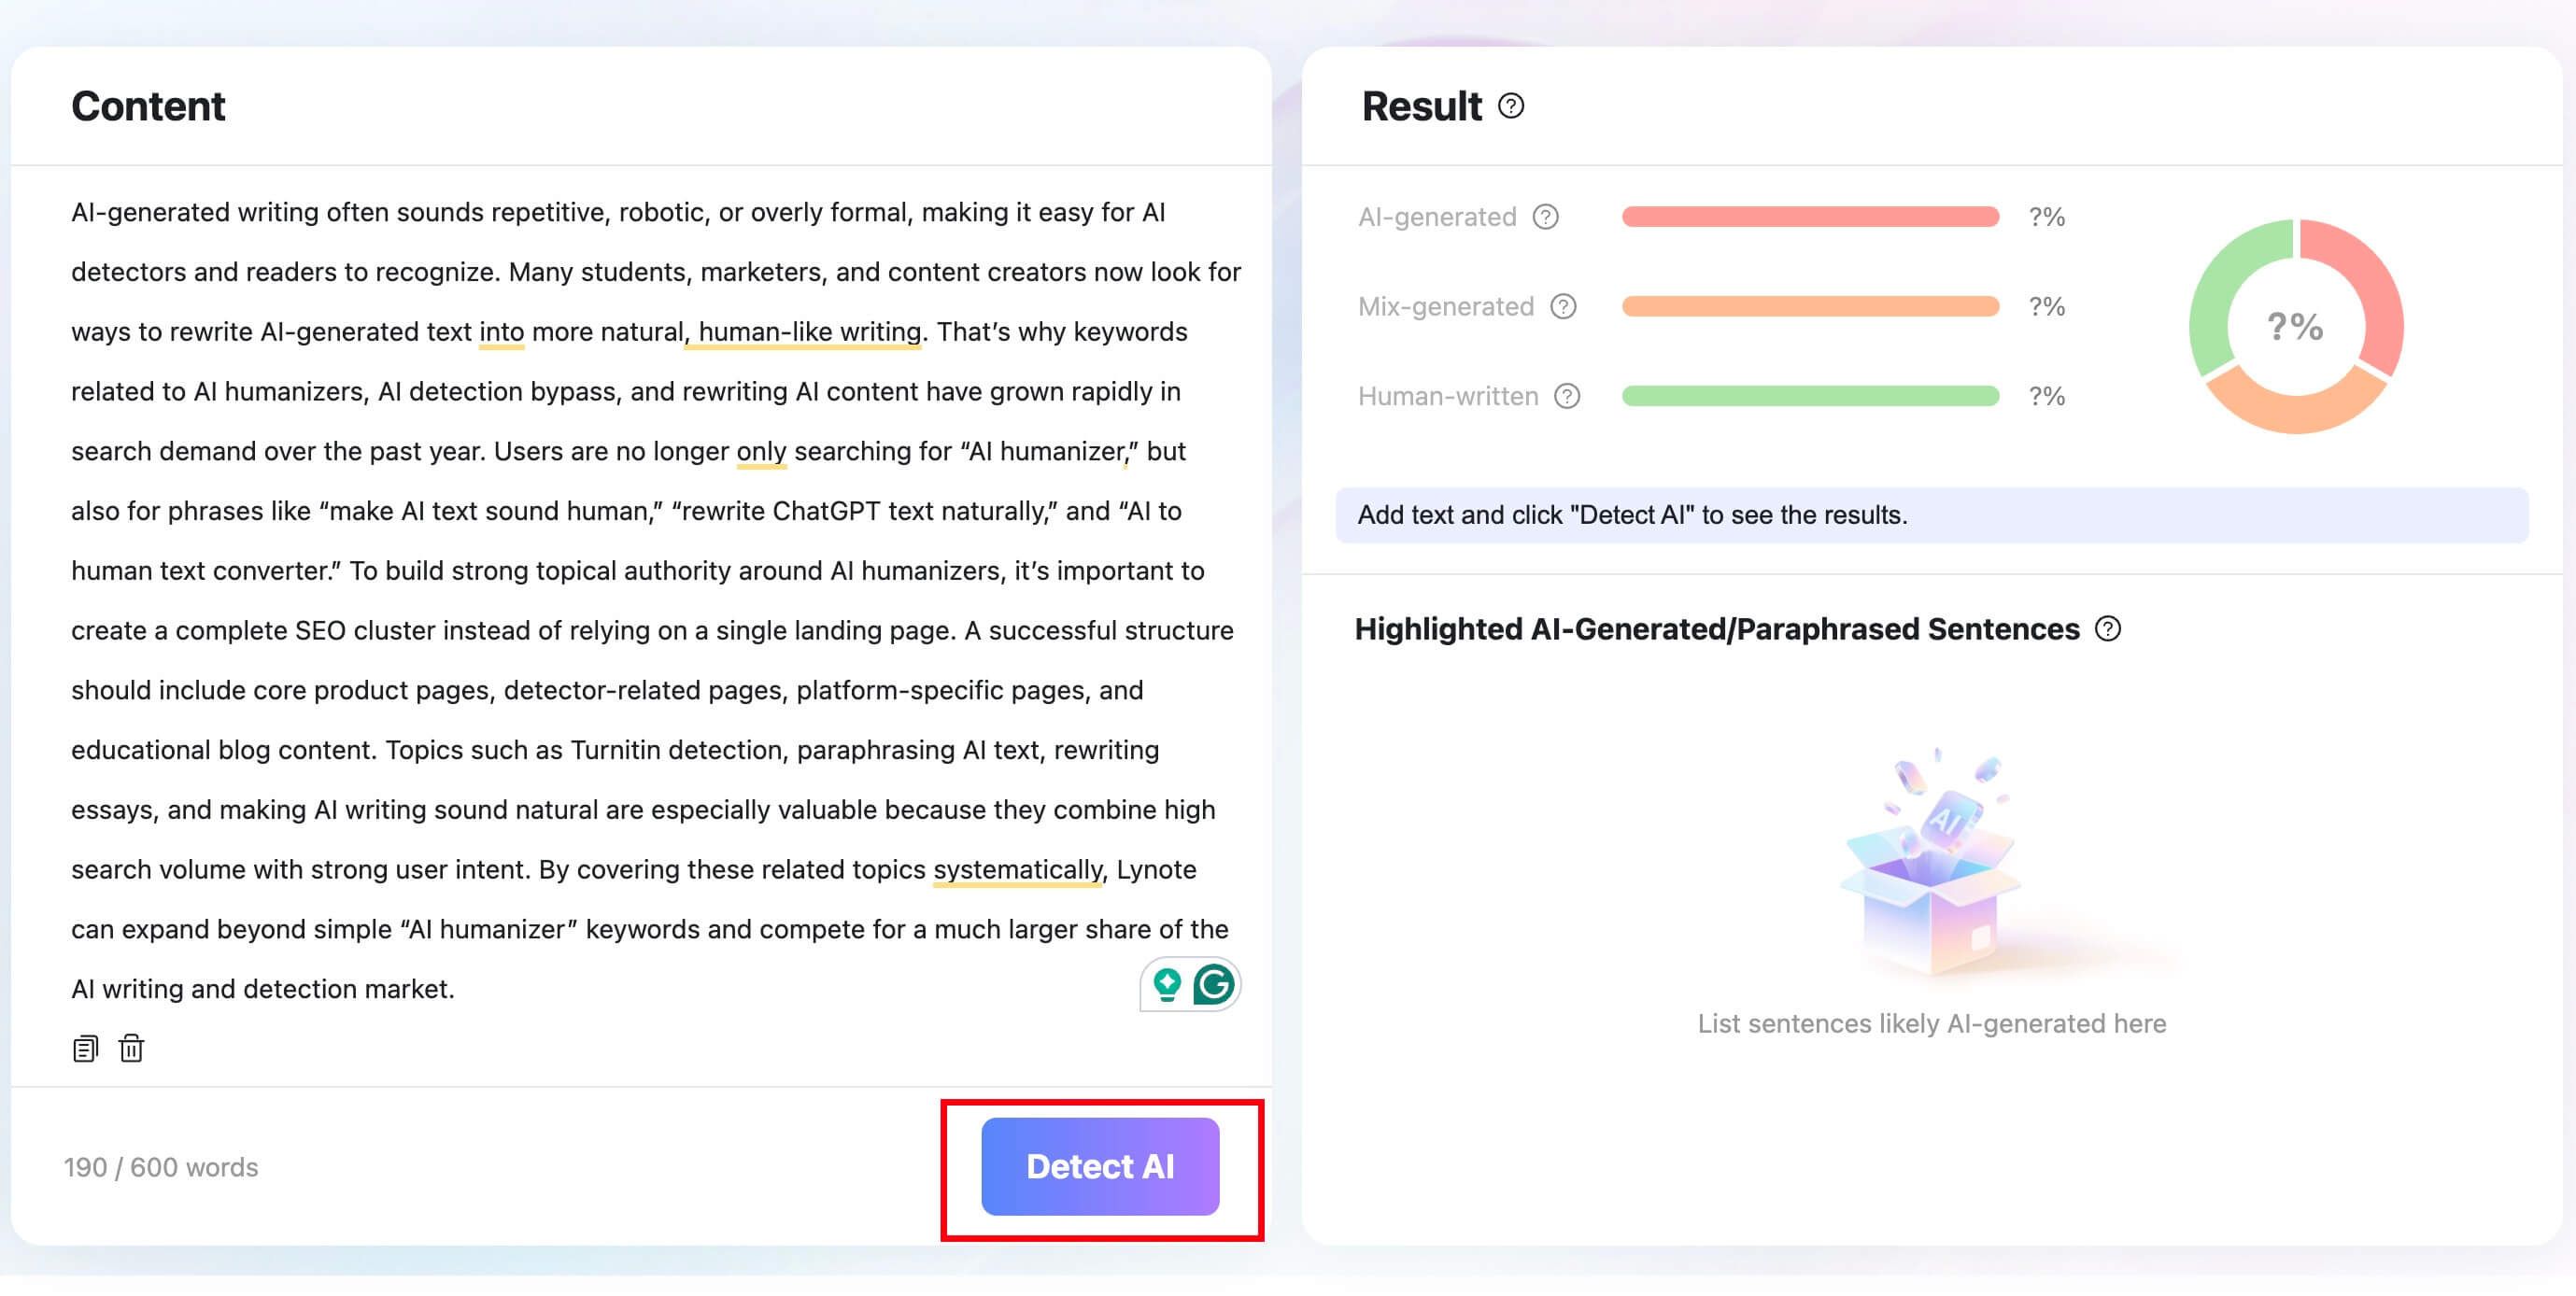
テキストを貼り付けるか、ドキュメントをアップロードする。 テキストボックスを使用して素早くチェックするか、サポートされているDOCX、PDF、またはTXTファイルをアップロードします。可能な場合は、孤立した行ではなく、意味のあるセクションを提出してください。
-
スキャンを実行する。 「AIを検出」をクリックし、ツールが提出されたテキストを分析するのを待ちます。
-
完全な結果をレビューする。 AI、混合、人間のパーセンテージを合わせて読み、最大の数字だけに反応するのではなく、ハイライトされた文章を検査します。
-
検出器外の証拠と信号を比較する。 結論を出す前に、ドラフト、バージョン履歴、引用元、メモ、および執筆者の説明を確認してください。
結果はどこを見るべきかを教えてくれます。しかし、誰が文書を作成したのか、またはAIの使用が許可されていたかどうかは教えてくれません。

AIスコアが高い場合と低い場合の解釈方法
スコアは、次にレビューする内容を変える場合にのみ有用になります。
| スコアが高い場合 | スコアが低い場合 |
|---|---|
| ハイライトされた文章を文脈で読みます。 | その結果を、人が書いたことの証明として扱わないでください。 |
| 主張、引用、例、および声の異常な変化を確認します。 | その文章が安定した結果を得るには短すぎるかどうかを確認します。 |
| 文書を以前のドラフトまたはバージョン履歴と比較します。 | 検出器がAIテキストを見逃す可能性があり、モデルの更新によってパフォーマンスが変わる可能性があることを覚えておいてください。 |
| スコアを評決として提示するのではなく、執筆者にプロセスについて尋ねます。 | 著者またはポリシーの遵守が重要である場合は、他の証拠を使用します。 |
| 重要な決定については、2回目の人間によるレビューを要求します。 | 1回のスキャンで文書を「人間によって検証済み」と宣言することは避けてください。 |
自分の作品をレビューする執筆者にとって、高いスコアはランダムな置換を行ったり、意図的なエラーを追加したりする指示ではありません。より良い対応策は、すべての主張を検証し、一般的な埋め草を具体的な証拠に置き換え、最終的な議論が自分の理解を反映していることを確認することです。
教育者や編集者にとって、検出器はレビューを開始するものであり、完了するものではありません。プロセスに関する証拠は、最終ドラフトに付随する確率よりも多くのことを教えてくれることがよくあります。
偽陽性の問題は依然として重要である
高い既知のAI検出率と偽陽性は同時に存在し得ます。ある検出器は、あるベンチマークでほぼすべてのAstraサンプルを検出する一方で、特定の種類の人間による執筆には依然として苦戦する可能性があります。
スタンフォード大学の研究者たちは以前、広く使用されているGPT検出器が、非ネイティブ英語話者による執筆を頻繁に誤分類する傾向があることを発見しました。より最近の2026年の研究では、プロの英語編集の前後の人間が書いた原稿135,389組を調査しました。13の検出器全体で、報告された偽陽性率は可能な範囲全体にわたっており、同じ編集変更が異なる検出器を逆方向に作用しました。
それは、すべての検出器が無用であるという意味ではありません。それは、スタイルが交絡変数になり得ることを意味します。形式的な言い回し、一貫した文法、限られた語彙、またはプロの編集は、作者が変わらなくてもスコアに影響を与える可能性があります。
Turnitin自身のガイダンスもこの不確実性を反映しています。AIレポートを1つのデータポイントとして説明し、単独で決定的な答えを提供するものではないと述べています。
これは教育以外の分野でも賢明なアドバイスです。成績、仕事、出版の決定、または非難は、1つの不透明なパーセンテージに依存すべきではありません。
GPT-6 Astra AI検出に関するよくある質問
TurnitinはGPT-6 Astraを検出できますか?
Turnitinは、そのシステムがAIと関連付けるパターンと一致する場合、新しい言語モデルによって生成されたテキストにフラグを立てる可能性があります。しかし、この記事でレビューされたAstraに特化したTurnitinの公開ベンチマークは検出率を確立しておらず、Turnitinは、そのレポートを単独で決定的な答えとして使用すべきではないと述べています。
AI検出器はGPT-6 Astraを具体的に特定できますか?
いいえ。現在の検出器の結果は、一般的にテキストがAI生成、混合、または人間らしいかどうかを推定します。Astraを正確なモデルとして確実に特定したり、プロンプトや編集履歴を明らかにしたりすることはありません。
GPT-6 Astraテキストを編集するとスコアは変わりますか?
変わる可能性があります。意味のある人間による編集は、言葉遣い、構造、証拠、声を変えるため、検出器のパターン推定を変化させる可能性があります。その方向性は予測不可能であり、編集はスコアを操作することを目的とするのではなく、正確性と著者の品質を向上させるべきです。
検出器にはどれくらいのテキストが必要ですか?
要件はツールによって異なります。あるAstraの実験では、同じ文章の検出率が25語で40中9から50語で40中29に、そして100語では40すべてに上昇しました。この結果は1つの検出器に属するものですが、完全な文章が1つの文よりも情報量が多い理由を示しています。
最高のAIスコアはAstraがテキストを書いたことの証明ですか?
いいえ。それは、そのモデルとスケールにおける検出器の最も強力な分類です。どのAIモデルが使用されたか、誰が使用したか、または人が文書を実質的に編集したかどうかを証明するものではありません。
人間が書いた文章がGPT-6コンテンツとしてフラグ付けされることはありますか?
人間が書いた文章がAIライクなスコアを受け取ることはあります。特に検出器が起源ではなくスタイルに反応する場合です。非ネイティブ英語の文章、高度に標準化された学術散文、およびプロによって編集されたテキストは、研究によって一貫性のない偽陽性が記録されているため、特に注意が必要です。
低いスコアは人間がテキストを書いたことの証明ですか?
いいえ。低いスコアは、検出器がそのしきい値を超えるのに十分なAI関連の証拠を見つけられなかったことを意味します。短い文章、珍しいジャンル、および編集されたAI出力はすべて、検出の信頼性を低下させる可能性があります。
最終的な評決
GPT-6 Astraは、これまでに利用可能な最も強力な公開テストで検出可能です。Originality.aiは1,000件の既知のAstra出力のうち999件にフラグを立て、Pangramは986件の対象出力のうち982件をAIとして完全に分類し、5つの異なる検出器が1つの未編集のAstraエッセイで一致しました。
これらの結果は、限定的な結論を裏付けています。現在の検出器は、未編集の長文Astra散文を多くの場合認識できます。しかし、すべての検出器が同じくらい信頼できること、短いテキストや編集されたテキストが同じように振る舞うこと、またはスコアが作者を証明することを示すものではありません。
AI検出をトリアージとして使用してください。ツールに十分なテキストを与え、ハイライトされた文章を読み、その後、分類器が見ることができない証拠(ドラフト、情報源、文脈、執筆履歴、そして作品の背後にいる人物)を確認してください。
著者:Danny
プロダクトマーケティングマネージャー
ダニーが、Lynoteの機能が日常の生産性から製品の成長を促すライティングのユースケースまで、実際のワークフローにどのように適合するかを説明します。 すべての記事を見る →