
如何從掃描的 PDF 中提取文字:3 種實用方法

您有一個掃描的 PDF 檔案——可能是課堂講義、已簽署的合約或舊手冊——而您需要複製其中一段文字。您將游標拖曳到文字上,卻毫無反應。整個頁面只會以一個頑固的單一影像被反白。這是一個令人沮喪的常見問題,但文字並未遺失,它只是被鎖住了。
掃描的 PDF 本質上是文件的照片。您的電腦看到的是像素,而不是文字,這就是為什麼您無法選取、複製或搜尋文字的原因。要解鎖它,您需要一個稱為光學字元辨識 (OCR) 的程序。OCR 技術會掃描影像,識別字母和數字的形狀,並將它們轉換為機器可讀、可編輯的文字。本指南將引導您了解三種可靠的方法,使用 OCR 從掃描文件中提取文字,從快速的線上工具到專業級軟體。
快速評估:從掃描的 PDF 提取文字的最佳方法
對於時間緊迫的人來說,這是結論。選擇正確的方法完全取決於您對速度、準確性和隱私的需求。
| 方法 | 最適合 | 準確度 (1-5) | 一般費用 |
|---|---|---|---|
| 線上 OCR 工具 | 快速、一次性提取簡單文件(例如,幾頁筆記)。 | 3.5 | 免費(有使用限制) |
| Adobe Acrobat Pro | 需要高準確度和版面忠實度的專業人士,適用於商業文件。 | 4.5 | 訂閱(約每月 20 美元) |
| 專用 OCR 軟體 | 大量、歸檔或複雜的批次處理,具有最大控制權。 | 5.0 | 高額一次性費用(100 美元以上) |
分數是根據典型表現的編輯經驗法則,而非測量基準。結果會因文件品質而異。
結論: 對於大多數偶爾需要從掃描文件中提取文字的學生、研究人員和辦公室工作者來說,免費的線上 OCR 工具是最有效的起點。如果您每天處理敏感文件或需要像素級精確的格式,那麼投資 Adobe Acrobat Pro 是值得的。
了解來源:掃描式 PDF 與原生 PDF
在我們深入探討「如何」之前,讓我們先釐清「為何」。並非所有 PDF 都生而平等。您感受到的挫折來自於兩種基本類型之間的差異:原生 PDF 和掃描式 PDF。
- 原生 PDF: 這些通常是從數位來源建立的,例如從 Microsoft Word 文件或 Google 文件匯出。它們具有內建的文字層。字元由資料而非像素定義。您可以像在任何其他文字文件中一樣選取、複製、搜尋和編輯文字。
- 掃描式 PDF: 這些是透過實體掃描器或智慧型手機相機應用程式產生的。每個頁面都是一個平面影像檔案(例如 JPEG 或 TIFF),包裝在 PDF 容器中。沒有文字層,只有文字的圖片。
您如何判斷自己擁有哪一種? 測試很簡單:打開 PDF 並嘗試用游標反白單一句子。如果您可以精確選取文字,那麼您擁有的是原生 PDF。如果您的游標在整個區塊或整個頁面上畫出一個大的藍色方框,那麼您擁有的是掃描的、基於影像的 PDF。這就是 OCR 成為您必備工具的地方。
方法 1:使用免費線上 OCR 工具進行快速轉換
對於絕大多數任務——例如從掃描的學術文章中擷取引文或將列印的發票數位化——免費的線上工具是從 A 到 B 最快的途徑。這些基於網路的轉換器無需安裝軟體,可以在幾秒鐘內將您的影像式 PDF 轉換為可用的文字。
優點顯而易見:它們免費、可從任何瀏覽器存取,而且速度驚人。然而,人們經常忽略的是權衡。免費服務可能對檔案大小或每天可處理的頁數有限制。更重要的是,您正在將文件上傳到第三方伺服器,這可能不適用於機密或敏感資訊。
不過,對於非敏感資料,它們的便利性無與倫比。一個很好的現代範例是 PDF 文字提取工具,它使用 AI 驅動的引擎提供清晰的文字提取,無需註冊即可進行基本使用。
以下是典型的工作流程:
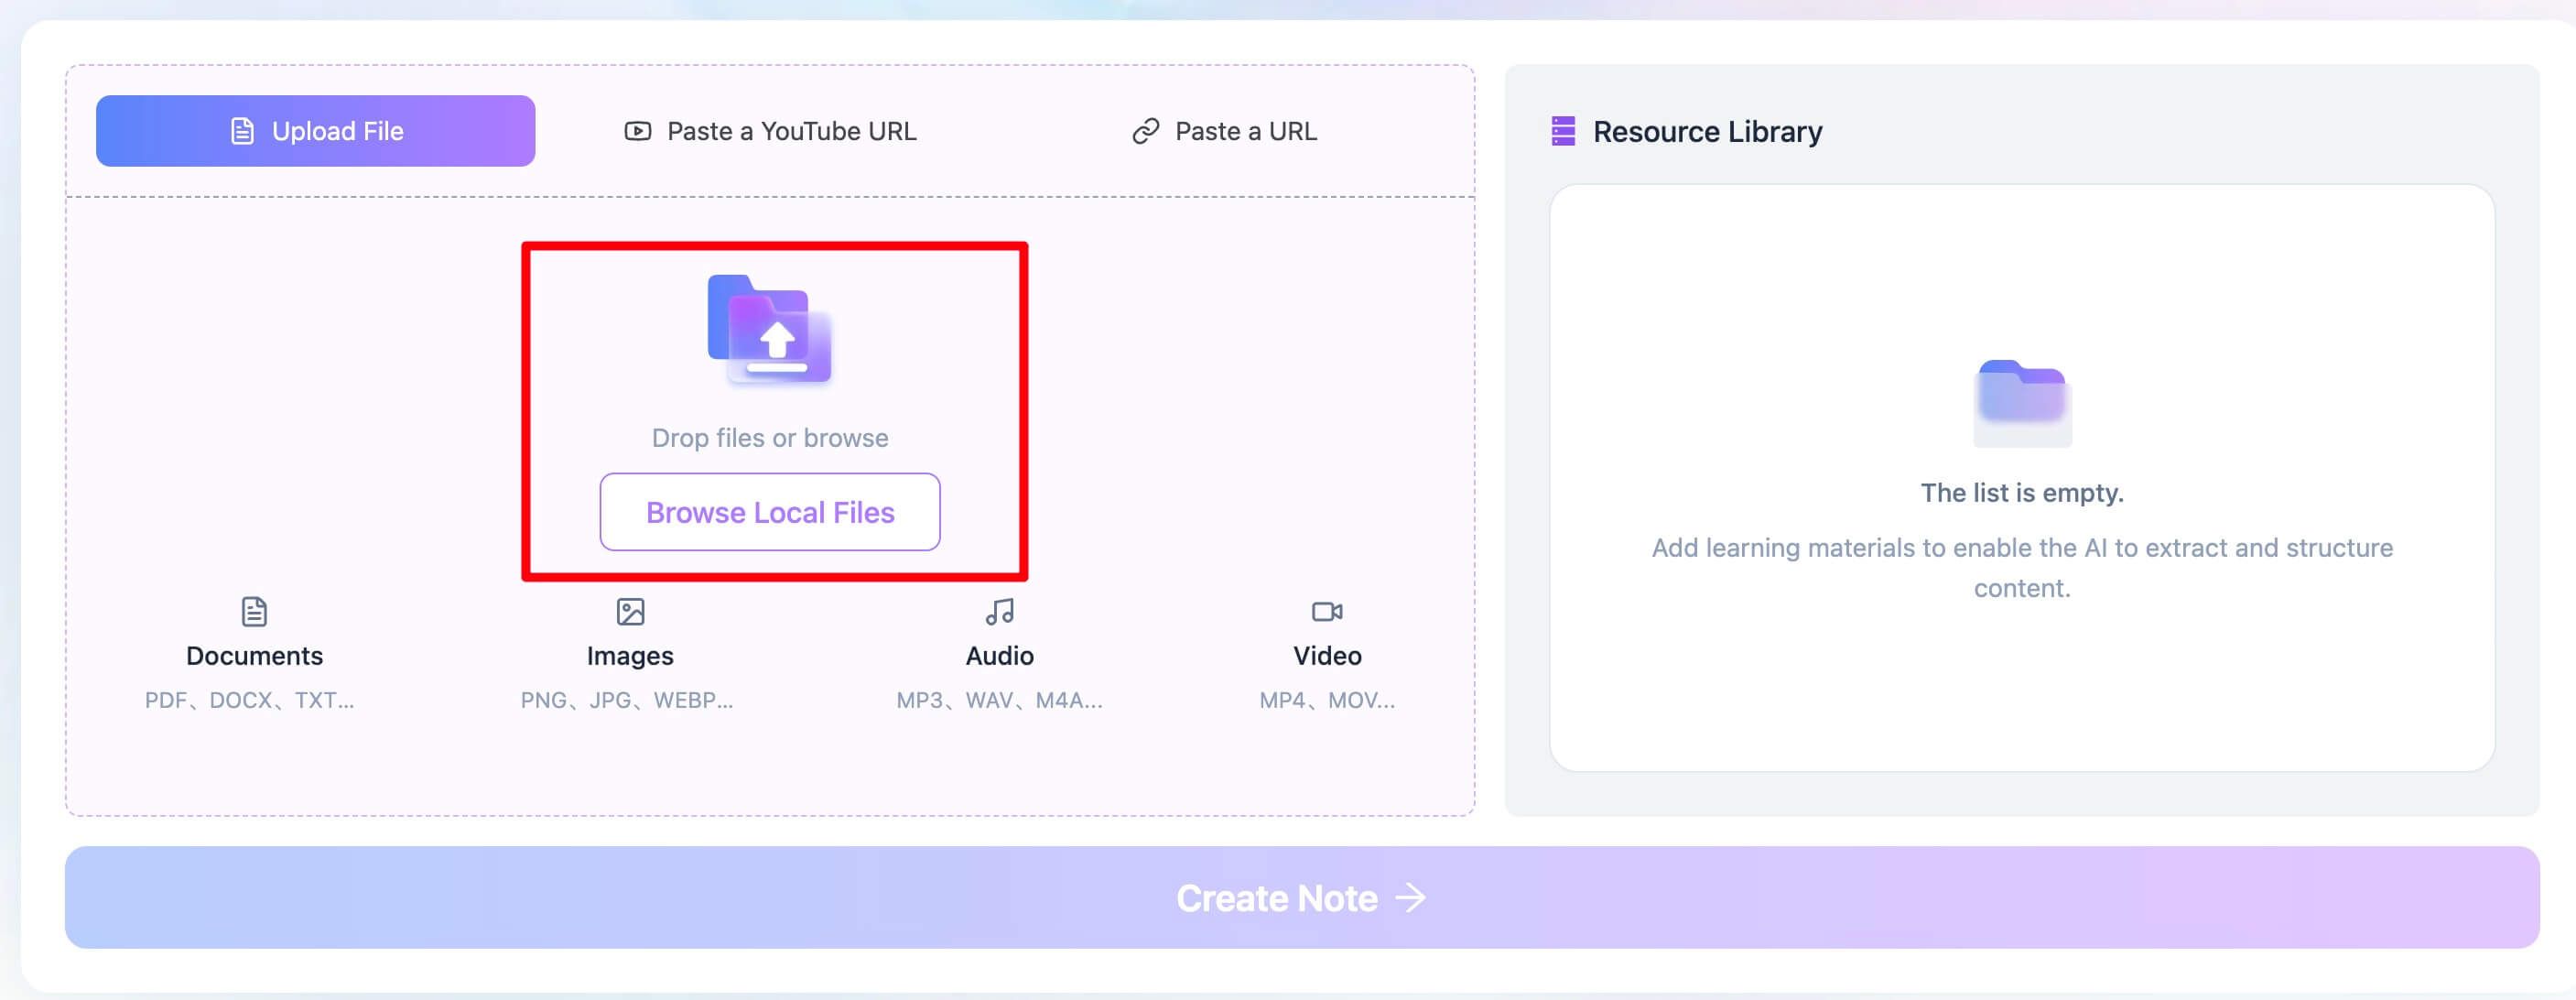
- 上傳您的掃描 PDF。 導航到 Lynote 工作區。您會看到幾個輸入選項,但對於本地檔案,請選擇 「上傳檔案」 標籤。您可以將掃描的 PDF 直接拖曳到頁面上,或點擊「瀏覽本地檔案」從您的電腦中選擇它。
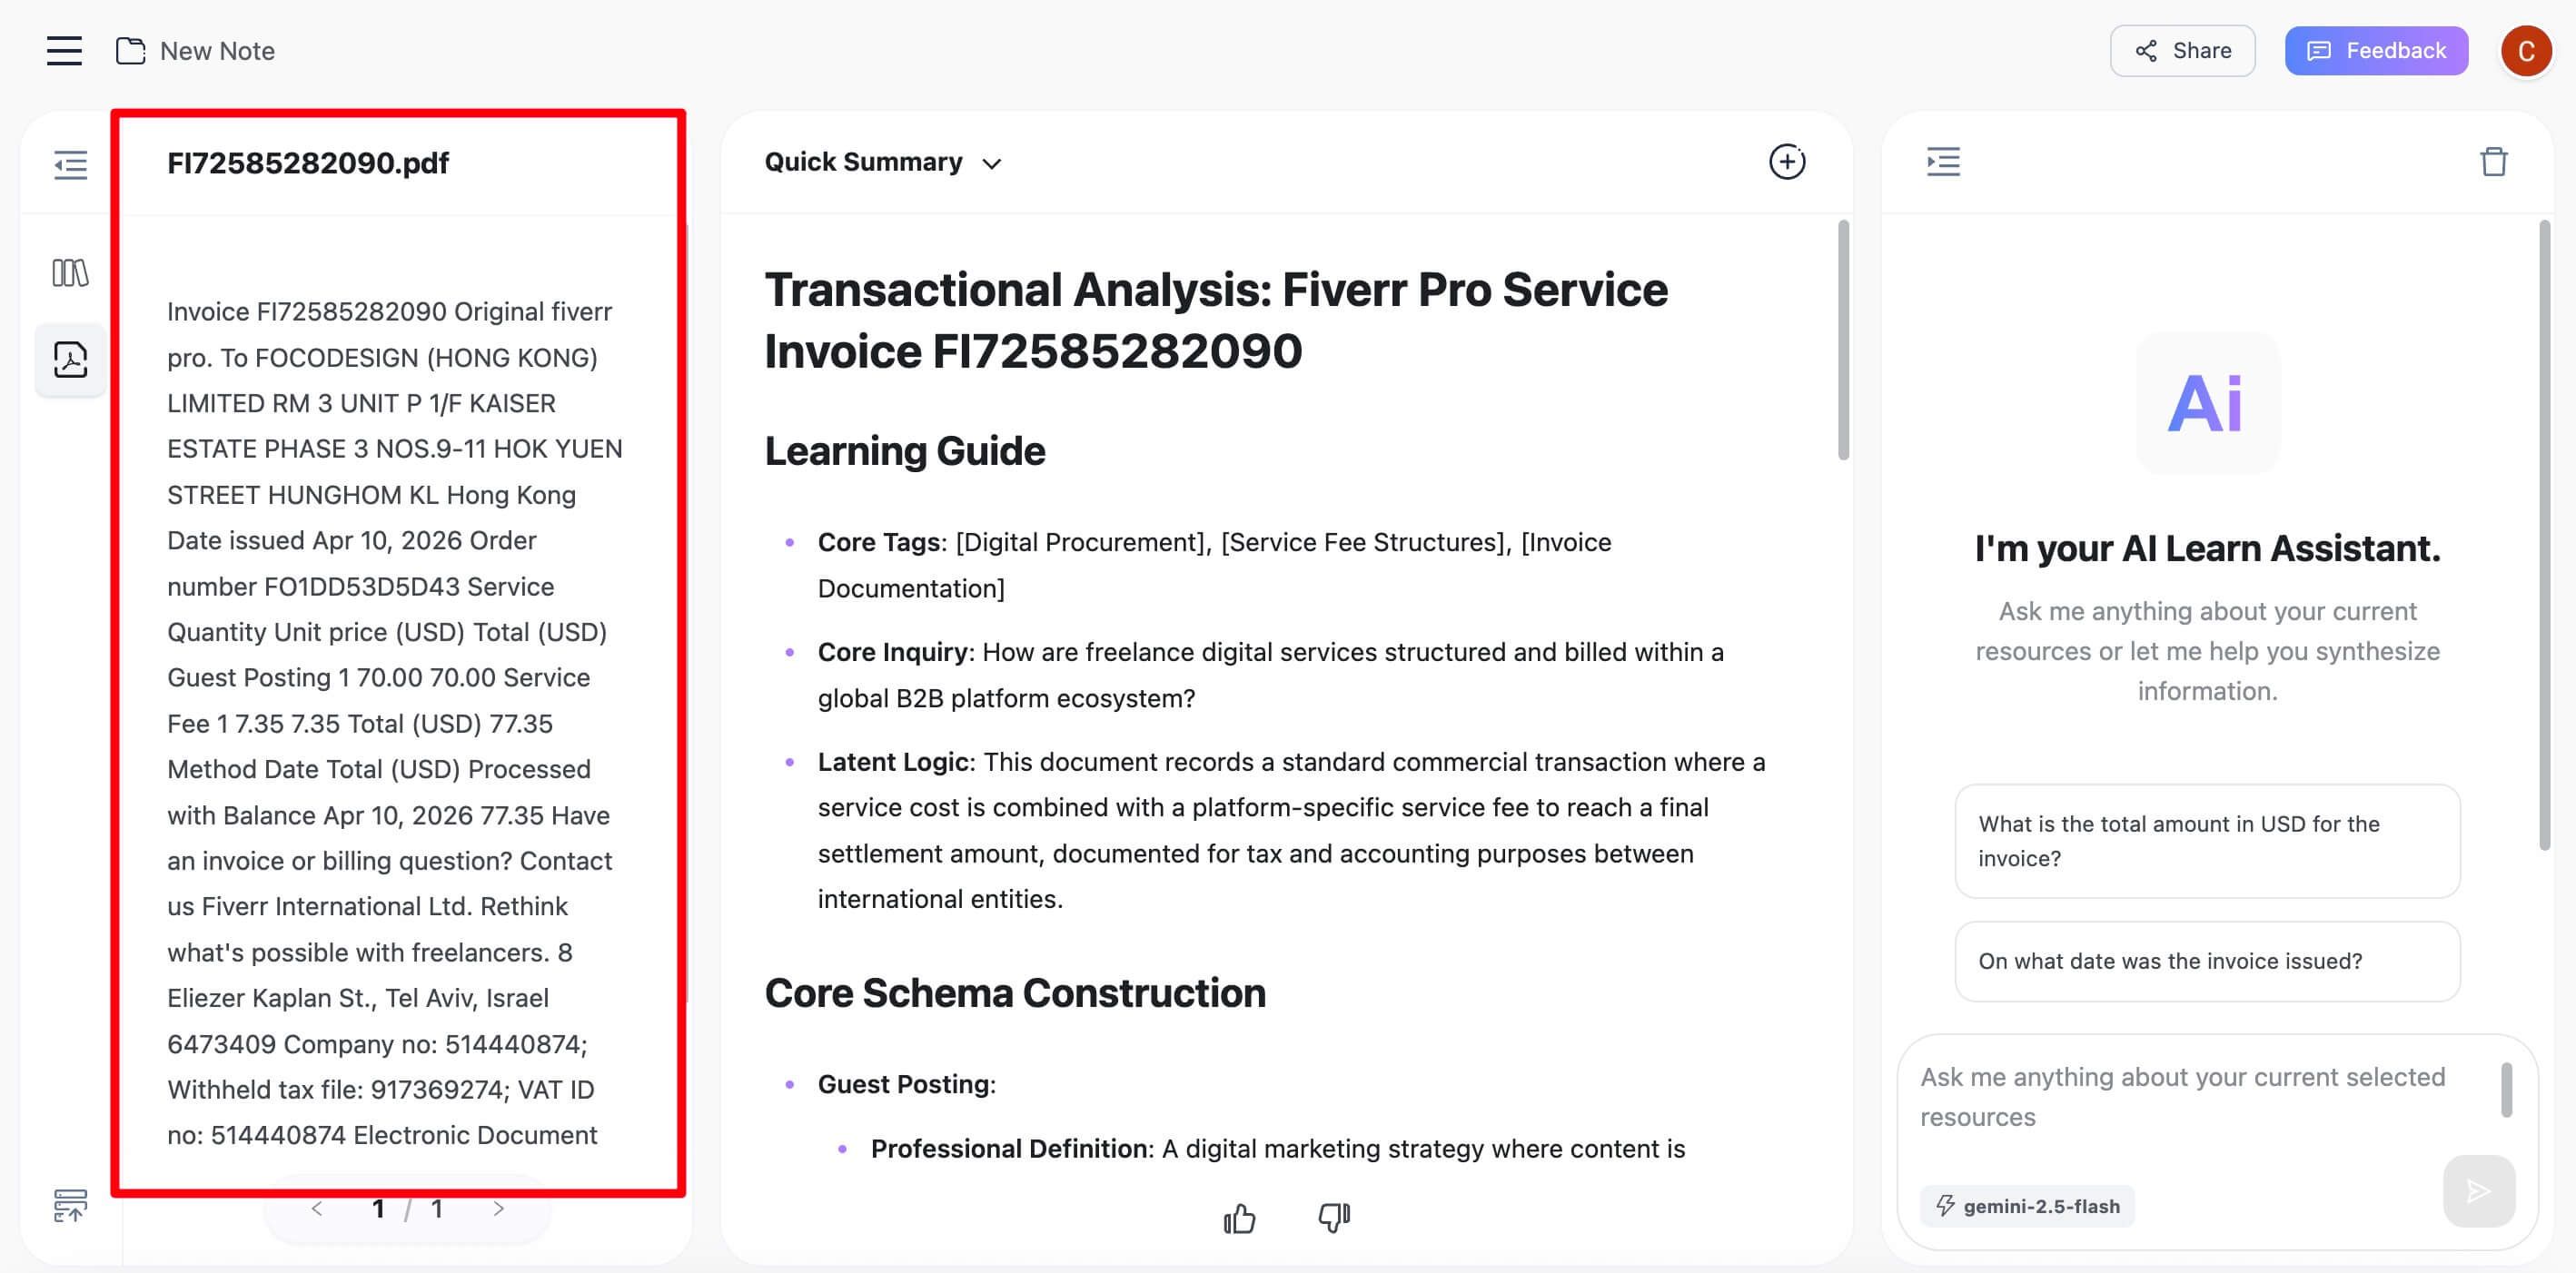
- 從 PDF 提取文字。 檔案載入後,只需點擊 「建立筆記」 按鈕。此操作會將文件發送到 AI 引擎,該引擎會立即開始 OCR 處理。它會分析每個頁面的影像,識別字元(支援超過 130 種語言),並將內容重建為數位文字。
- 審閱並匯出文字。 幾秒鐘內,提取的文字將顯示在主編輯器面板的左側。您可以選取所有文字並將其複製到剪貼簿。您還可以查看 PDF 摘要 或詢問有關它的任何問題。
我曾經遇到一個典型的學生困境:歷史研討會指定了一份 30 頁的掃描閱讀材料,而期末論文隔天就要交。我記得教授提到過一位特定的歷史學家,但我記不起在密密麻麻的文字中是哪裡。我沒有花一個小時恐慌地快速瀏覽,而是將 PDF 丟進一個線上 OCR 工具。不到一分鐘,我就得到了一份可搜尋的文件。快速按下 Ctrl+F 搜尋那位歷史學家的名字,直接把我帶到了我需要的三個關鍵頁面。這件小事完全拯救了我的夜晚。

方法 2:使用 Adobe Acrobat Pro 的內建 OCR
如果您是專業處理 PDF 的人士,您很可能可以使用 Adobe Acrobat Pro。它之所以成為業界標準是有原因的,其內建的 OCR 功能既強大又可靠。當您不僅需要原始文字,還希望盡可能保留文件原始版面、字體和格式時,此方法是理想之選。
與許多只會傾倒文字的線上工具不同,Acrobat 會建立一個「可搜尋的影像」PDF。這表示它會保留原始掃描影像,但在其上方新增一個不可見、可選取的文字層。文件看起來一模一樣,但現在它完全可搜尋,您可以從中複製貼上。
您可能會想,這值得付費嗎?如果您已經有 Creative Cloud 訂閱,那當然是值得的。如果沒有,對於偶爾使用來說,每月費用會很高。
開始之前:
- 您必須擁有 Adobe Acrobat Pro 的付費訂閱(免費的 Adobe Reader 不包含 OCR)。
- 為獲得最佳結果,請確保您的掃描 PDF 清晰且至少為 300 DPI。
如何在 Acrobat Pro 中辨識文字:
- 在 Adobe Acrobat Pro 應用程式中開啟您的掃描 PDF。
- 導航到 「工具」 中心。您可以在頂部工具列或右側窗格中找到它。
- 選擇 「增強掃描」 工具。這將多個用於改進掃描文件的功能組合在一起。
- 在出現的「增強掃描」工具列中,點擊 「辨識文字」。一個小下拉選單將會出現。選擇 「在此檔案中」。
- 一個設定對話框將會彈出。對於大多數用途,預設設定即可。您可以指定文件的語言以提高準確性。點擊 「辨識文字」 開始處理。
Acrobat 現在將處理每個頁面。對於長文件,這可能需要幾分鐘。完成後,請再次嘗試選取文字。您會發現現在可以像處理原生 PDF 一樣反白、複製和搜尋文件了。
Adobe Acrobat Pro 之所以能比免費線上工具更好地保留版面,主要原因在於其先進的文件分析引擎,該引擎旨在重建複雜的表格和欄位,而不僅僅是提取原始文字流。
方法 3:適用於大量需求 — 專用 OCR 軟體
當您從處理一份文件轉變為將整個檔案櫃數位化時,您就需要升級到專用 OCR 軟體。像 ABBYY FineReader 或 Kofax OmniPage 這樣的工具是文字提取領域的重型機械。
對於一般使用者來說,這種方法可能過於繁瑣。但對於律師事務所、學術研究人員或推動無紙化辦公的企業來說,這是一項必要的投資。以下是這些平台的獨特之處:
- 批次處理: 您可以一次將數百個掃描的 PDF 檔案輸入軟體,讓它徹夜運行,然後將所有檔案匯出為您想要的格式。
- 進階版面辨識: 這些工具擅長理解複雜的版面。它們可以智慧地識別頁首、頁尾、欄位、表格和圖像,並將它們忠實地重建為可編輯的格式,例如 Word 文件。
- 整合與自動化: 許多專用 OCR 程式都可以自動化。例如,您可以設定一個「監控資料夾」,任何新掃描的檔案放入其中後,都會自動轉換並儲存到另一個位置。
- 最高準確度: 雖然線上工具和 Acrobat 表現出色,但專用軟體通常具有更精細的控制功能,可以改善對低品質掃描的辨識,使其在具挑戰性的情況下更具優勢。
說實話,您會知道自己是否需要這個。如果您的工作流程涉及每週轉換超過 10-20 份掃描文件,或者您正在處理非常舊、損壞或複雜的文件,那麼試用專用 OCR 工具是值得的下一步。
提取文字時的常見問題(以及如何解決)
OCR 技術感覺像魔法,但它也可能失敗。當您得到亂碼文字或混亂的版面時,問題通常屬於以下類別之一。
- 問題:來源掃描品質不佳。
- 原因: OCR 需要清晰、明確的字母形狀才能運作。模糊、歪斜或低解析度(低於 200 DPI)的掃描就像要求一個人在黑暗的房間裡閱讀一樣。您會得到很多「我認為它寫著...」的結果。
- 解決方案: 如果可能,以更高的解析度(300 DPI 是黃金標準)重新掃描文件。確保頁面平放在掃描儀上並正確對齊。良好的輸入是獲得良好輸出的最大單一因素。
- 問題:版面複雜(表格、欄位、文字方塊)。
- 原因: 基本的 OCR 是從左到右、從上到下閱讀。當它遇到兩欄的學術論文時,它可能會先讀第一欄的第一行,然後是第二欄的第一行,依此類推,將所有內容混雜成無意義的文字。
- 解決方案: 這正是 Acrobat 或專用軟體等專業工具的優勢所在。它們具有「區域 OCR」功能,可以識別這些文字區塊並以正確的順序處理它們。對於免費工具,最好的辦法是提取原始文字並準備手動重新格式化。
- 問題:文字包含手寫、印章或不尋常的字體。
- 原因: 大多數 OCR 引擎都經過標準印刷字體的訓練。它們難以處理手寫的多變性,而段落上的一個大紅色「PAID」印章可能會完全遮蓋下面的文字。
- 解決方案: 對於手寫文字,您需要專門的 ICR(智慧字元辨識)軟體,這完全是另一回事。對於蓋章文件,事後除了手動修正之外,通常沒有簡單的解決方法。務必仔細校對輸出,尤其是在非標準元素周圍。
常見問題
OCR 文字提取的準確度如何?
現代 AI 驅動的 OCR 準確度極高,對於高品質的打字文件,通常可超過 99%。然而,準確度會因掃描品質不佳、複雜版面或不尋常字體而下降。對於關鍵文件,您應始終預留時間進行快速的人工校對。
為什麼提取文字後,我的格式和字體會改變?
這是一個關鍵點。OCR 提取的是 內容(字元),但它必須 重建 格式。這個過程並非完美的複製;它是一種重建。新文件使用標準系統字體(如 Arial 或 Calibri),而不是原始影像中的確切字體。這可能導致文字重新排版,改變分頁符號和間距,特別是如果原始文件使用了複雜的版面。
我可以在沒有任何軟體的情況下從掃描的 PDF 提取文字嗎?
不行。從本質上講,從影像中提取文字 需要 OCR 軟體。選擇在於您是使用基於網路的軟體(線上工具)、您安裝的桌面軟體(如 Acrobat),還是手機上的應用程式。沒有任何形式的 OCR 程式在某處運行,就無法完成這項工作。
免費從掃描的 PDF 提取文字的最佳方法是什麼?
對於大多數使用者來說,像 Lynote 的 AI 轉錄 這樣信譽良好的線上 OCR 工具是最佳的免費選擇。它在準確性、速度和易用性之間取得了平衡,無需安裝軟體或為標準任務支付訂閱費用。但對於敏感文件,請務必注意隱私。
最終評估與編輯推薦
選擇如何從掃描的 PDF 提取文字,並非要找到單一的「最佳」工具,而是要找到適合您特定任務的正確工具。
- 如果您需要對非敏感文件進行快速、一次性轉換,請從免費線上 OCR 工具開始。
- 如果您經常處理專業文件並需要可靠的格式,Adobe Acrobat Pro 是您的主力工具。
- 如果您的工作涉及數位化檔案或大量掃描,請投資專用 OCR 軟體。
編輯推薦: 對於絕大多數偶爾遇到此問題的學生、學者和行政專業人員來說,像 Lynote 這樣的現代線上工具是最實用的選擇。它達到了完美的平衡:可立即免費使用,由高度準確的 AI 引擎驅動,且無需安裝。雖然桌面軟體為複雜的法律或財務文件提供了更多版面控制,但對於使掃描文件可搜尋且內容可存取的日常任務,Lynote 可以在幾秒鐘內提供結果。