

Да, контент GPT-6 Astra обнаруживается в текущих опубликованных тестах. Два крупных исследования поставщиков выявили более 99% неотредактированных, известных образцов ИИ, которые они оценили, а меньшее сравнение показало, что пять различных детекторов отметили одно и то же эссе Astra. Это убедительное доказательство того, что отшлифованный контент Astra не становится автоматически невидимым для детекторов ИИ.
Это не доказательство того, что каждый детектор обнаружит каждый фрагмент текста Astra. Что более важно, высокий балл не может сказать вам, кто написал документ, какая модель его создала и использовал ли человек ИИ вообще. Важно не просто спросить: «Может ли ИИ обнаружить GPT-6 Astra?», а понять, что именно измеряют имеющиеся данные и что остается невыясненным.
Краткий ответ: Обнаруживается ли контент GPT-6 Astra?
Для неотредактированной английской прозы разумной длины ответ чаще всего положительный. Самые сильные публичные результаты, доступные в октябре 2026 года, указывают в том же направлении, хотя они получены от компаний-разработчиков детекторов ИИ и используют разные образцы, пороги и правила включения.
| Опубликованный тест | Материал Astra, протестированный | Сообщенный результат | Что он устанавливает | Что он не устанавливает |
|---|---|---|---|---|
| Originality.ai | 1000 известных ответов Astra в пяти категориях письма | 999 пересекли порог ИИ | Очень высокая степень обнаружения этого известного образца ИИ при одной настройке детектора | Частота ложных срабатываний или эффективность при анализе текстов, написанных человеком |
| Pangram | 986 оцененных ответов Astra из отфильтрованных запросов | 982 ИИ, 3 смешанных, 1 человек | Очень высокая частота полной классификации ИИ для подходящих отрывков | Производительность ниже минимального порога в 50 слов или на контрольных образцах, написанных человеком |
| Сравнение пяти детекторов | Одно эссе Astra на 300 слов | 5 из 5 инструментов отметили его; четыре показали максимальный балл ИИ | Несколько детекторов согласились по этому конкретному эссе | Общая точность модели на основе одного образца документа |
| Эксперимент с длиной отрывка | 40 текстов Astra, показанных в четырех длинах | 9/40 обнаружено при 25 словах, 29/40 при 50, и 40/40 при 100 и 200 | Длина может существенно изменить результат одного детектора | Универсальная минимальная длина для каждого детектора |
Практический вывод прост: полная статья Astra с большей вероятностью даст значимый сигнал детектора, чем предложение, скопированное из нее. Даже тогда «отмечено» означает, что текст соответствовал шаблонам, которые детектор связывает с ИИ. Это не означает, что инструмент восстановил скрытую метку GPT-6.
Что меняет GPT-6 Astra — и что не меняет
OpenAI позиционирует GPT-6 Astra как свою наиболее мощную модель для сложных рассуждений, исследований, кодирования, использования компьютеров и создания документов. Она создана для следования подробным инструкциям и выполнения сложной работы, что позволяет создавать черновики, которые более связны и полезны, чем стереотипные ответы чат-ботов.
Собственная документация модели также отмечает тенденцию к детальному форматированию и повторяющимся фразам, если пользователь не указывает другой стиль письма. Это наблюдение помогает объяснить, почему улучшенная функциональность и обнаруживаемость могут сосуществовать. Документ может быть точным, хорошо организованным и беглым, но при этом демонстрировать закономерности, которые замечает статистический классификатор.
Именно здесь люди часто делают неверный вывод. Лучшая проза не обязательно выглядит более человечной для детектора, потому что детекторы не оценивают прозу на предмет интеллекта или полезности. Они оценивают, похожи ли ее языковые паттерны на материал в их обучающих данных ИИ и человека.
И неуклюжий текст не является автоматически написанным ИИ. Люди тоже повторяют переходы, используют шаблонные структуры эссе и пишут общие предложения. Детектор считывает паттерны, а не намерение, авторство или историю за курсором.
Что показали опубликованные тесты обнаружения GPT-6 Astra
Основные исследования выглядят удивительно последовательными. Однако их методы отвечают на более узкие вопросы, чем иногда предполагают заголовки.
Originality.ai: 999 из 1000 ответов пересекли порог
Originality.ai сгенерировал и просканировал 1000 английских ответов Astra: 200 блогов, 200 разговорных текстов, 200 пояснительных ответов, 200 новостных ответов и 200 обзоров. Он считал оценку не менее 0,50 в режиме AI Allowance 15% как обнаруженную.
Все образцы блогов, пояснительных текстов, новостей и обзоров пересекли этот порог. Разговорная категория вернула 199 обнаружений из 200, что составило 999 из 1000 в целом. Единственный результат ниже порога был разговорным текстом.
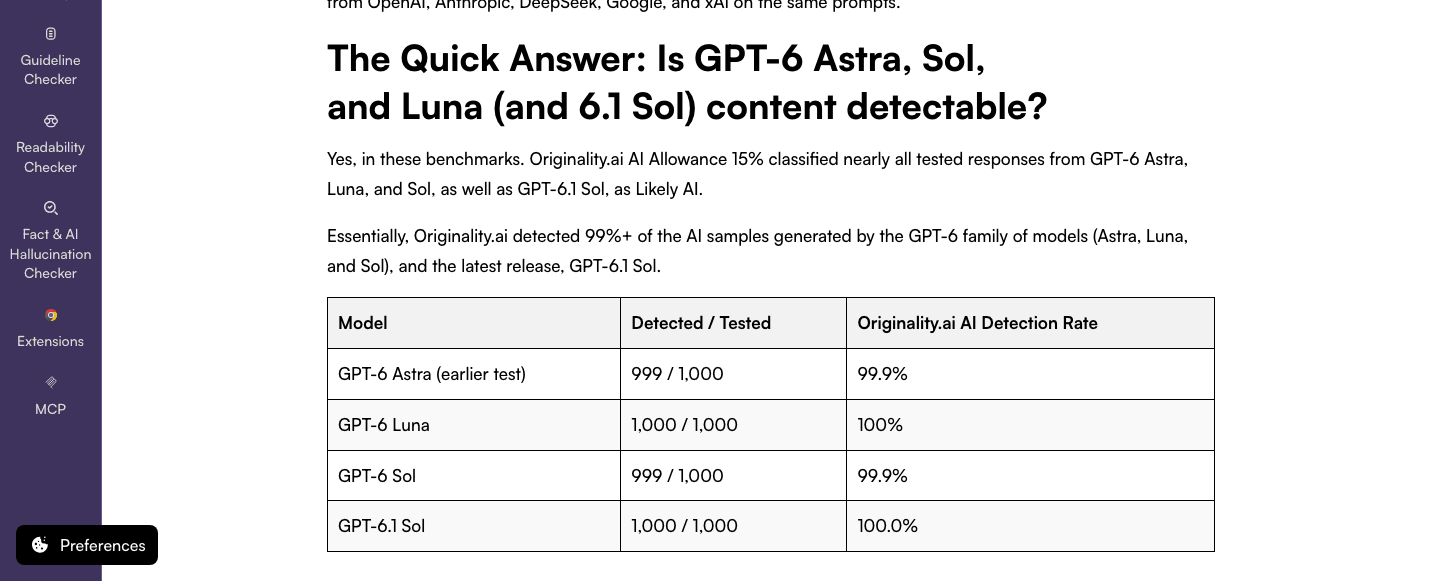
Это сильный результат обнаружения известного ИИ для этого детектора и настройки. Это не полное исследование точности, потому что не было сопоставимой коллекции текстов, написанных человеком. Без человеческих негативов исследование не может показать, как часто тот же детектор может ошибочно пометить человека.
Pangram: Четыре результата не были полностью классифицированы как ИИ
Pangram начал с 1032 ответов Astra на отфильтрованные запросы Chatbot Arena первого хода. Он не оценил 46 ответов, содержащих менее 50 слов, оставив 986 подходящих отрывков.
Среди них 982 были классифицированы как ИИ, три как смешанные и один как человеческий. Результаты, не относящиеся к ИИ, включали короткие или творческие форматы, такие как электронное письмо, объяснение и стихотворение. Эта деталь важна, потому что пропуски не были равномерно распределены по однородному набору длинных эссе.
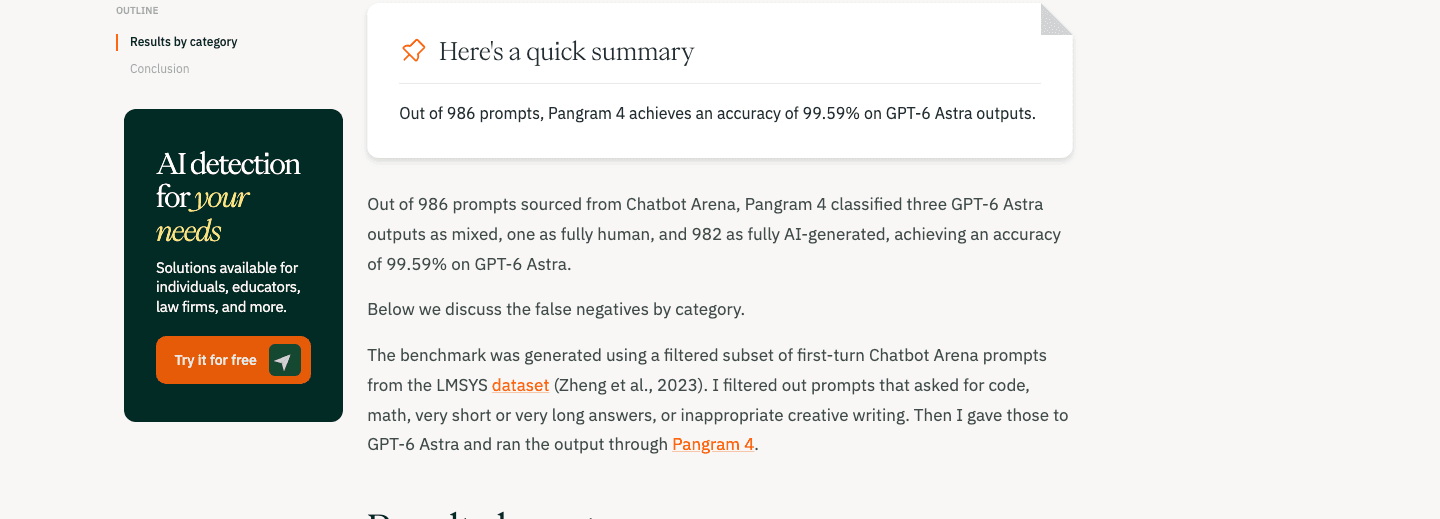
Исследование подтверждает высокую частоту обнаружения текста Astra, который соответствовал требованиям Pangram по длине. Оно не сообщает нам, как были бы оценены исключенные короткие ответы, и снова не содержит контрольной группы текстов, написанных человеком, для оценки ложных срабатываний.
Пять детекторов согласились в отношении одного эссе Astra
Меньшее исследование взяло одно эссе Astra на 300 слов и просканировало его с помощью Phrasly, GPTZero, Pangram, Copyleaks и QuillBot. Каждый инструмент отметил эссе. Четыре вернули свой максимальный отображаемый балл ИИ, в то время как QuillBot вернул 82% ИИ.
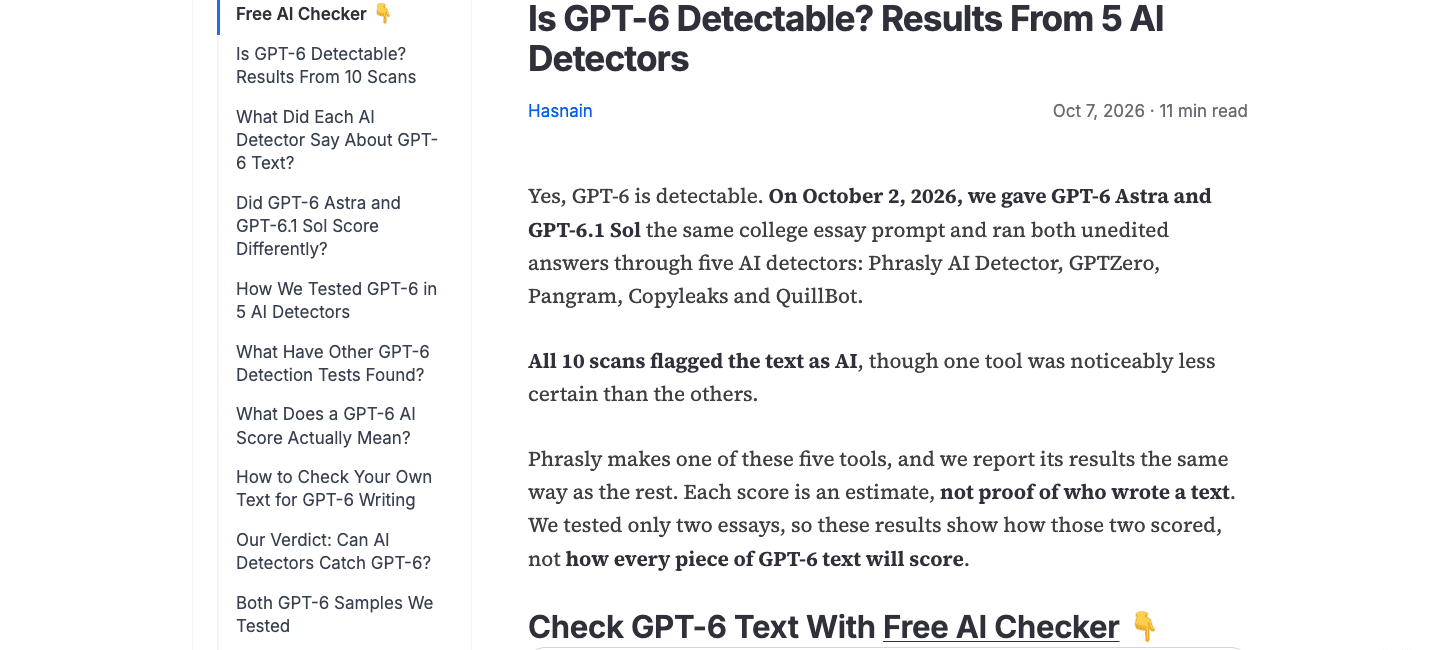
Это сравнение полезно, потому что оно сохраняет текст постоянным, изменяя детектор. Оно показывает, что согласие между инструментами возможно, но также показывает, что их проценты не взаимозаменяемы. Оценка 82% и максимальная оценка могут привести к одной и той же практической метке, но при этом исходить из разных моделей и шкал.
Одно эссе не может установить производительность пяти детекторов для блогов, электронных писем, технических отчетов и отредактированных черновиков. Это моментальный снимок между инструментами, а не рейтинг.
Тот же текст стало труднее обнаружить, когда он был сокращен
Самым показательным результатом может быть самое маленькое исследование. Исследователи взяли 40 известных отрывков Astra и показали одному и тому же детектору первые 25, 50, 100 или 200 слов каждого отрывка. Изменилось только количество видимого текста.
При 25 словах было обнаружено 9 из 40 отрывков. При 50 словах было обнаружено 29 из 40. При 100 и 200 словах все 40 пересекли порог.
Это не устанавливает универсальное правило 100 слов. Оно показывает, почему проверка изолированного предложения может привести к ложному успокоению: может быть недостаточно языка для детектора, чтобы найти стабильный паттерн.
Наш повторный анализ: 99,9% обнаружения — это не 99,9% точности в реальном мире
Опубликованные данные позволяют провести полезный независимый расчет. Результат выборки является оценкой, поэтому мы пересчитали приблизительные 95% доверительные интервалы Уилсона вместо того, чтобы рассматривать каждый процент как точный.
| Опубликованное количество | Наблюдаемая частота | Приблизительный 95% интервал | Осторожная интерпретация |
|---|---|---|---|
| Originality.ai: 999/1000 | 99,90% | 99,44%-99,98% | Высокая частота обнаружения известных образцов Astra при указанной настройке |
| Originality.ai разговорный: 199/200 | 99,50% | 97,22%-99,91% | Сильный результат, но менее точный, поскольку выборка категории меньше |
| Pangram полностью ИИ: 982/986 | 99,59% | 98.96%-99.84% | Высокая частота полной классификации ИИ среди подходящих оцененных результатов |
Эти интервалы подтверждают вывод о том, что заявленные показатели обнаружения известного ИИ были высокими. Они не заполняют недостающую половину эксперимента.
Чтобы измерить детектор в реальном мире, нам нужны как документы ИИ, так и человеческие документы. Это единственный способ увидеть, обнаруживает ли инструмент ИИ, не приводя к чрезмерному количеству ложных срабатываний для человеческого текста.
| Метрика | Могут ли исследования только Astra рассчитать ее? | Почему это важно | | --- | --- | --- | --- | | Частота обнаружения известного текста ИИ | Да | Показывает, как часто инструмент улавливает предоставленные ему образцы ИИ | | Частота ложноотрицательных результатов | Да | Показывает, сколько известных образцов ИИ было пропущено в соответствии с правилами теста | | Специфичность | Нет | Требует человеческого текста для измерения того, как часто человеческая работа корректно определяется как человеческая | | Частота ложноположительных результатов | Нет | Требует человеческого текста для подсчета того, как часто люди ошибочно помечаются | | Точность | Нет | Зависит как от ложноположительных результатов, так и от того, насколько распространен текст, сгенерированный ИИ, в проверяемой популяции | | Общая точность | Нет | Требует как положительных, так и отрицательных примеров, а также определенного баланса классов |
Называя 999 из 1000 «точностью 99,9%», мы неявно предполагаем, что единственная возможная ошибка — это пропуск ИИ. В классе, редакции или рабочем процессе найма ложное помечание человека является другой и часто более серьезной ошибкой. Тесты только Astra не были разработаны для ее измерения.
Почему один и тот же текст GPT-6 Astra может получать разные оценки
Результаты детекторов чувствительны к документу, который они анализируют. Одно только название модели не может предсказать окончательную оценку.
Длина отрывка изменяет доступный сигнал. Электронное письмо из 20 слов и отчет из 1000 слов могут быть созданы одной и той же моделью, но предлагать очень разные объемы доказательств. Низкие оценки коротких отрывков заслуживают особенно осторожной интерпретации.
Жанр изменяет языковой паттерн. В тесте Originality.ai разговорный текст содержал единственную ошибку. Классификации Pangram, не относящиеся к полностью ИИ, включали такие форматы, как стихотворение, электронное письмо и короткое объяснение. Детектор, откалиброванный на эссе, может вести себя по-разному при анализе диалогов или творческой прозы.
Запрос формирует вывод. Astra может следовать подробным ограничениям относительно тона, структуры, аудитории и примеров. Два человека, использующие одну и ту же модель, могут получить текст с очень разным ритмом и спецификой.
Версии и пороги детекторов различаются. Каждый инструмент определяет свои собственные метки, обучающие данные, минимальную длину и порог принятия решения. Процент от одной службы — это не оценка, которую можно сравнивать один к одному с другой.
Редактирование человеком изменяет проверяемый текст. Добавление оригинальных доказательств, реорганизация аргумента, исправление фактов и переписывание на основе личных знаний могут изменить статистический паттерн. Это не дает надежного рецепта для избегания обнаружения и не отменяет необходимости раскрывать использование ИИ, когда это требуется политикой.
Может ли детектор определить, что это написал GPT-6 Astra?
Нет. Типичный текстовый детектор не идентифицирует точную модель, которая создала отрывок. Ни один из пяти инструментов в кросс-детекторном сравнении не назвал Astra; они вернули варианты ИИ, смешанный, человеческий или вероятностный балл.
| Вопрос | Может ли текстовый детектор ответить на него? | | --- | --- | --- | | Похож ли этот отрывок на паттерны, связанные с написанием ИИ? | Он может оценить это с некоторой неопределенностью. | | Был ли ИИ задействован где-либо в процессе написания? | Ненадежно только по окончательному тексту. | | Создал ли GPT-6 Astra именно этот отрывок? | Нет. Оценка не идентифицирует точную модель. | | Кто ввел запрос или отредактировал вывод? | Нет. Эта история находится за пределами текста. | | Нарушает ли документ политику школы или рабочего места? | Нет. Для этого требуется политика, контекст и человеческое суждение. |
Поэтому наиболее обоснованная формулировка — «отрывок был помечен как похожий на ИИ», а не «детектор доказал, что это было написано GPT-6 Astra».
Как проверить текст GPT-6 Astra с помощью Lynote
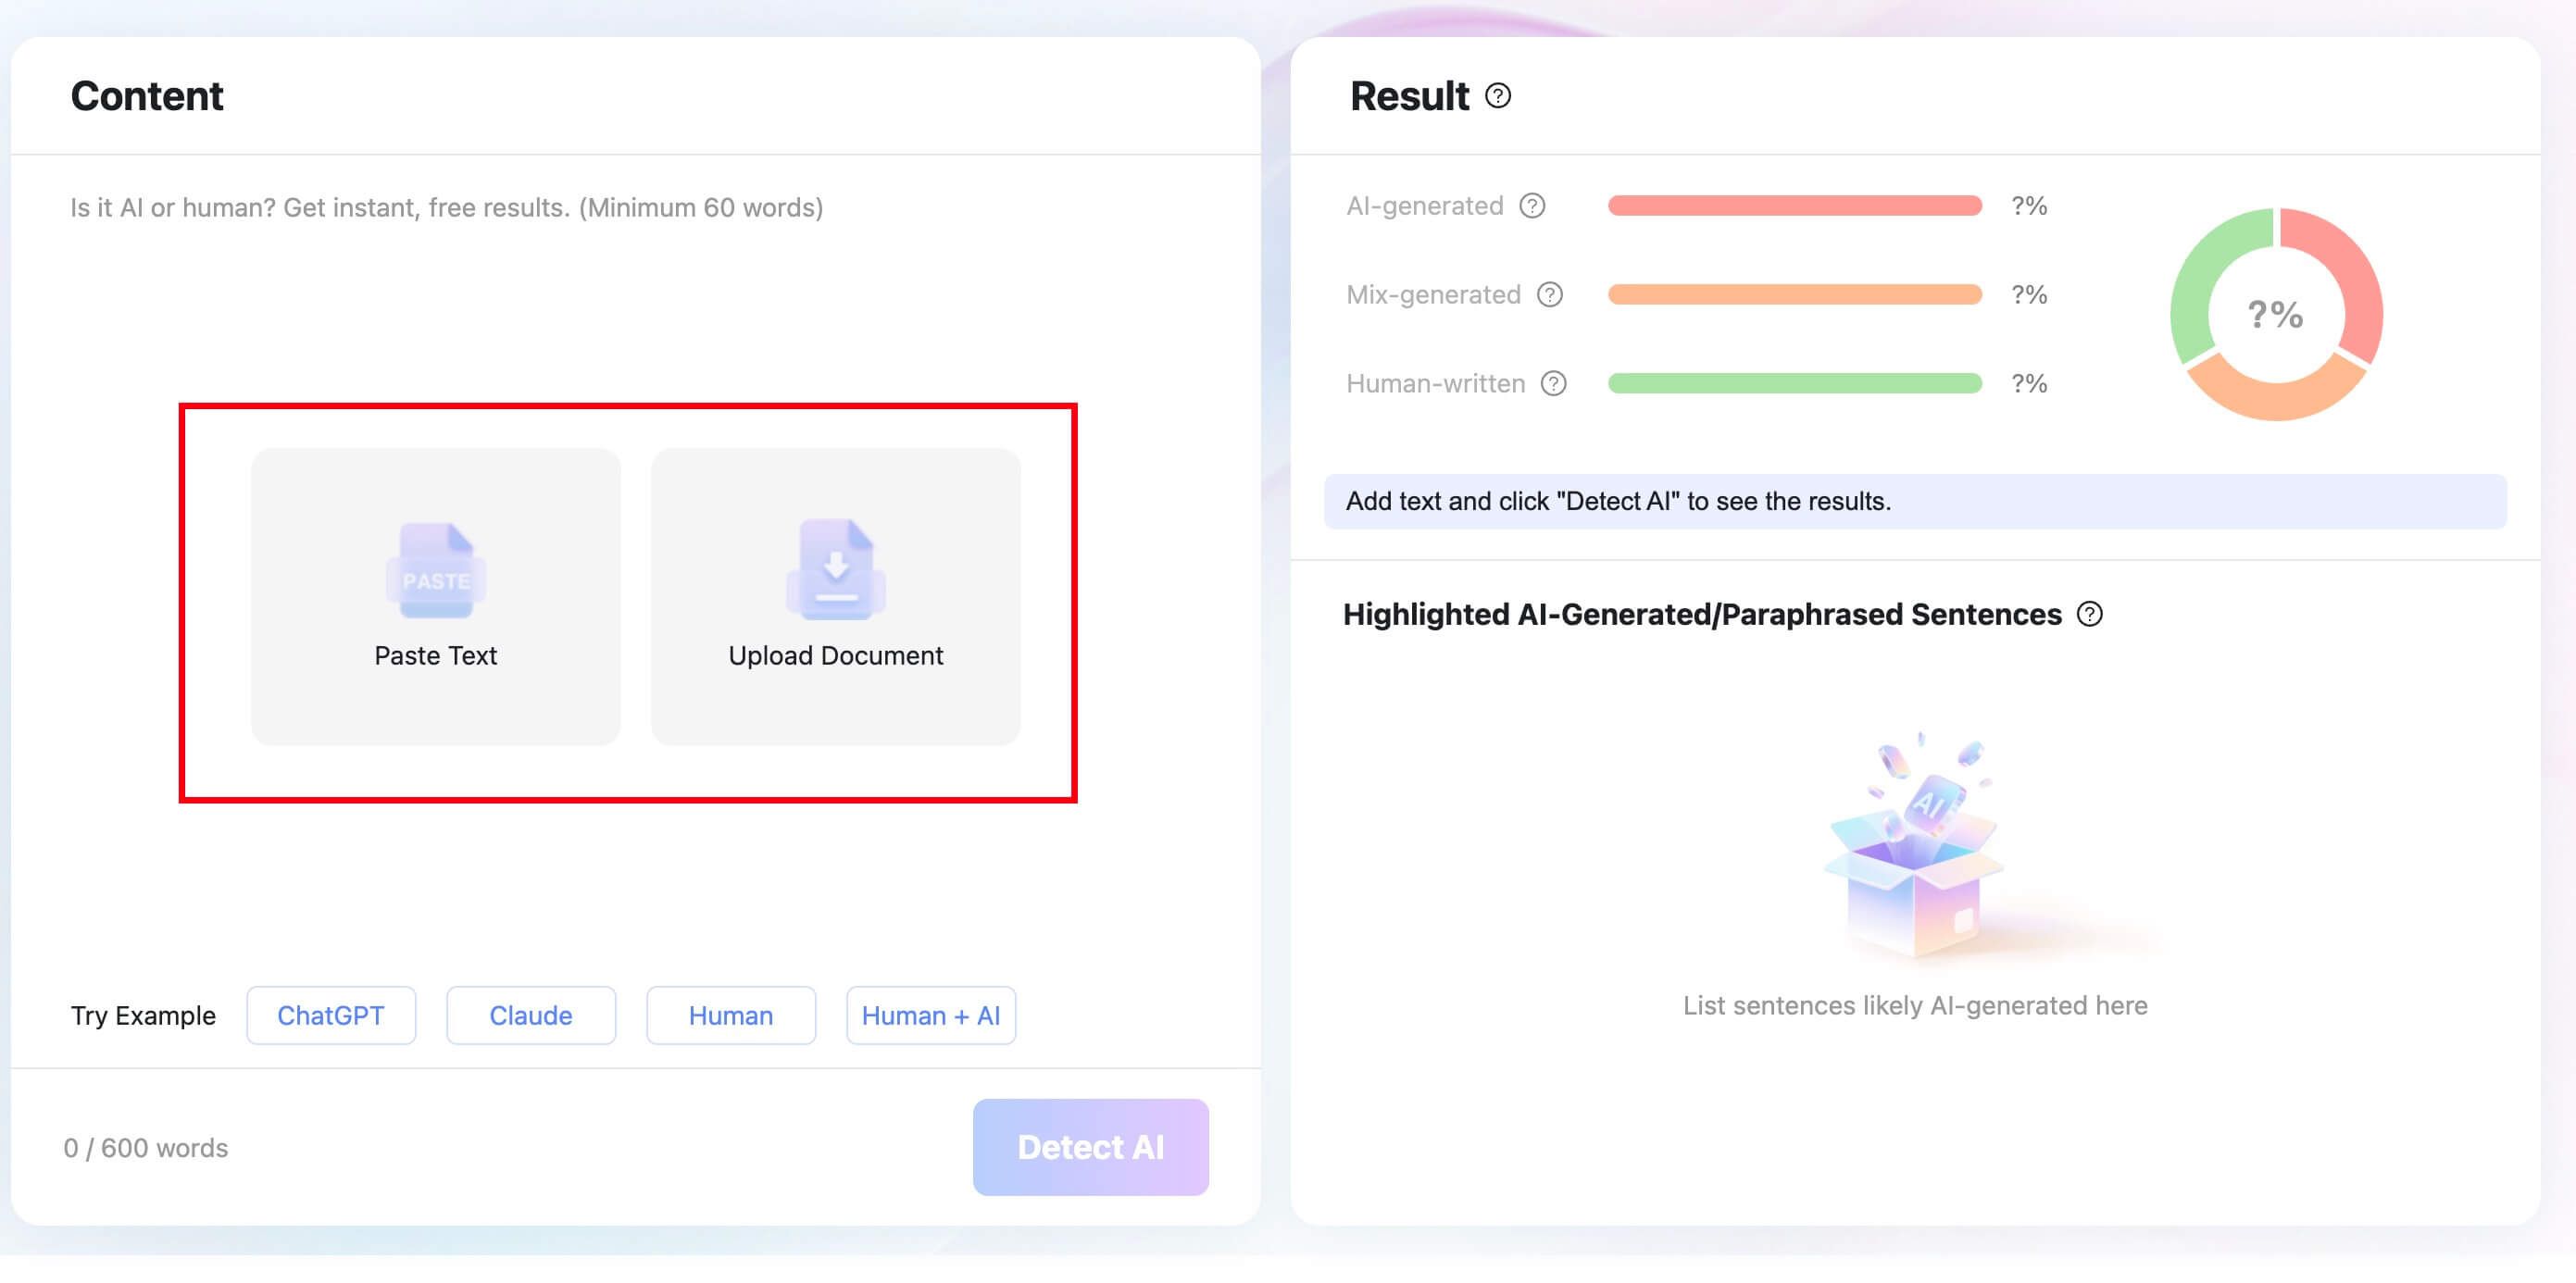
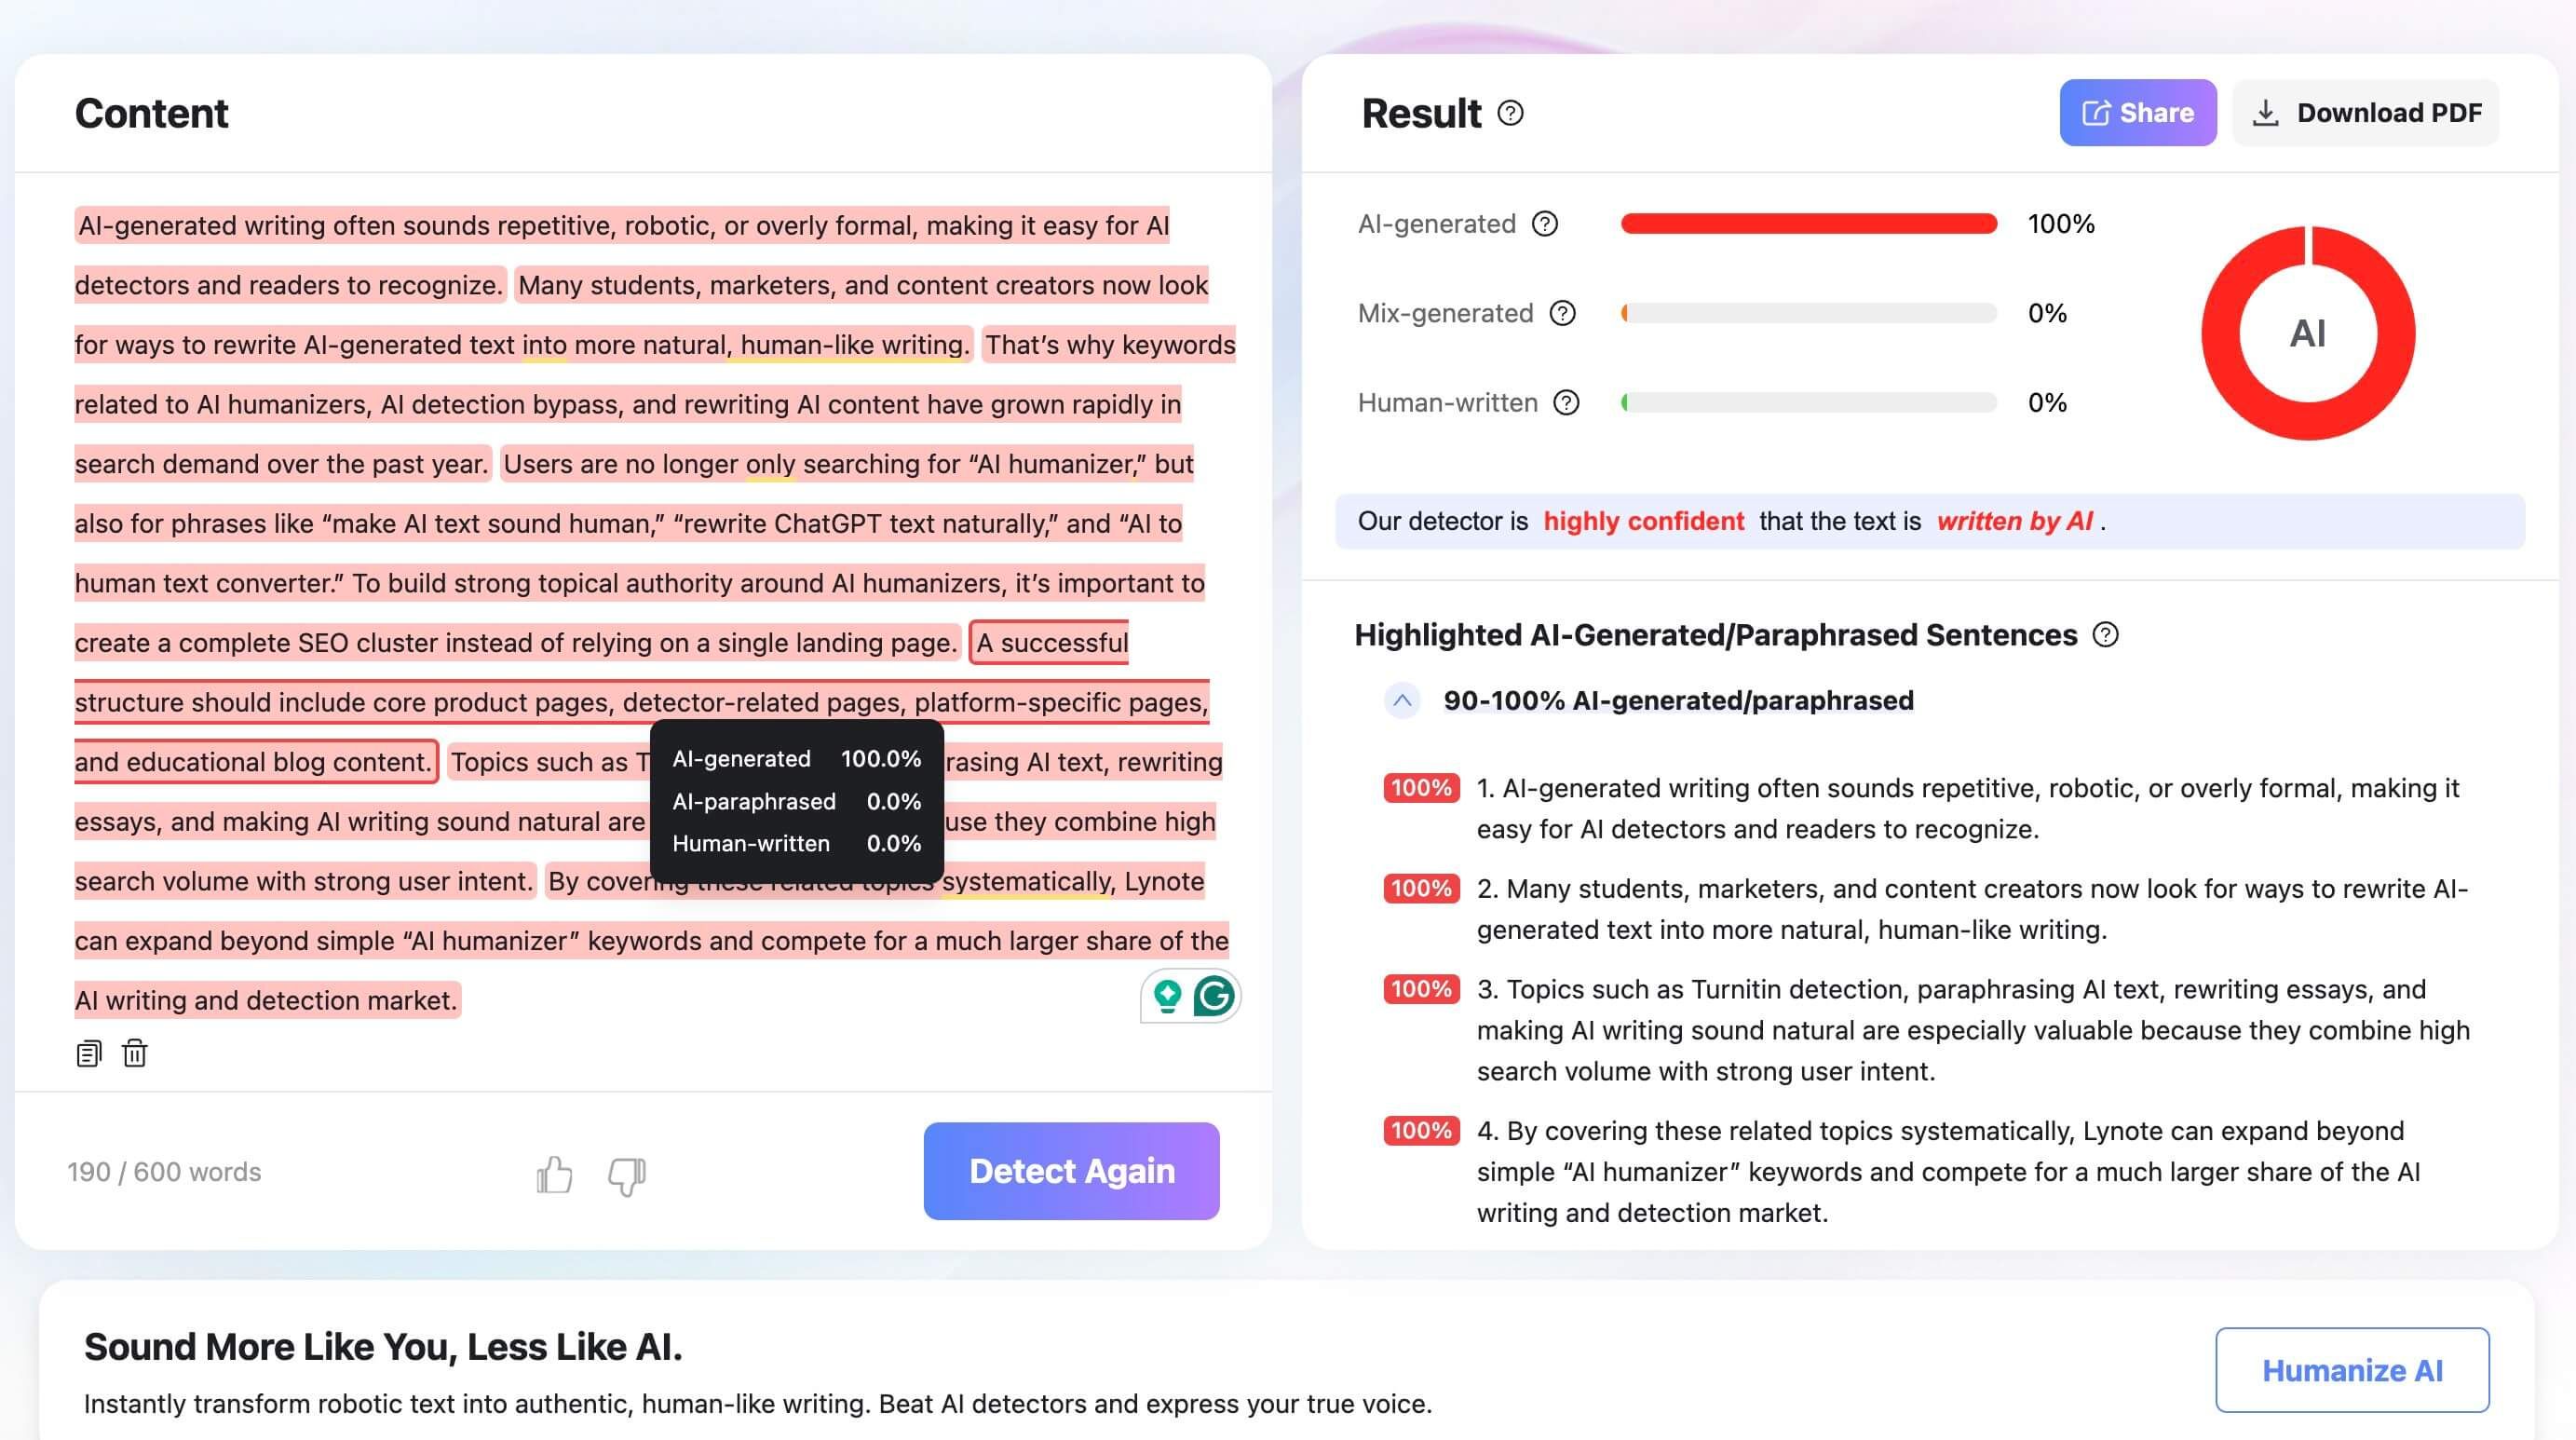
Если вы хотите просмотреть полный черновик, а не гадать по нескольким предложениям, Lynote AI Detector предлагает простой рабочий процесс первого прохода. Он разделяет свой результат на проценты сгенерированного ИИ, смешанного и написанного человеком текста и выделяет предложения для более тщательного изучения.
-
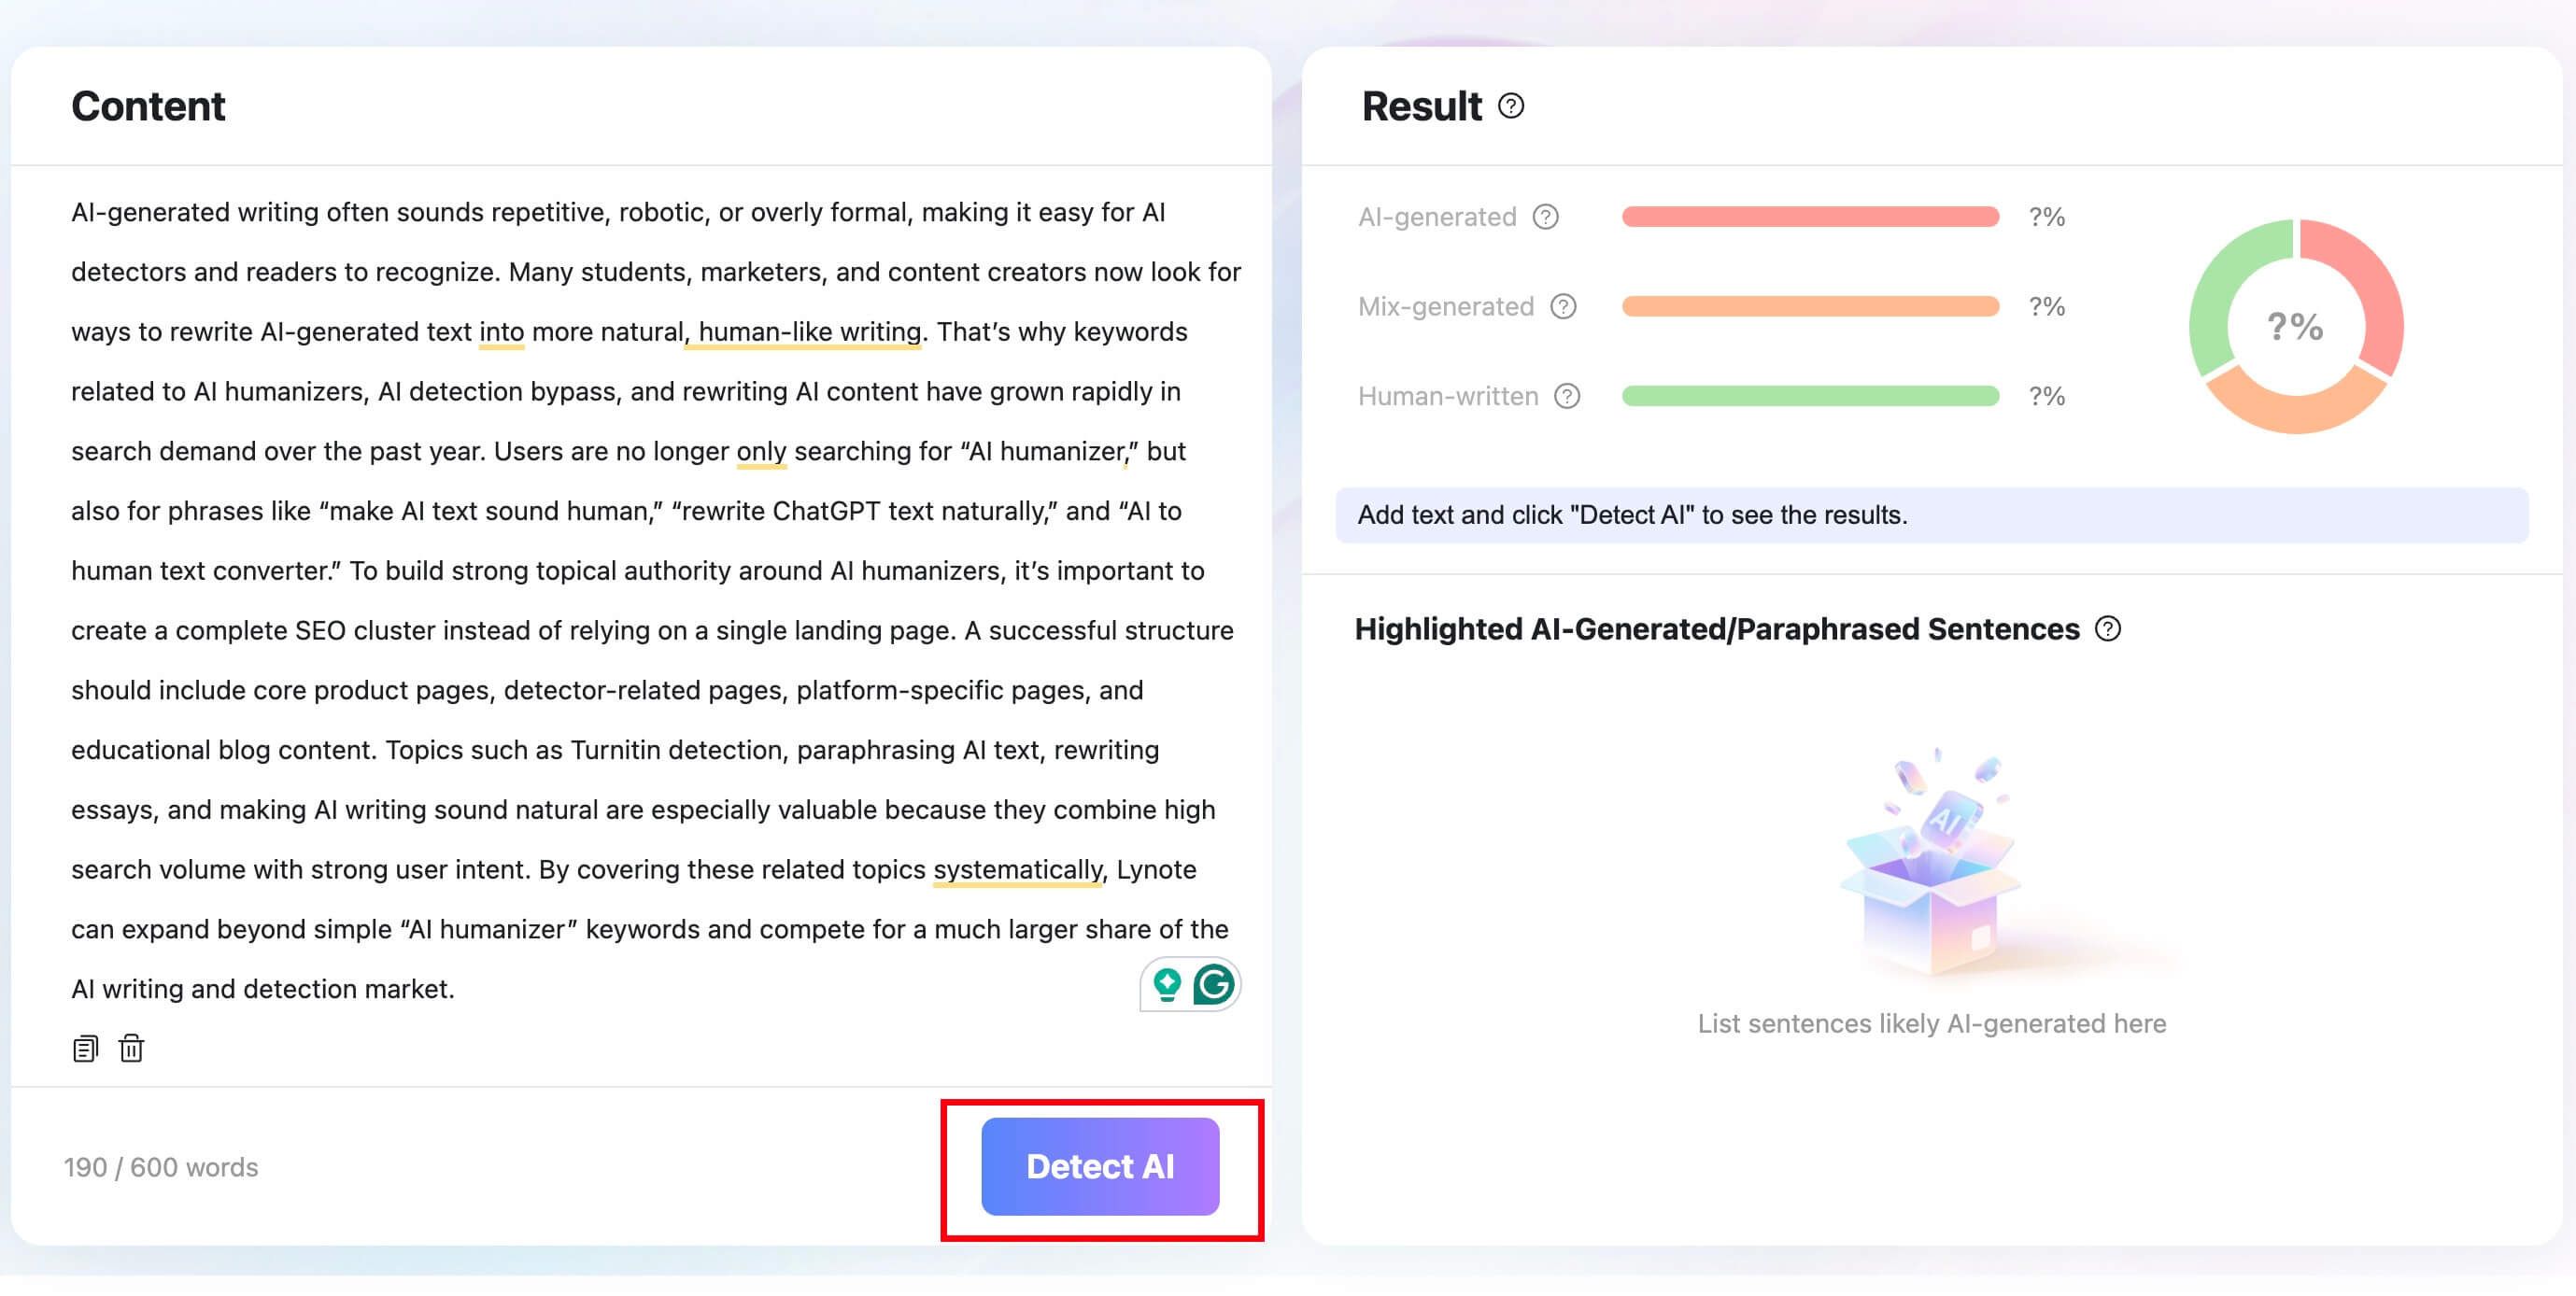
Вставьте текст или загрузите документ. Используйте текстовое поле для быстрой проверки или загрузите поддерживаемый файл DOCX, PDF или TXT. По возможности отправляйте значимый раздел, а не изолированную строку.
-
Запустите сканирование. Нажмите Detect AI и позвольте инструменту проанализировать отправленный текст.
-
Просмотрите полный результат. Прочитайте проценты ИИ, смешанного и человеческого текста вместе, затем изучите выделенные предложения вместо того, чтобы реагировать только на самое большое число.
-
Сравните сигнал с доказательствами вне детектора. Прежде чем делать вывод, изучите черновики, историю версий, цитируемые источники, заметки и объяснения автора.
Результат может подсказать вам, куда смотреть. Он не может сказать вам, кто написал документ или было ли разрешено его использование ИИ.

Как интерпретировать высокий или низкий балл ИИ
Оценка становится полезной только тогда, когда она меняет то, что вы будете проверять дальше.
| Если оценка высокая | Если оценка низкая | | --- | --- | --- | | Прочитайте выделенные отрывки в контексте. | Не рассматривайте результат как доказательство того, что это написал человек. | | Проверьте утверждения, цитаты, примеры и необычные изменения в стиле. | Проверьте, не слишком ли короткий отрывок для стабильного результата. | | Сравните документ с более ранними черновиками или историей версий. | Помните, что детекторы могут пропускать текст ИИ, а обновления моделей могут изменять производительность. | | Спросите автора о процессе, а не представляйте оценку как вердикт. | Используйте другие доказательства, если важны авторство или соблюдение политики. | | Запросите вторую проверку человеком для важных решений. | Избегайте объявления документа «проверенным человеком» по одному сканированию. |
Для авторов, проверяющих свою работу, высокая оценка не является указанием делать случайные замены или добавлять преднамеренные ошибки. Лучший ответ — проверить каждое утверждение, заменить общие наполнители конкретными доказательствами и убедиться, что окончательный аргумент отражает ваше собственное понимание.
Для преподавателей и редакторов детектор должен начинать проверку, а не заканчивать ее. Доказательства процесса часто говорят больше, чем вероятность, прикрепленная к окончательному черновику.
Проблема ложных срабатываний по-прежнему актуальна
Высокие показатели обнаружения известного ИИ и ложные срабатывания могут существовать одновременно. Детектор может улавливать почти каждый образец Astra в одном тесте, но при этом испытывать трудности с определенными видами человеческого письма.
Исследователи из Стэнфорда ранее обнаружили, что широко используемые детекторы GPT часто ошибочно классифицировали тексты авторов, для которых английский не является родным. Более недавнее исследование 2026 года изучило 135 389 пар рукописей, написанных человеком, до и после профессионального редактирования на английском языке. Среди 13 детекторов сообщаемые показатели ложных срабатываний охватывали весь возможный диапазон, и одни и те же изменения в редактировании толкали разные детекторы в противоположные стороны.
Это не означает, что каждый детектор бесполезен. Это означает, что стиль может стать мешающей переменной: формальные формулировки, последовательная грамматика, ограниченный словарный запас или профессиональное редактирование могут влиять на оценку, даже если авторство не изменилось.
Собственные рекомендации Turnitin отражают эту неопределенность. Он описывает свой отчет об ИИ как одну из точек данных и заявляет, что он не предназначен для предоставления окончательных ответов в изоляции.
Это разумный совет и за пределами образования. Оценка, работа, решение о публикации или обвинение не должны основываться на одном непрозрачном проценте.
Часто задаваемые вопросы об обнаружении ИИ GPT-6 Astra
Может ли Turnitin обнаружить GPT-6 Astra?
Turnitin может помечать текст, сгенерированный новыми языковыми моделями, если текст соответствует паттернам, которые его система связывает с ИИ. Однако ни один публичный тест Turnitin, специфичный для Astra, рассмотренный в этой статье, не устанавливает частоту обнаружения, и Turnitin заявляет, что его отчет не должен использоваться как окончательный ответ сам по себе.
Может ли детектор ИИ конкретно идентифицировать GPT-6 Astra?
Нет. Текущие результаты детекторов обычно оценивают, выглядит ли текст сгенерированным ИИ, смешанным или похожим на человеческий. Они не надежно идентифицируют Astra как точную модель и не раскрывают историю запросов и редактирования.
Изменяет ли редактирование текста GPT-6 Astra его оценку?
Может. Значительное человеческое редактирование изменяет формулировки, структуру, доказательства и стиль, что может изменить оценку паттерна детектором. Направление непредсказуемо, и редактирование должно улучшать точность и качество авторства, а не стремиться манипулировать оценкой.
Сколько текста нужно детектору?
Требования различаются в зависимости от инструмента. В одном эксперименте с Astra обнаружение одних и тех же отрывков возросло с 9 из 40 при 25 словах до 29 из 40 при 50 словах и всех 40 при 100 словах. Этот результат относится к одному детектору, но он показывает, почему полный отрывок более информативен, чем предложение.
Является ли максимально возможная оценка ИИ доказательством того, что текст написала Astra?
Нет. Это сильнейшая классификация детектора в рамках его собственной модели и шкалы. Она не доказывает, какая модель ИИ использовалась, кто ее использовал или существенно ли человек редактировал документ.
Может ли человеческий текст быть помечен как контент GPT-6?
Человеческий текст может получить оценку, похожую на ИИ, особенно когда детектор реагирует на стиль, а не на происхождение. Тексты, написанные не носителями английского языка, высоко стандартизированная академическая проза и профессионально отредактированный текст заслуживают особого внимания, поскольку исследования задокументировали непоследовательные ложные срабатывания.
Является ли низкая оценка доказательством того, что текст написал человек?
Нет. Низкая оценка означает, что детектор не нашел достаточно доказательств, связанных с ИИ, чтобы пересечь свой порог. Короткие отрывки, необычные жанры и отредактированный вывод ИИ могут снизить уверенность в обнаружении.
Окончательный вердикт
GPT-6 Astra обнаруживается в самых сильных опубликованных тестах, доступных на данный момент. Originality.ai пометил 999 из 1000 известных результатов Astra, Pangram полностью классифицировал 982 из 986 подходящих результатов как ИИ, и пять отдельных детекторов согласились в отношении одного неотредактированного эссе Astra.
Эти результаты подтверждают узкий вывод: текущие детекторы часто могут распознавать неотредактированную, длинную прозу Astra. Они не показывают, что каждый детектор одинаково надежен, что короткий или отредактированный текст будет вести себя так же, или что оценка доказывает авторство.
Используйте обнаружение ИИ как триаж. Предоставьте инструменту достаточно текста, прочитайте выделенные отрывки, а затем проверьте доказательства, которые классификатор не может увидеть: черновики, источники, контекст, историю написания и человека, стоящего за работой.
Автор: Danny
Менеджер по продуктовому маркетингу
Дэнни объясняет, как функции Lynote вписываются в реальные рабочие процессы: от повседневной продуктивности до сценариев использования для создания продуктового контента. Все статьи →