

Ja, GPT-6 Astra-inhoud is detecteerbaar in de huidige gepubliceerde tests. Twee grote leveranciersstudies markeerden meer dan 99% van de onbewerkte, bekende AI-samples die ze scoorden, en een kleinere vergelijking wees uit dat vijf verschillende detectoren allemaal hetzelfde Astra-essay markeerden. Dat is sterk bewijs dat gepolijste Astra-output niet automatisch onzichtbaar wordt voor AI-detectoren.
Het is geen bewijs dat elke detector elke Astra-passage zal vangen. Belangrijker nog, een hoge score kan u niet vertellen wie een document heeft geschreven, welk model het heeft geproduceerd, of dat een persoon überhaupt AI heeft gebruikt. De nuttige vraag is niet simpelweg "Kan AI GPT-6 Astra detecteren?" Het is wat het beschikbare bewijs daadwerkelijk meet, en wat het onopgelost laat.
Kort antwoord: Is GPT-6 Astra-inhoud detecteerbaar?
Voor onbewerkte Engelse proza van redelijke lengte is het antwoord vaak ja. De sterkste openbare resultaten die beschikbaar zijn in oktober 2026 wijzen in dezelfde richting, hoewel ze afkomstig zijn van detectorbedrijven en verschillende samples, drempels en inclusieregels gebruiken.
| Gepubliceerde test | Getest Astra-materiaal | Gerapporteerd resultaat | Wat het vaststelt | Wat het niet vaststelt |
|---|---|---|---|---|
| Originality.ai | 1.000 bekende Astra-reacties in vijf schrijf categorieën | 999 overschreden de AI-drempel | Zeer hoge detectie van dit bekende AI-sample met één detectorinstelling | Vals-positief percentage of prestaties bij menselijk schrijven |
| Pangram | 986 gescoorde Astra-reacties van gefilterde prompts | 982 AI, 3 gemengd, 1 menselijk | Zeer hoog volledig-AI-classificatiepercentage voor in aanmerking komende passages | Prestaties onder het minimum van 50 woorden of op menselijke controles |
| Vergelijking van vijf detectoren | Eén Astra-essay van 300 woorden | 5 van de 5 tools markeerden het; vier toonden hun maximale AI-score | Verschillende detectoren waren het eens over dat specifieke essay | Modelbrede nauwkeurigheid op basis van één documentvoorbeeld |
| Experiment met passage-lengte | 40 Astra-teksten getoond in vier lengtes | 9/40 gedetecteerd bij 25 woorden, 29/40 bij 50, en 40/40 bij 100 en 200 | Lengte kan het resultaat van één detector materieel veranderen | Een universele minimale lengte voor elke detector |
De praktische conclusie is eenvoudig: een compleet Astra-artikel zal eerder een betekenisvol detectorsignaal produceren dan een zin die eruit is gekopieerd. Zelfs dan betekent "gemarkeerd" dat de tekst overeenkwam met patronen die de detector associeert met AI. Het betekent niet dat de tool een verborgen GPT-6-label heeft teruggevonden.
Wat GPT-6 Astra verandert – en wat niet
OpenAI positioneert GPT-6 Astra als zijn meest capabele model voor veeleisende redenering, onderzoek, codering, computergebruik en documentcreatie. Het is gebouwd om gedetailleerde instructies te volgen en complex werk te ondersteunen, wat concepten kan produceren die coherenter en nuttiger zijn dan het stereotiepe chatbotantwoord.
De eigen documentatie van het model vermeldt ook een neiging tot gedetailleerde opmaak en terugkerende zinsneden, tenzij de gebruiker een andere schrijfstijl specificeert. Die observatie helpt verklaren waarom verbeterde capaciteit en detecteerbaarheid naast elkaar kunnen bestaan. Een document kan nauwkeurig, goed georganiseerd en vloeiend zijn, terwijl het toch regelmatigheden vertoont die een statistische classifier opmerkt.
Dit is waar mensen vaak de verkeerde sprong maken. Betere proza ziet er niet noodzakelijkerwijs menselijker uit voor een detector, omdat detectoren de proza niet beoordelen op intelligentie of bruikbaarheid. Ze schatten in of de taalpatronen lijken op materiaal in hun AI- en menselijke trainingsgegevens.
Ook is onhandig schrijven niet automatisch door AI geschreven. Mensen herhalen overgangen, gebruiken formuleachtige essaystructuren en schrijven ook generieke zinnen. Een detector leest patronen, niet intentie, auteurschap of de geschiedenis achter de cursor.
Wat gepubliceerde GPT-6 Astra-detectietests vonden
De headline-studies zien er opmerkelijk consistent uit. Hun methoden beantwoorden echter engere vragen dan de headlines soms suggereren.
Originality.ai: 999 van de 1.000 reacties overschreden de drempel
Originality.ai genereerde en scande 1.000 Engelse Astra-reacties: 200 blogs, 200 conversatiestukken, 200 verklarende reacties, 200 nieuwsreacties en 200 recensies. Het telde een score van ten minste 0,50 in de AI Allowance 15%-modus als gedetecteerd.
Alle blog-, verklarende, nieuws- en recensiesamples overschreden die drempel. De conversatiecategorie leverde 199 detecties op van de 200, wat resulteerde in 999 van de 1.000 in totaal. Het ene resultaat onder de drempel was conversatieschrijven.
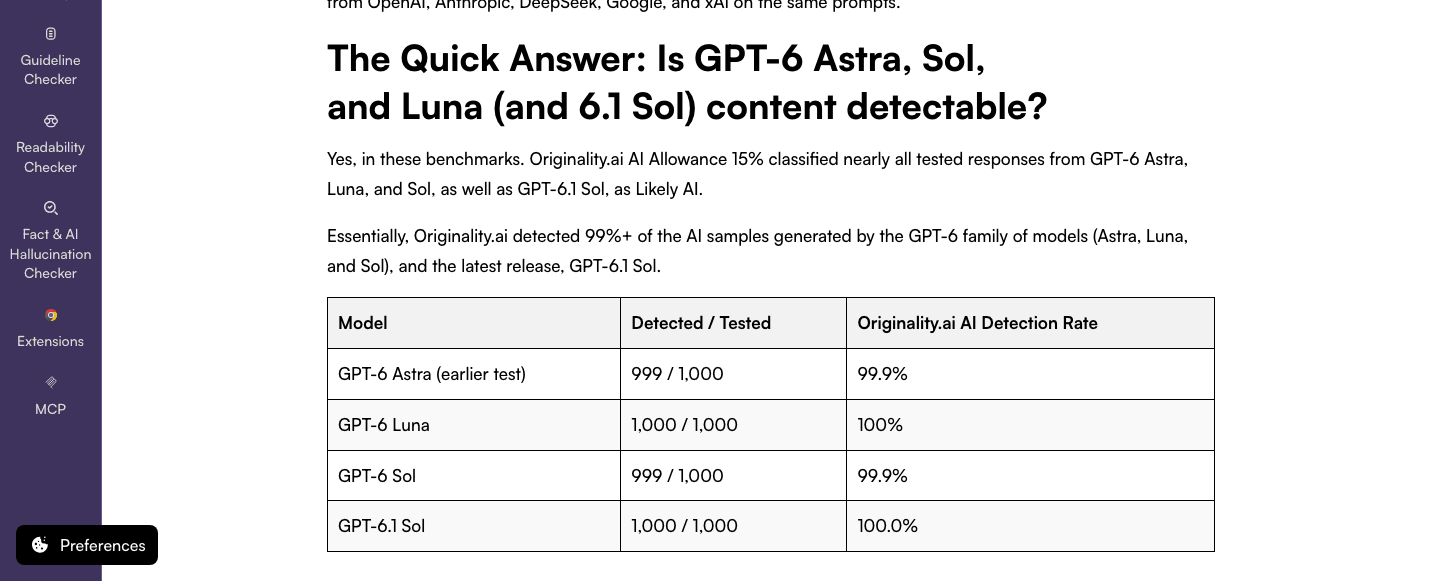
Dit is een sterk bekend-AI-detectieresultaat voor die detector en instelling. Het is geen volledige nauwkeurigheidsstudie omdat er geen overeenkomstige verzameling menselijk schrijven was. Zonder menselijke negatieven kan de studie niet aantonen hoe vaak dezelfde detector een persoon zou kunnen markeren.
Pangram: Vier outputs werden niet volledig als AI geclassificeerd
Pangram begon met 1.032 Astra-reacties op gefilterde eerste-beurt Chatbot Arena-prompts. Het scoorde 46 reacties die minder dan 50 woorden bevatten niet, waardoor 986 in aanmerking komende passages overbleven.
Hiervan werden 982 geclassificeerd als AI, drie als gemengd en één als menselijk. De niet-AI-resultaten omvatten korte of creatieve formaten zoals een e-mail, een verklaring en een gedicht. Dat detail is belangrijk omdat de missers niet gelijkmatig verdeeld waren over een uniforme set lange essays.
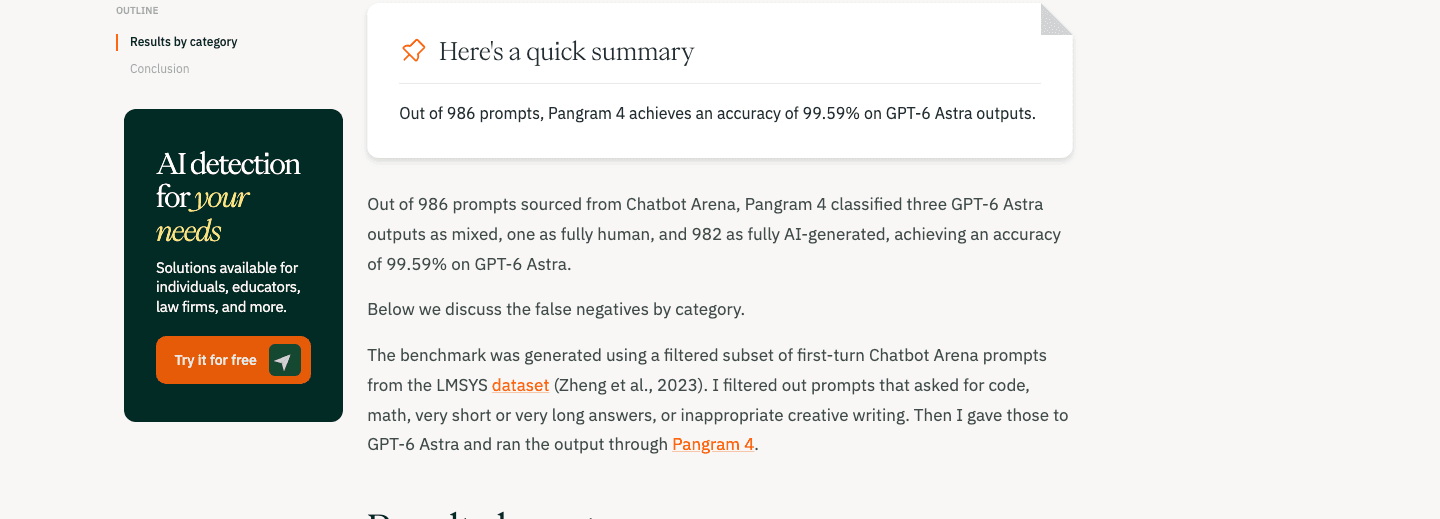
De studie ondersteunt een hoge detectiegraad voor Astra-tekst die voldeed aan de lengtevereiste van Pangram. Het vertelt ons niet hoe de uitgesloten korte antwoorden zouden hebben gescoord, en het bevat opnieuw geen menselijke controlegroep voor het schatten van vals-positieven.
Vijf detectoren waren het eens over één Astra-essay
Een kleinere studie nam één Astra-essay van 300 woorden en scande het met Phrasly, GPTZero, Pangram, Copyleaks en QuillBot. Elke tool markeerde het essay. Vier gaven hun maximaal weergegeven AI-score terug, terwijl QuillBot 82% AI teruggaf.
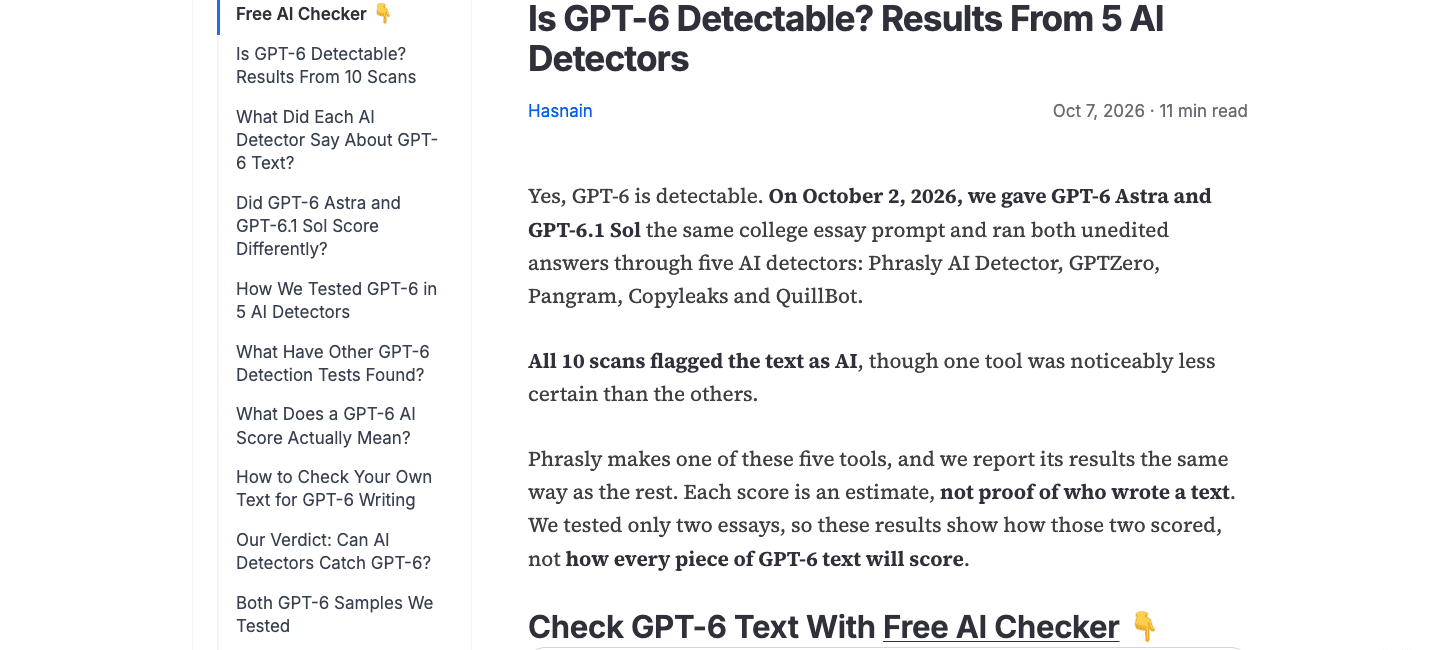
Die vergelijking is nuttig omdat het de tekst constant houdt terwijl de detector verandert. Het toont aan dat overeenstemming tussen tools mogelijk is, maar het toont ook aan dat hun percentages niet uitwisselbaar zijn. Een score van 82% en een maximale score kunnen leiden tot hetzelfde praktische label, terwijl ze afkomstig zijn van verschillende modellen en schalen.
Eén essay kan de prestaties van vijf detectoren niet vaststellen voor blogs, e-mails, technische rapporten en bewerkte concepten. Het is een momentopname van meerdere tools, geen rangschikking.
Dezelfde tekst werd moeilijker te detecteren toen deze werd ingekort
Het meest onthullende resultaat is mogelijk de kleinste studie. Onderzoekers namen 40 bekende Astra-passages en lieten dezelfde detector de eerste 25, 50, 100 of 200 woorden van elke passage zien. Alleen de hoeveelheid zichtbare tekst veranderde.
Bij 25 woorden werden 9 van de 40 passages gedetecteerd. Bij 50 woorden werden 29 van de 40 gedetecteerd. Bij zowel 100 als 200 woorden overschreden alle 40 de drempel.
Dit stelt geen universele regel van 100 woorden vast. Het toont wel aan waarom het controleren van een geïsoleerde zin valse geruststelling kan opleveren: er is mogelijk niet genoeg taal voor de detector om een stabiel patroon te vinden.
Onze heranalyse: 99,9% detectie is geen 99,9% nauwkeurigheid in de praktijk
De gepubliceerde tellingen maken een nuttige onafhankelijke berekening mogelijk. Een steekproefresultaat is een schatting, dus hebben we geschatte 95% Wilson-betrouwbaarheidsintervallen opnieuw berekend in plaats van elk percentage als exact te behandelen.
| Gepubliceerde telling | Waargenomen percentage | Geschat 95% interval | Voorzichtige interpretatie |
|---|---|---|---|
| Originality.ai: 999/1.000 | 99,90% | 99,44%-99,98% | Hoge detectiegraad op bekende Astra-samples onder de gerapporteerde instelling |
| Originality.ai conversatie: 199/200 | 99,50% | 97,22%-99,91% | Sterk resultaat, maar minder precies omdat de categorietest kleiner is |
| Pangram volledig AI: 982/986 | 99,59% | 98,96%-99,84% | Hoog volledig-AI-classificatiepercentage onder in aanmerking komende gescoorde outputs |
Deze intervallen versterken de conclusie dat de gerapporteerde bekende AI-detectiepercentages hoog waren. Ze vullen de ontbrekende helft van het experiment niet in.
Om een detector in de echte wereld te meten, hebben we zowel AI- als menselijke documenten nodig. Dat is de enige manier om te zien of een tool AI detecteert zonder ook te veel mensen te beschuldigen.
| Metriek | Kunnen de Astra-only studies het berekenen? | Waarom het ertoe doet |
|---|---|---|
| Detectiegraad op bekende AI-tekst | Ja | Toont hoe vaak de tool de AI-samples detecteert die het kreeg |
| Vals-negatief percentage | Ja | Toont hoeveel bekende AI-samples werden gemist onder de testregels |
| Specificiteit | Nee | Vereist menselijke tekst om te meten hoe vaak menselijk werk correct wordt goedgekeurd |
| Vals-positief percentage | Nee | Vereist menselijke tekst om te tellen hoe vaak mensen onterecht worden gemarkeerd |
| Precisie | Nee | Hangt af van zowel vals-positieven als hoe vaak AI-tekst voorkomt in de gecontroleerde populatie |
| Algehele nauwkeurigheid | Nee | Vereist zowel positieve als negatieve voorbeelden, plus een gedefinieerde klassebalans |
Het noemen van 999 van de 1.000 "99,9% nauwkeurigheid" gaat er stilzwijgend van uit dat de enige mogelijke fout het missen van AI is. In een klaslokaal, redactiekamer of wervingsproces is het onterecht markeren van een mens een andere en vaak ingrijpendere fout. De Astra-only tests waren niet ontworpen om dit te meten.
Waarom dezelfde GPT-6 Astra-tekst verschillende scores kan krijgen
Detectorresultaten zijn gevoelig voor het document dat voor hen ligt. Een modelnaam alleen kan de uiteindelijke score niet voorspellen.
De lengte van de passage verandert het beschikbare signaal. Een e-mail van 20 woorden en een rapport van 1.000 woorden kunnen van hetzelfde model komen, maar bieden zeer verschillende hoeveelheden bewijs. Lage scores op korte fragmenten verdienen een bijzonder voorzichtige interpretatie.
Genre verandert het taalpatroon. In de test van Originality.ai bevatte conversatieschrijven de enige misser. Pangram's niet-volledig-AI-classificaties omvatten formaten zoals een gedicht, e-mail en korte uitleg. Een detector die is gekalibreerd op essays kan anders reageren op dialoog of creatieve proza.
De prompt vormt de output. Astra kan gedetailleerde beperkingen volgen met betrekking tot toon, structuur, publiek en voorbeelden. Twee mensen die hetzelfde model gebruiken, kunnen tekst ontvangen met een zeer verschillend ritme en specificiteit.
Detectorversies en drempels verschillen. Elke tool definieert zijn eigen labels, trainingsgegevens, minimale lengte en beslissingsdrempel. Een percentage van de ene service is geen score die u punt voor punt kunt vergelijken met een andere.
Menselijke bewerking verandert de tekst die wordt beoordeeld. Het toevoegen van origineel bewijs, het reorganiseren van een argument, het corrigeren van feiten en het herschrijven vanuit persoonlijke kennis kan het statistische patroon veranderen. Dat geeft geen betrouwbaar recept om detectie te vermijden, en het heft de noodzaak niet op om AI-gebruik te openbaren wanneer een beleid dit vereist.
Kan een detector vertellen dat GPT-6 Astra het heeft geschreven?
Nee. Een typische tekstdetector identificeert niet het exacte model dat een passage heeft geproduceerd. Geen van de vijf tools in de cross-detectorvergelijking noemde Astra; ze gaven varianten van AI, gemengd, menselijk of een waarschijnlijkheidsscore terug.
| Vraag | Kan een tekstdetector het beantwoorden? |
|---|---|
| Lijkt deze passage op patronen die geassocieerd worden met AI-schrijven? | Het kan dit schatten, met onzekerheid. |
| Was AI ergens betrokken bij het schrijfproces? | Niet betrouwbaar op basis van alleen de uiteindelijke tekst. |
| Heeft GPT-6 Astra specifiek deze passage geproduceerd? | Nee. De score identificeert het exacte model niet. |
| Wie heeft de prompt ingevoerd of de output bewerkt? | Nee. Die geschiedenis bevindt zich buiten de tekst. |
| Schendt het document een school- of werkplekbeleid? | Nee. Dat vereist het beleid, de context en menselijk oordeel. |
De meest verdedigbare formulering is daarom "de passage werd gemarkeerd als AI-achtig", niet "de detector bewees dat dit door GPT-6 Astra was geschreven."
Hoe GPT-6 Astra-tekst te controleren met Lynote
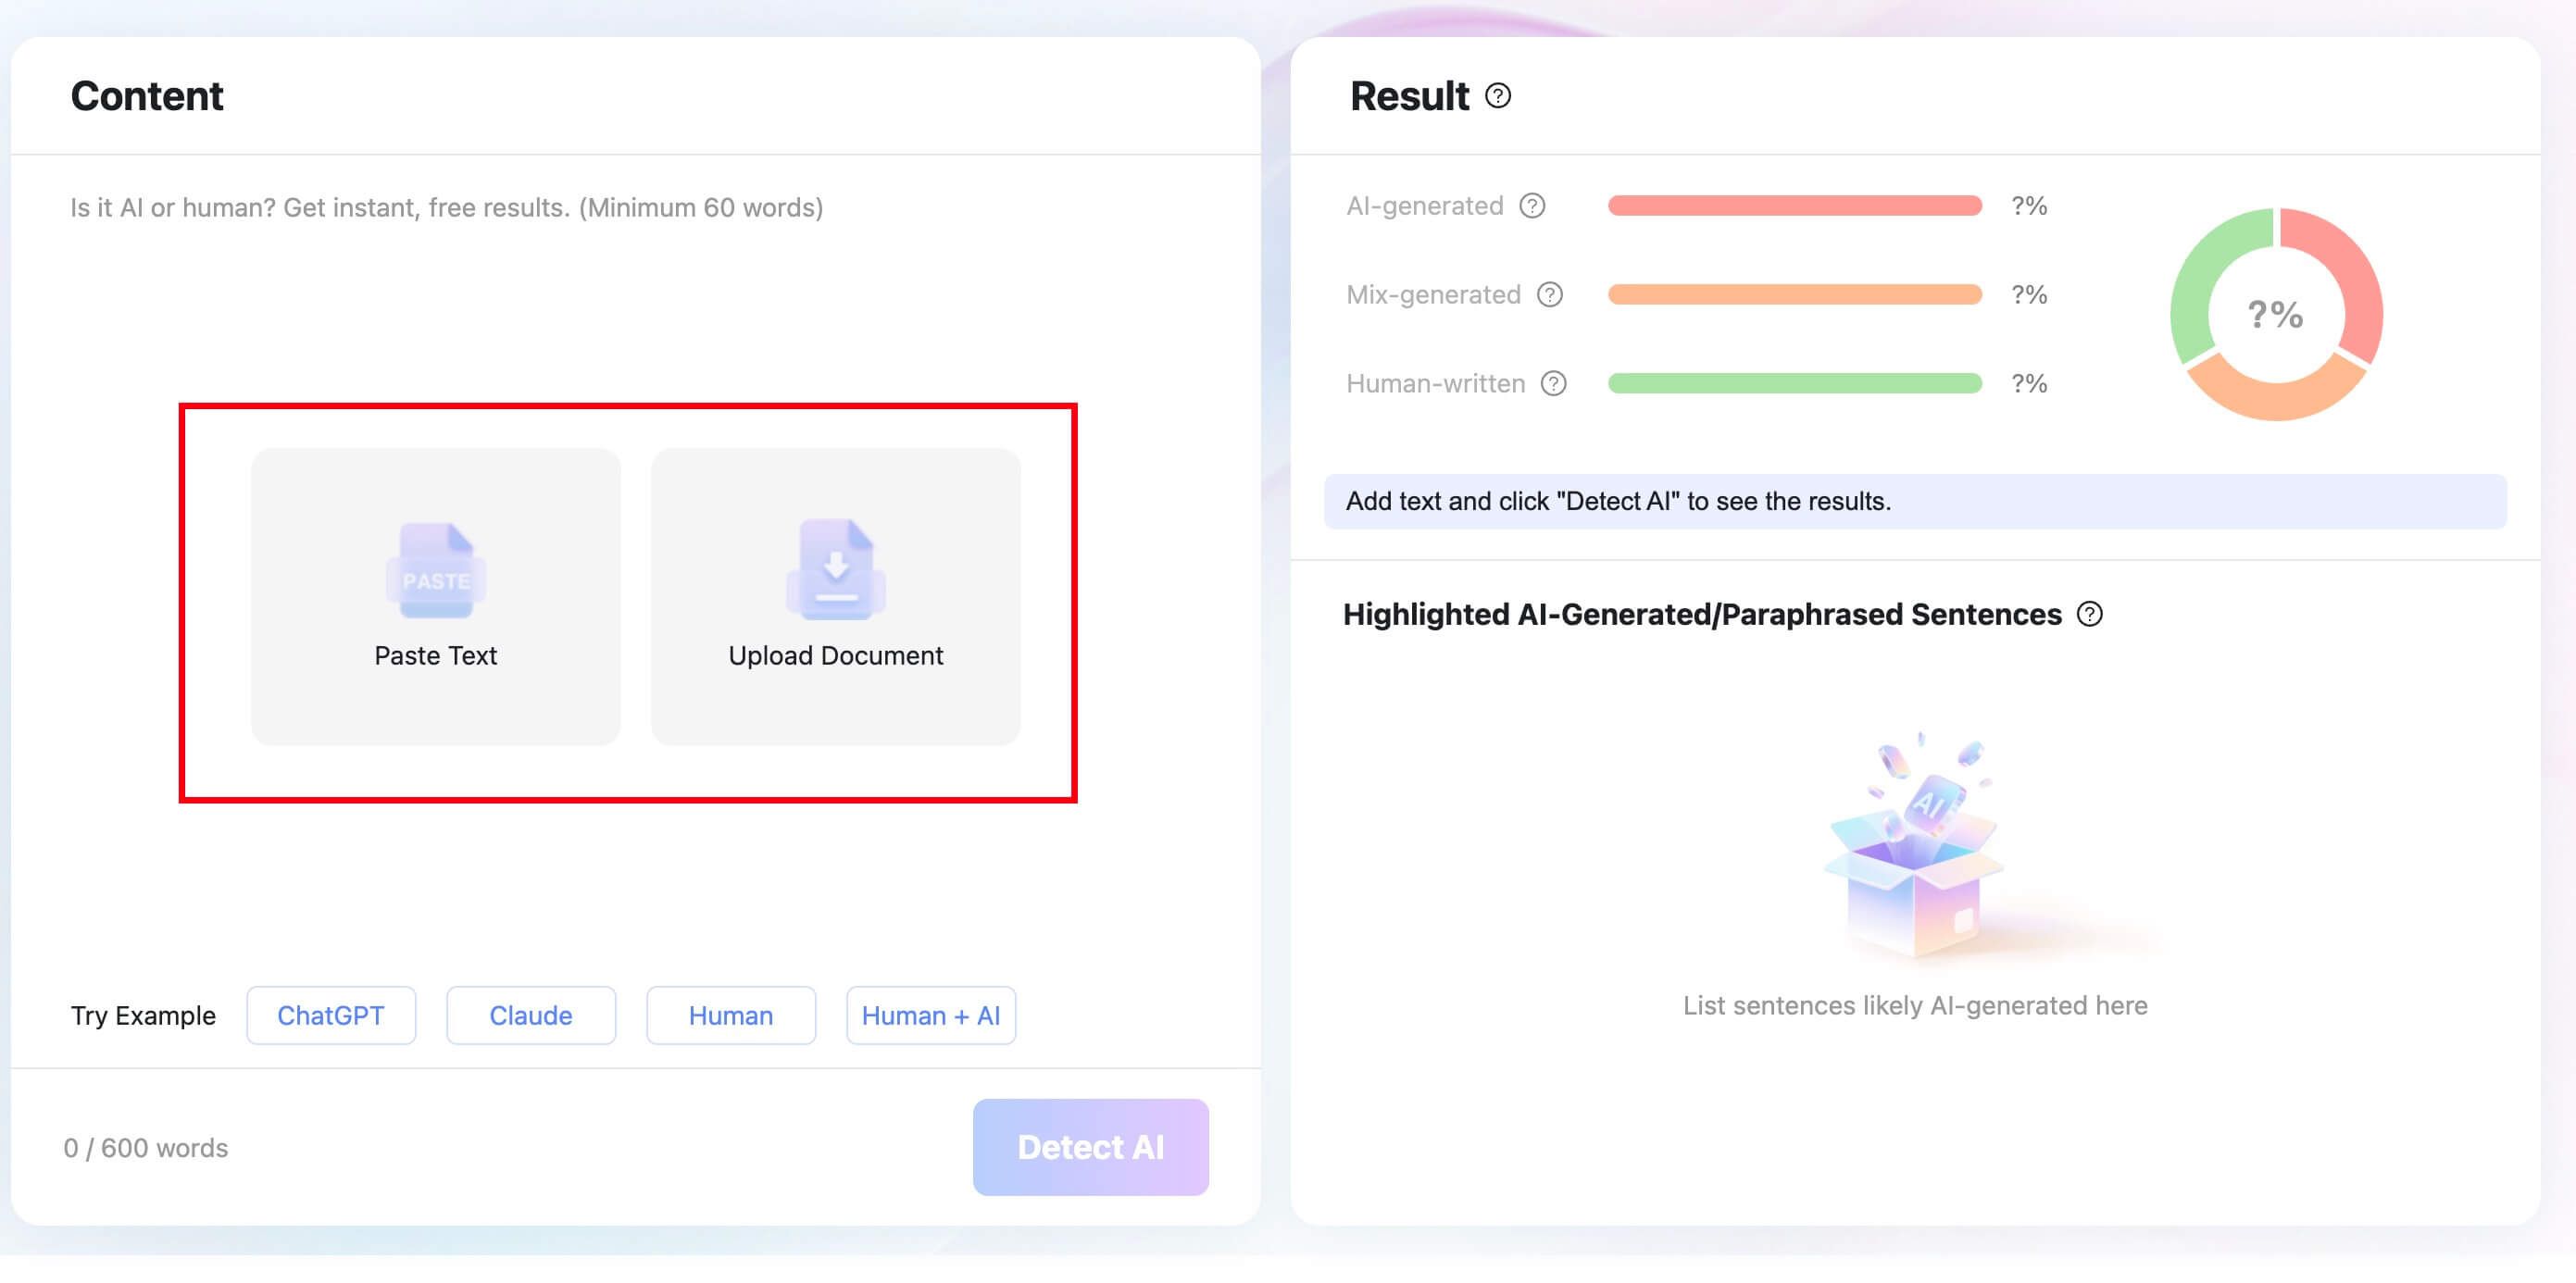
Als u een compleet concept wilt beoordelen in plaats van te gissen op basis van een paar zinnen, biedt Lynote AI Detector een eenvoudige eerste workflow. Het splitst het resultaat op in AI-gegenereerde, gemengde en menselijk geschreven percentages en markeert zinnen voor nadere beoordeling.
-
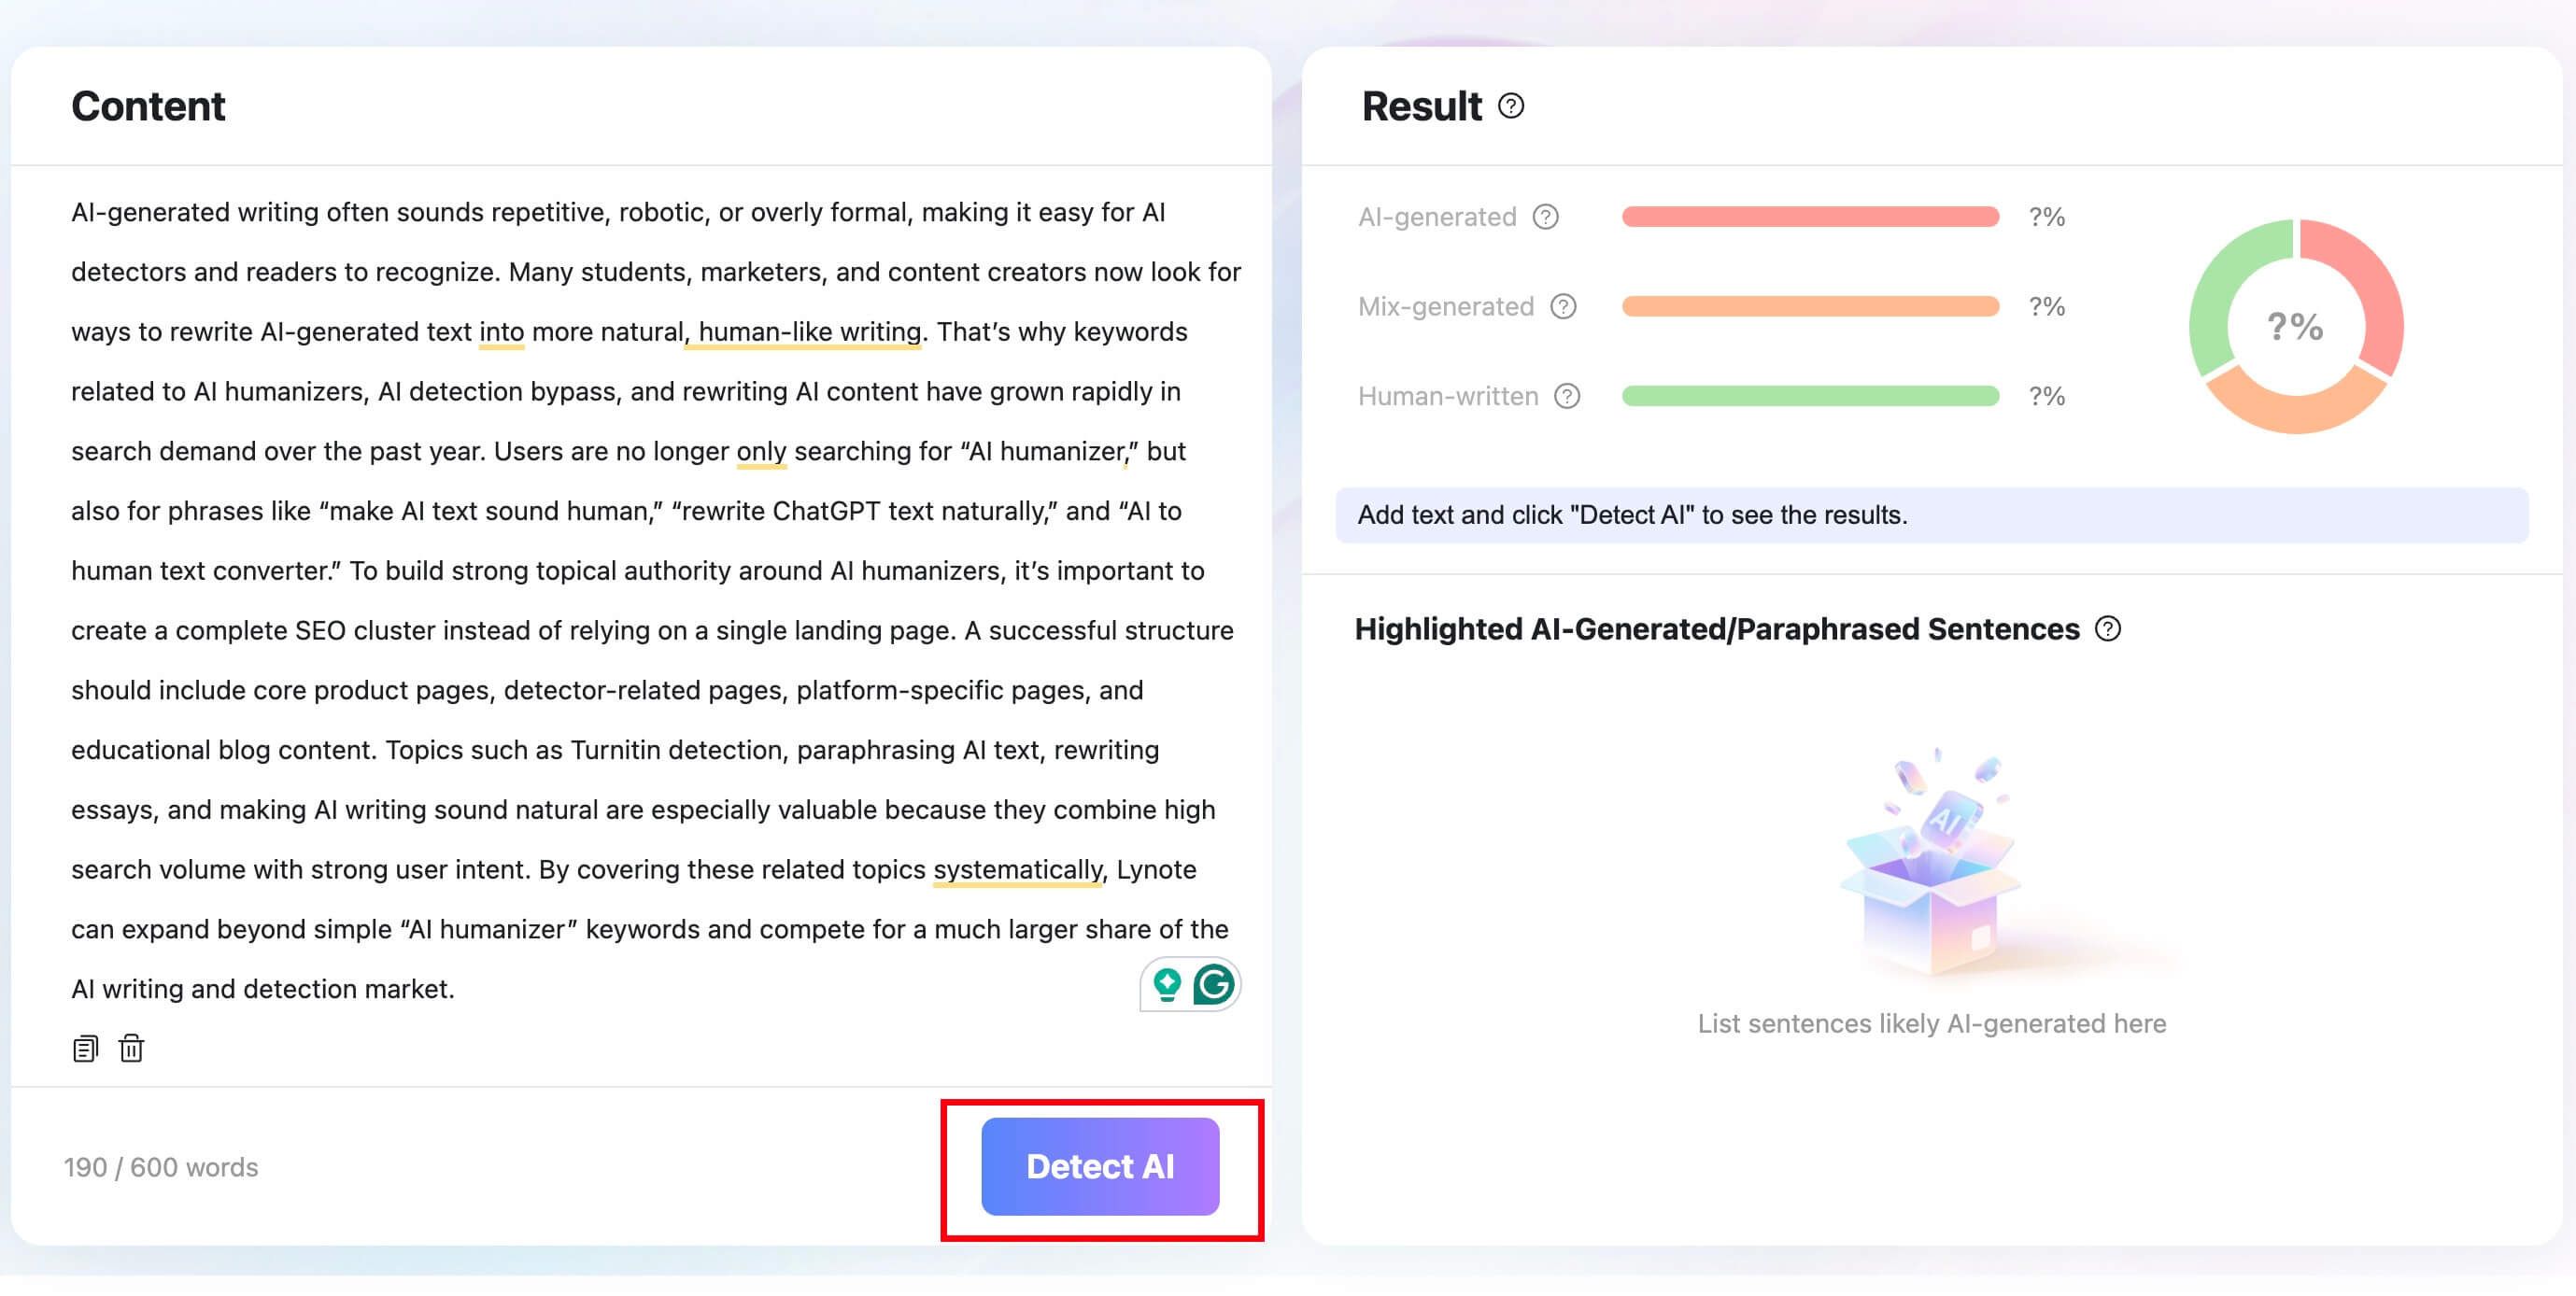
Plak de tekst of upload een document. Gebruik het tekstvak voor een snelle controle, of upload een ondersteund DOCX-, PDF- of TXT-bestand. Dien indien mogelijk een zinvol gedeelte in in plaats van een geïsoleerde regel.
-
Voer de scan uit. Klik op Detecteer AI en laat de tool de ingediende tekst analyseren.
-
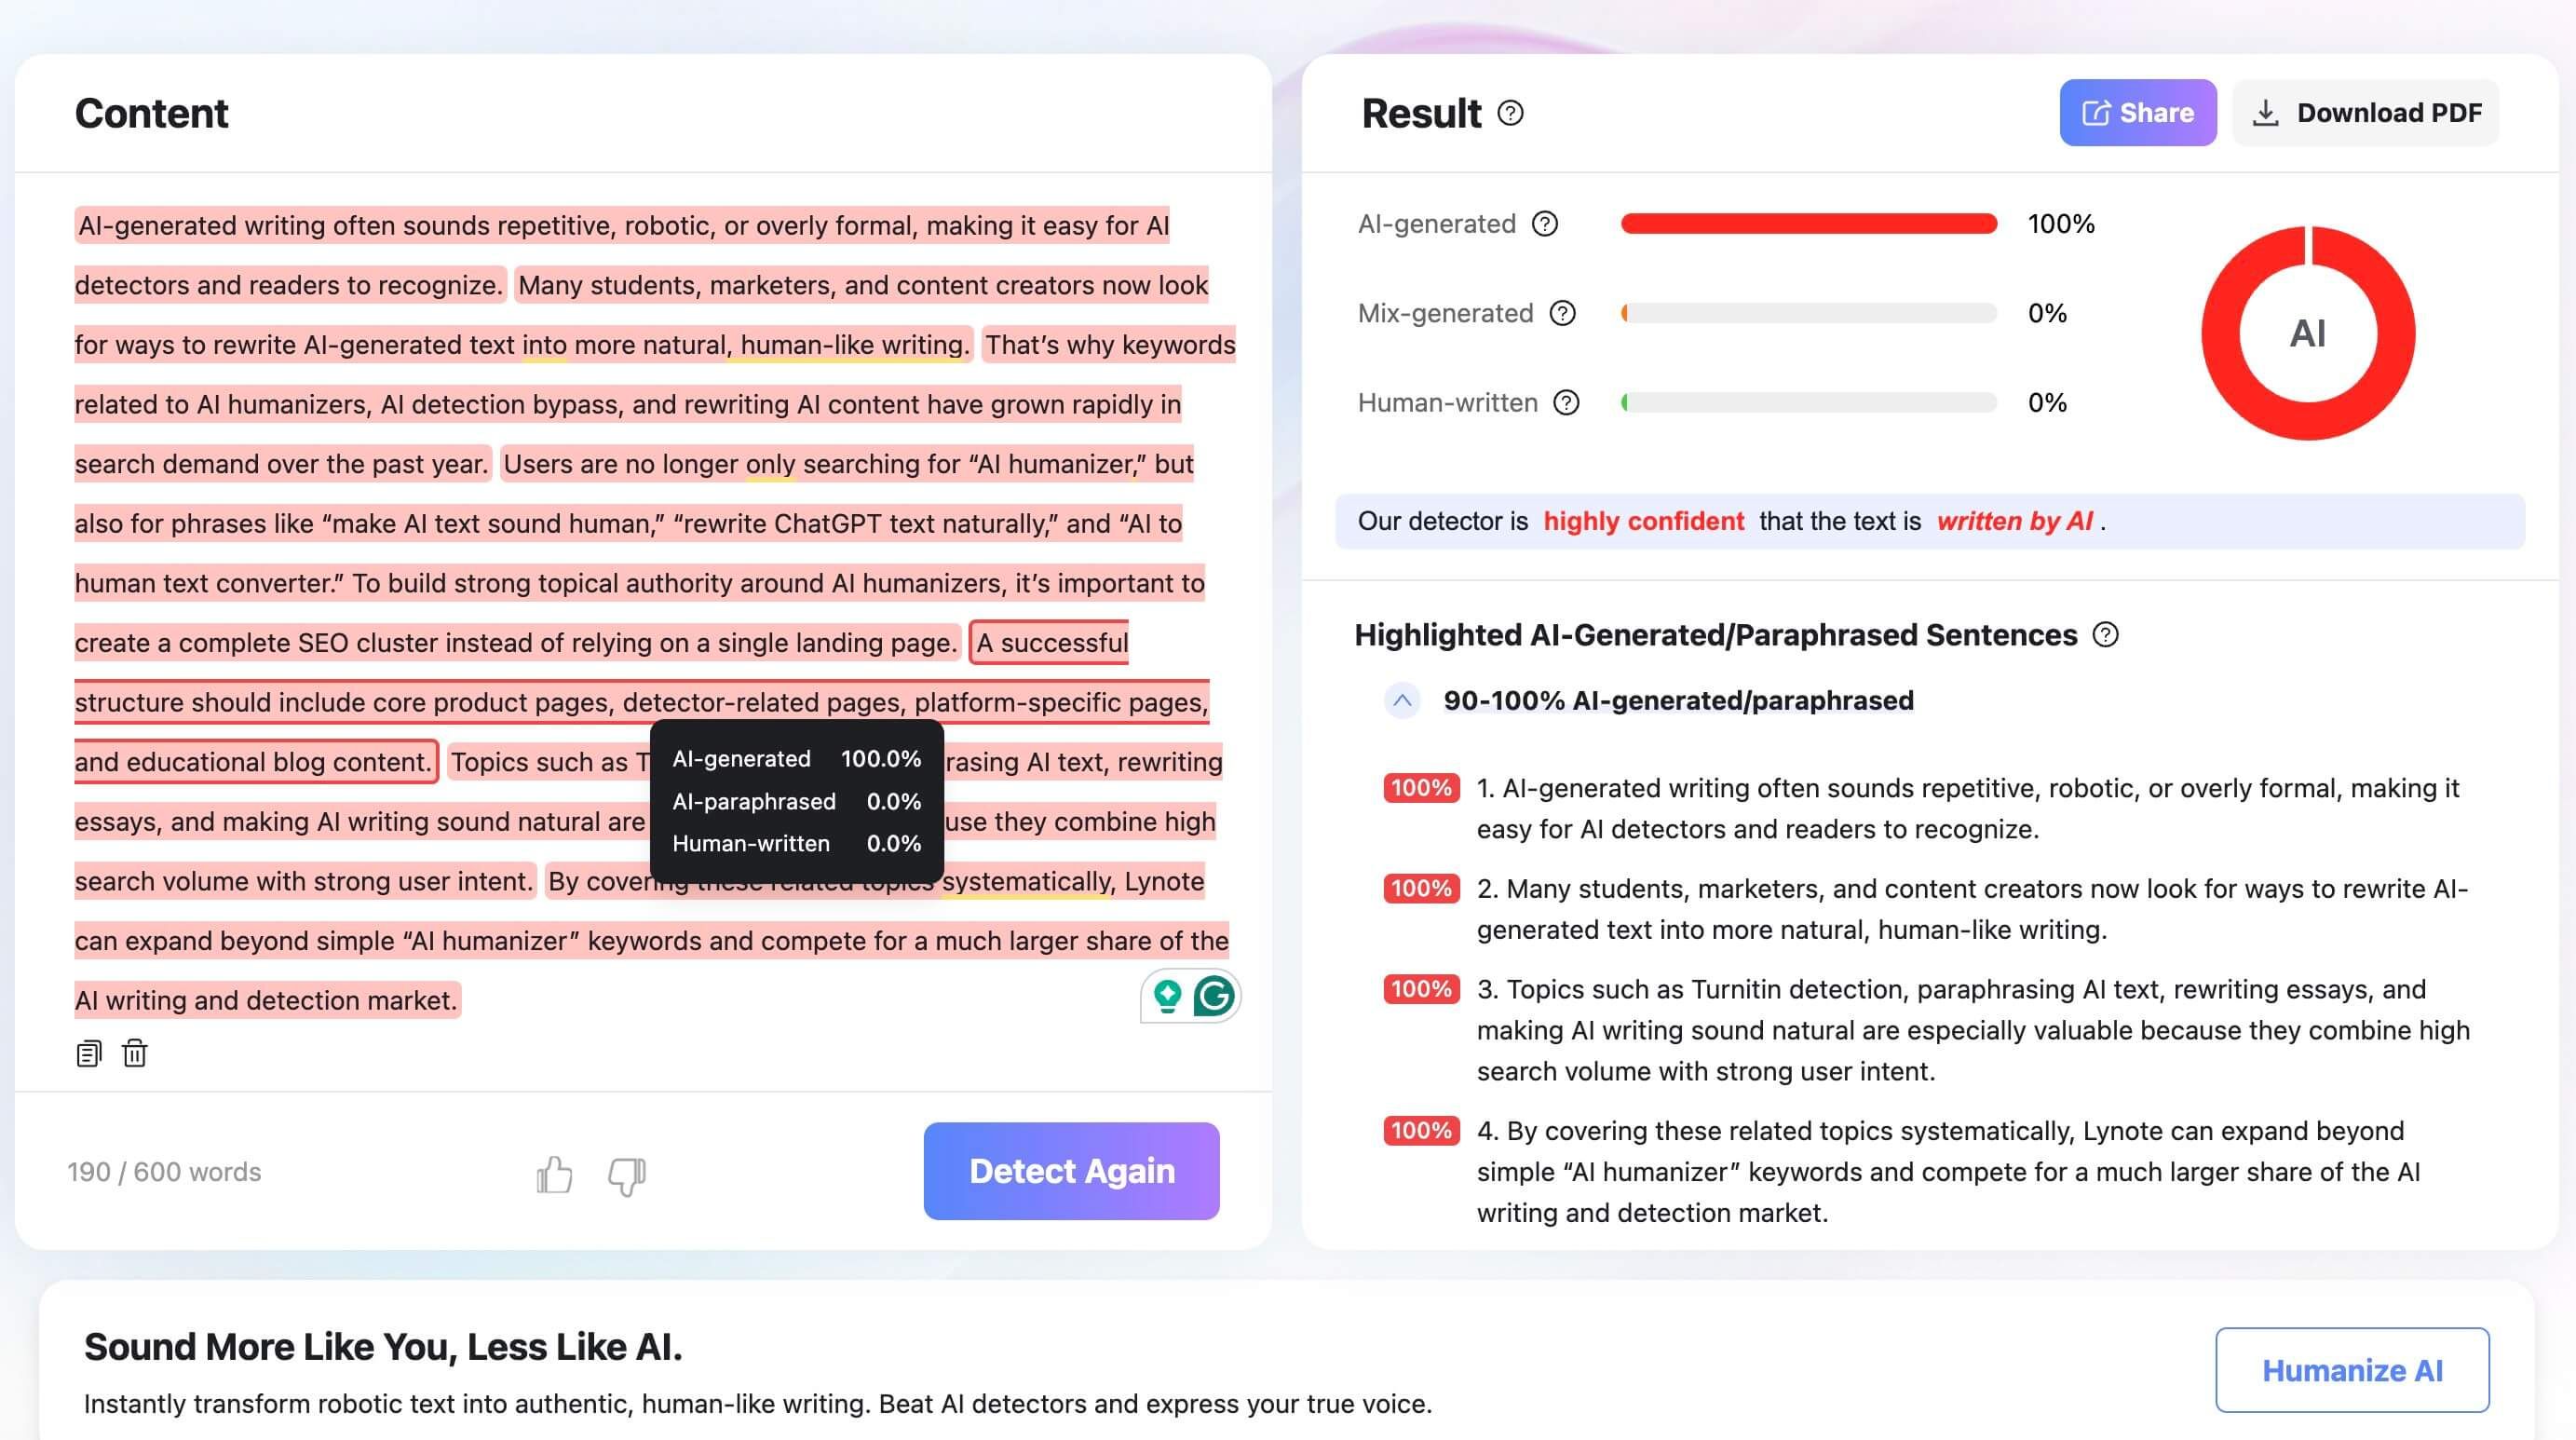
Bekijk het volledige resultaat. Lees de AI-, gemengde en menselijke percentages samen, en inspecteer vervolgens de gemarkeerde zinnen in plaats van alleen te reageren op het grootste getal.
-
Vergelijk het signaal met bewijs buiten de detector. Bekijk concepten, versiegeschiedenis, geciteerde bronnen, notities en de uitleg van de schrijver voordat u een conclusie trekt.
Het resultaat kan u vertellen waar u moet kijken. Het kan u niet vertellen wie het document heeft geschreven of of het gebruik van AI was toegestaan.

Hoe een hoge of lage AI-score te interpreteren
Een score wordt pas nuttig als deze verandert wat u vervolgens beoordeelt.
| Als de score hoog is | Als de score laag is |
|---|---|
| Lees de gemarkeerde passages in context. | Behandel het resultaat niet als bewijs dat een persoon het heeft geschreven. |
| Controleer beweringen, citaten, voorbeelden en ongebruikelijke stemveranderingen. | Controleer of de passage te kort is voor een stabiel resultaat. |
| Vergelijk het document met eerdere concepten of de versiegeschiedenis. | Onthoud dat detectoren AI-tekst kunnen missen en modelupdates de prestaties kunnen veranderen. |
| Vraag de schrijver naar het proces in plaats van de score als een oordeel te presenteren. | Gebruik ander bewijs als auteurschap of beleidsnaleving van belang is. |
| Vraag een tweede menselijke beoordeling aan voor belangrijke beslissingen. | Vermijd het document "geverifieerd menselijk" te verklaren op basis van één scan. |
Voor schrijvers die hun eigen werk beoordelen, is een hoge score geen instructie om willekeurige vervangingen te doen of opzettelijke fouten toe te voegen. Een betere reactie is om elke bewering te verifiëren, generieke opvulling te vervangen door specifiek bewijs en ervoor te zorgen dat het uiteindelijke argument uw eigen begrip weerspiegelt.
Voor docenten en redacteuren moet de detector een beoordeling starten, niet beëindigen. Procesbewijs vertelt u vaak meer dan een waarschijnlijkheid die aan het uiteindelijke concept is gekoppeld.
Het vals-positieve probleem doet er nog steeds toe
Hoge bekende AI-detectiepercentages en vals-positieven kunnen tegelijkertijd bestaan. Een detector kan bijna elk Astra-sample in één benchmark detecteren, terwijl het nog steeds moeite heeft met specifieke soorten menselijk schrijven.
Onderzoekers van Stanford ontdekten eerder dat veelgebruikte GPT-detectoren vaak schrijven van niet-moedertaalsprekers van het Engels verkeerd classificeerden. Een recentere studie uit 2026 onderzocht 135.389 paren van menselijk geschreven manuscripten voor en na professionele Engelse redactie. Over 13 detectoren varieerden de gerapporteerde vals-positieve percentages over het volledige mogelijke bereik, en dezelfde bewerkingswijzigingen duwden verschillende detectoren in tegengestelde richtingen.
Dat betekent niet dat elke detector nutteloos is. Het betekent dat stijl een verstorende variabele kan worden: formele formulering, consistente grammatica, beperkte woordenschat of professionele redactie kunnen een score beïnvloeden, zelfs als het auteurschap niet is veranderd.
De eigen richtlijnen van Turnitin weerspiegelen deze onzekerheid. Het beschrijft zijn AI-rapport als één datapunt en zegt dat het niet bedoeld is om definitieve antwoorden op zichzelf te geven.
Dat is ook verstandig advies buiten het onderwijs. Een cijfer, baan, publicatiebeslissing of beschuldiging mag niet afhangen van één ondoorzichtig percentage.
Veelgestelde vragen over GPT-6 Astra AI-detectie
Kan Turnitin GPT-6 Astra detecteren?
Turnitin kan tekst markeren die is gegenereerd door nieuwere taalmodellen wanneer de tekst overeenkomt met patronen die het systeem associeert met AI. Er is echter geen openbare Astra-specifieke Turnitin-benchmark die voor dit artikel is beoordeeld en een detectiegraad vaststelt, en Turnitin zegt dat het rapport op zichzelf niet als een definitief antwoord mag worden gebruikt.
Kan een AI-detector specifiek GPT-6 Astra identificeren?
Nee. Huidige detectorresultaten schatten over het algemeen in of tekst AI-gegenereerd, gemengd of mensachtig lijkt. Ze identificeren Astra niet betrouwbaar als het exacte model of onthullen de prompt- en bewerkingsgeschiedenis niet.
Verandert het bewerken van GPT-6 Astra-tekst de score?
Dat kan. Betekenisvolle menselijke bewerking verandert de formulering, structuur, bewijs en stem, wat de patroonschatting van een detector kan wijzigen. De richting is onvoorspelbaar, en bewerken moet de nauwkeurigheid en auteurschapskwaliteit verbeteren in plaats van te proberen een score te manipuleren.
Hoeveel tekst heeft een detector nodig?
Vereisten variëren per tool. In één Astra-experiment steeg de detectie op dezelfde passages van 9 van de 40 bij 25 woorden naar 29 van de 40 bij 50 woorden en alle 40 bij 100 woorden. Dat resultaat behoort tot één detector, maar het toont aan waarom een complete passage informatiever is dan een zin.
Is de hoogst mogelijke AI-score bewijs dat Astra de tekst heeft geschreven?
Nee. Het is de sterkste classificatie van de detector onder zijn eigen model en schaal. Het bewijst niet welk AI-model werd gebruikt, wie het gebruikte, of dat een persoon het document substantieel heeft bewerkt.
Kan menselijk schrijven worden gemarkeerd als GPT-6-inhoud?
Menselijk schrijven kan een AI-achtige score krijgen, vooral wanneer een detector reageert op stijl in plaats van op oorsprong. Niet-moedertaal Engels schrijven, sterk gestandaardiseerde academische proza en professioneel bewerkte tekst verdienen bijzondere voorzichtigheid, omdat onderzoek inconsistente vals-positieven heeft gedocumenteerd.
Is een lage score bewijs dat een mens de tekst heeft geschreven?
Nee. Een lage score betekent dat de detector niet genoeg AI-gerelateerd bewijs heeft gevonden om de drempel te overschrijden. Korte passages, ongebruikelijke genres en bewerkte AI-output kunnen allemaal het detectievertrouwen verminderen.
Eindoordeel
GPT-6 Astra is detecteerbaar in de sterkste gepubliceerde tests die tot nu toe beschikbaar zijn. Originality.ai markeerde 999 van de 1.000 bekende Astra-outputs, Pangram classificeerde 982 van de 986 in aanmerking komende outputs volledig als AI, en vijf afzonderlijke detectoren waren het eens over één onbewerkte Astra-essay.
Die resultaten ondersteunen een beperkte conclusie: huidige detectoren kunnen vaak onbewerkte, lange Astra-proza herkennen. Ze tonen niet aan dat elke detector even betrouwbaar is, dat korte of bewerkte tekst zich op dezelfde manier zal gedragen, of dat een score auteurschap bewijst.
Gebruik AI-detectie als triage. Geef de tool voldoende tekst, lees de gemarkeerde passages en controleer vervolgens het bewijs dat een classifier niet kan zien: concepten, bronnen, context, schrijfgeschiedenis en de persoon achter het werk.
Geschreven door Danny
Productmarketingmanager
Danny legt uit hoe de functies van Lynote passen bij echte workflows, van dagelijkse productiviteit tot productgerichte schrijfgebruiksscenario's. Alle artikelen bekijken →