

Ja, GPT-6 Astra-Inhalte sind in aktuellen veröffentlichten Tests nachweisbar. Zwei große Anbieterstudien kennzeichneten mehr als 99 % der unbearbeiteten, bekannten KI-Beispiele, die sie bewerteten, und ein kleinerer Vergleich ergab, dass fünf verschiedene Detektoren alle denselben Astra-Aufsatz kennzeichneten. Das ist ein starker Beweis dafür, dass eine ausgefeilte Astra-Ausgabe nicht automatisch für KI-Detektoren unsichtbar wird.
Es ist kein Beweis dafür, dass jeder Detektor jede Astra-Passage erfassen wird. Wichtiger ist, dass ein hoher Wert Ihnen nicht sagen kann, wer ein Dokument geschrieben hat, welches Modell es erstellt hat oder ob überhaupt eine Person KI verwendet hat. Die nützliche Frage ist nicht einfach „Kann KI GPT-6 Astra erkennen?“, sondern was die verfügbaren Beweise tatsächlich messen und was sie ungelöst lassen.
Kurze Antwort: Sind GPT-6 Astra-Inhalte nachweisbar?
Für unbearbeitete englische Prosa von angemessener Länge lautet die Antwort oft ja. Die stärksten öffentlichen Ergebnisse, die im Oktober 2026 verfügbar sind, weisen in dieselbe Richtung, obwohl sie von Detektorunternehmen stammen und unterschiedliche Stichproben, Schwellenwerte und Einschlussregeln verwenden.
| Veröffentlichter Test | Getestetes Astra-Material | Gemeldetes Ergebnis | Was es feststellt | Was es nicht feststellt |
|---|---|---|---|---|
| Originality.ai | 1.000 bekannte Astra-Antworten in fünf Schreibkategorien | 999 überschritten den KI-Schwellenwert | Sehr hohe Erkennung dieser bekannten KI-Stichprobe bei einer Detektoreinstellung | Falsch-Positiv-Rate oder Leistung bei menschlichem Schreiben |
| Pangram | 986 bewertete Astra-Antworten aus gefilterten Prompts | 982 KI, 3 gemischt, 1 Mensch | Sehr hohe vollständig-KI-Klassifizierungsrate für geeignete Passagen | Leistung unter dem Minimum von 50 Wörtern oder bei menschlichen Kontrollen |
| Vergleich von fünf Detektoren | Ein 300-Wörter-Astra-Aufsatz | 5 von 5 Tools kennzeichneten ihn; vier zeigten ihre maximale KI-Punktzahl an | Mehrere Detektoren stimmten bei diesem speziellen Aufsatz überein | Modellweite Genauigkeit aus einer Ein-Dokument-Stichprobe |
| Experiment zur Passagenlänge | 40 Astra-Texte in vier Längen gezeigt | 9/40 bei 25 Wörtern erkannt, 29/40 bei 50 und 40/40 bei 100 und 200 | Die Länge kann das Ergebnis eines Detektors wesentlich verändern | Eine universelle Mindestlänge für jeden Detektor |
Die praktische Erkenntnis ist einfach: Ein vollständiger Astra-Artikel erzeugt eher ein aussagekräftiges Detektorsignal als ein daraus kopierter Satz. Selbst dann bedeutet „gekennzeichnet“, dass der Text Muster aufwies, die der Detektor mit KI assoziiert. Es bedeutet nicht, dass das Tool ein verstecktes GPT-6-Label wiederhergestellt hat.
Was GPT-6 Astra ändert – und was nicht
OpenAI positioniert GPT-6 Astra als sein leistungsfähigstes Modell für anspruchsvolles Denken, Forschung, Codierung, Computernutzung und Dokumentenerstellung. Es ist darauf ausgelegt, detaillierte Anweisungen zu befolgen und komplexe Arbeiten zu unterstützen, was Entwürfe hervorbringen kann, die kohärenter und nützlicher sind als die stereotypische Chatbot-Antwort.
Die eigene Dokumentation des Modells weist auch auf eine Tendenz zu detaillierter Formatierung und wiederkehrenden Phrasen hin, es sei denn, der Benutzer gibt einen anderen Schreibstil an. Diese Beobachtung hilft zu erklären, warum verbesserte Fähigkeiten und Nachweisbarkeit nebeneinander existieren können. Ein Dokument kann genau, gut organisiert und flüssig sein und dennoch Regelmäßigkeiten aufweisen, die ein statistischer Klassifikator bemerkt.
Hier machen Menschen oft den falschen Sprung. Bessere Prosa sieht für einen Detektor nicht unbedingt menschlicher aus, da Detektoren die Prosa nicht auf Intelligenz oder Nützlichkeit bewerten. Sie schätzen, ob ihre Sprachmuster Material in ihren KI- und menschlichen Trainingsdaten ähneln.
Auch unbeholfenes Schreiben ist nicht automatisch KI-generiert. Menschen wiederholen Übergänge, verwenden formelhafte Aufsatzstrukturen und schreiben auch generische Sätze. Ein Detektor liest Muster, nicht Absicht, Autorschaft oder die Geschichte hinter dem Cursor.
Was veröffentlichte GPT-6 Astra-Erkennungstests ergaben
Die Schlagzeilenstudien sehen bemerkenswert konsistent aus. Ihre Methoden beantworten jedoch engere Fragen, als die Schlagzeilen manchmal vermuten lassen.
Originality.ai: 999 von 1.000 Antworten überschritten den Schwellenwert
Originality.ai generierte und scannte 1.000 englische Astra-Antworten: 200 Blogs, 200 Konversationsstücke, 200 erklärende Antworten, 200 Nachrichtenantworten und 200 Rezensionen. Eine Punktzahl von mindestens 0,50 im KI-Zulassungsmodus von 15 % wurde als erkannt gezählt.
Alle Blog-, Erklärungs-, Nachrichten- und Rezensionsbeispiele überschritten diesen Schwellenwert. Die Konversationskategorie ergab 199 Erkennungen von 200, was insgesamt 999 von 1.000 ergab. Das einzige Ergebnis unter dem Schwellenwert war konversatives Schreiben.
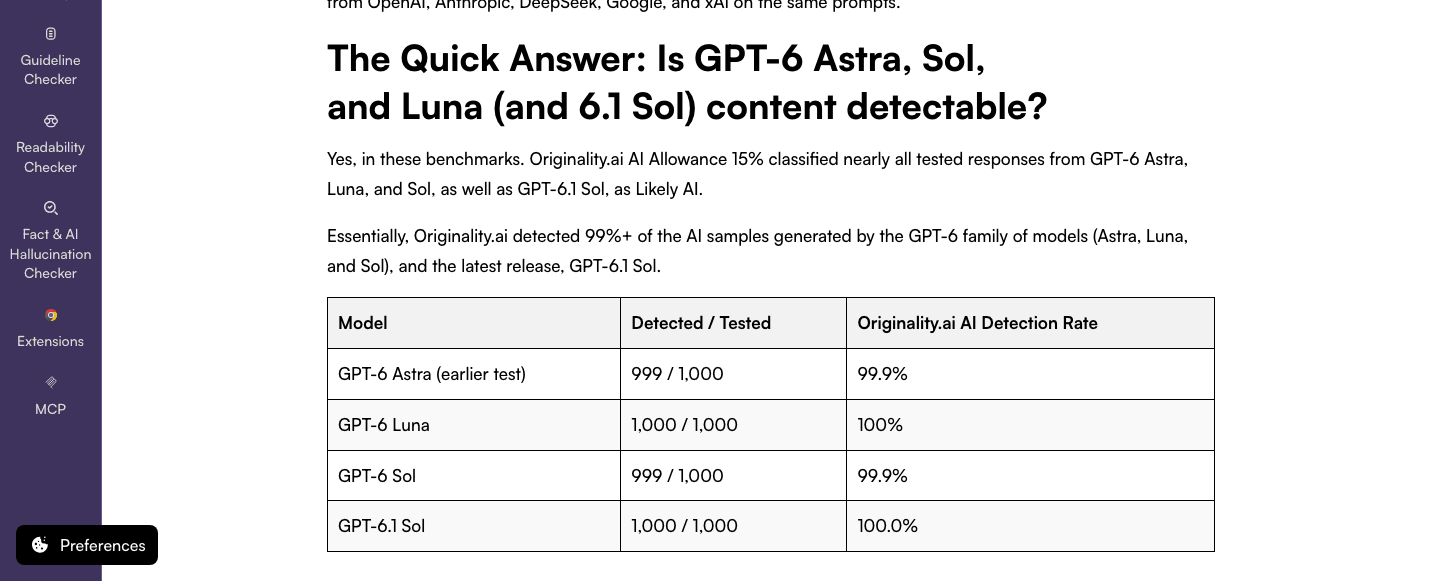
Dies ist ein starkes bekanntes KI-Erkennungsergebnis für diesen Detektor und diese Einstellung. Es ist keine vollständige Genauigkeitsstudie, da keine passende Sammlung menschlicher Texte vorhanden war. Ohne menschliche Negative kann die Studie nicht zeigen, wie oft derselbe Detektor eine Person kennzeichnen könnte.
Pangram: Vier Ausgaben wurden nicht vollständig als KI klassifiziert
Pangram begann mit 1.032 Astra-Antworten auf gefilterte erste Chatbot Arena-Prompts. Es bewertete 46 Antworten, die weniger als 50 Wörter enthielten, nicht, sodass 986 geeignete Passagen übrig blieben.
Davon wurden 982 als KI, drei als gemischt und eine als menschlich klassifiziert. Die Nicht-KI-Ergebnisse umfassten kurze oder kreative Formate wie eine E-Mail, eine Erklärung und ein Gedicht. Dieses Detail ist wichtig, da die Fehlklassifizierungen nicht gleichmäßig über eine einheitliche Reihe langer Aufsätze verteilt waren.
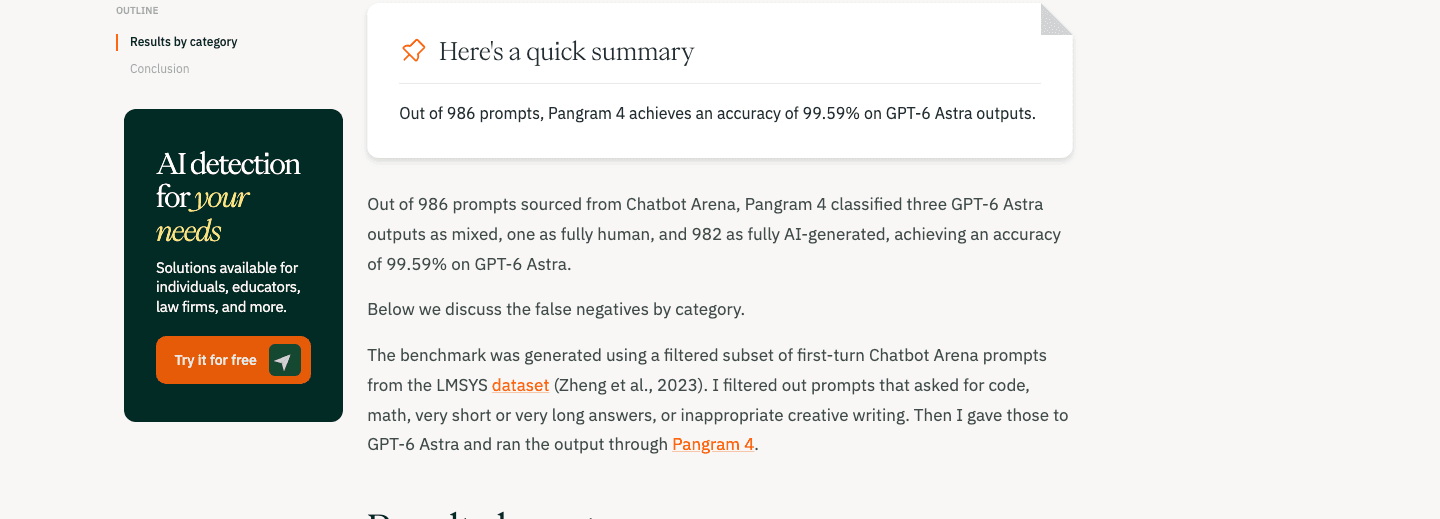
Die Studie unterstützt eine hohe Erkennungsrate für Astra-Texte, die Pangrams Längenanforderung erfüllten. Sie sagt uns nicht, wie die ausgeschlossenen kurzen Antworten bewertet worden wären, und sie enthält wiederum keine menschliche Kontrollgruppe zur Schätzung von falsch-positiven Ergebnissen.
Fünf Detektoren stimmten bei einem Astra-Aufsatz überein
Eine kleinere Studie nahm einen 300-Wörter-Astra-Aufsatz und scannte ihn mit Phrasly, GPTZero, Pangram, Copyleaks und QuillBot. Jedes Tool kennzeichnete den Aufsatz. Vier gaben ihre maximal angezeigte KI-Punktzahl zurück, während QuillBot 82 % KI zurückgab.
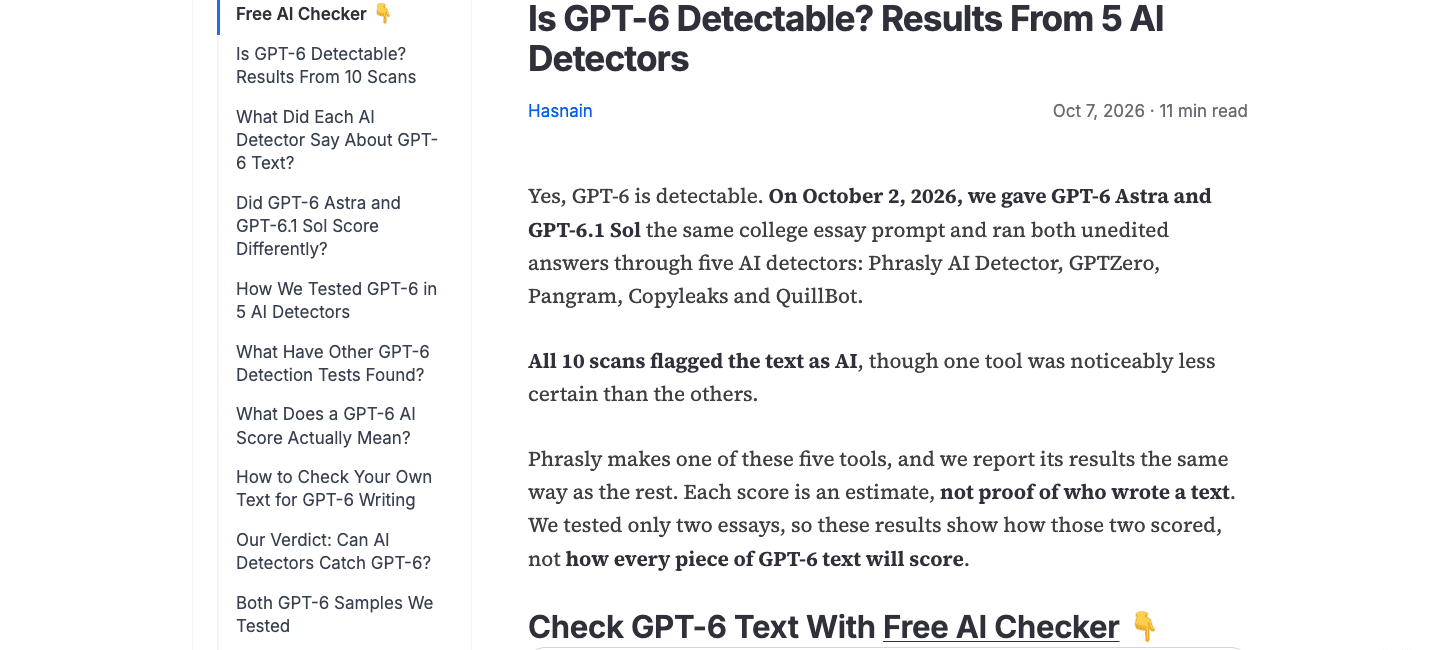
Dieser Vergleich ist nützlich, da er den Text konstant hält, während der Detektor geändert wird. Er zeigt, dass eine Übereinstimmung zwischen den Tools möglich ist, aber auch, dass ihre Prozentsätze nicht austauschbar sind. Eine 82 %-Punktzahl und eine maximale Punktzahl können zum selben praktischen Label führen, während sie von verschiedenen Modellen und Skalen stammen.
Ein Aufsatz kann die Leistung von fünf Detektoren über Blogs, E-Mails, technische Berichte und bearbeitete Entwürfe hinweg nicht feststellen. Es ist eine Momentaufnahme über verschiedene Tools hinweg, keine Rangliste.
Derselbe Text wurde bei Verkürzung schwerer zu erkennen
Das aufschlussreichste Ergebnis ist möglicherweise die kleinste Studie. Forscher nahmen 40 bekannte Astra-Passagen und zeigten demselben Detektor die ersten 25, 50, 100 oder 200 Wörter jeder Passage. Nur die Menge des sichtbaren Textes änderte sich.
Bei 25 Wörtern wurden 9 von 40 Passagen erkannt. Bei 50 Wörtern wurden 29 von 40 erkannt. Bei 100 und 200 Wörtern überschritten alle 40 den Schwellenwert.
Dies stellt keine universelle 100-Wörter-Regel auf. Es zeigt jedoch, warum das Überprüfen eines isolierten Satzes eine falsche Beruhigung hervorrufen kann: Es ist möglicherweise nicht genügend Sprache vorhanden, damit der Detektor ein stabiles Muster finden kann.
Unsere Re-Analyse: 99,9 % Erkennung ist nicht 99,9 % Genauigkeit in der realen Welt
Die veröffentlichten Zahlen ermöglichen eine nützliche unabhängige Berechnung. Ein Stichprobenergebnis ist eine Schätzung, daher haben wir ungefähre 95 % Wilson-Konfidenzintervalle neu berechnet, anstatt jeden Prozentsatz als exakt zu behandeln.
| Veröffentlichte Anzahl | Beobachtete Rate | Ungefähres 95 % Intervall | Sorgfältige Interpretation |
|---|---|---|---|
| Originality.ai: 999/1.000 | 99,90 % | 99,44 %-99,98 % | Hohe Erkennungsrate bei bekannten Astra-Stichproben unter der gemeldeten Einstellung |
| Originality.ai konversativ: 199/200 | 99,50 % | 97,22 %-99,91 % | Starkes Ergebnis, aber weniger präzise, da die Kategorie-Stichprobe kleiner ist |
| Pangram vollständig KI: 982/986 | 99,59 % | 98,96 %-99,84 % | Hohe vollständig-KI-Klassifizierungsrate unter den geeigneten bewerteten Ausgaben |
Diese Intervalle untermauern die Schlussfolgerung, dass die gemeldeten bekannten KI-Erkennungsraten hoch waren. Sie füllen die fehlende Hälfte des Experiments nicht aus.
Um einen Detektor in der realen Welt zu messen, benötigen wir sowohl KI- als auch menschliche Dokumente. Das ist der einzige Weg, um zu sehen, ob ein Tool KI erkennt, ohne auch zu viele Menschen zu beschuldigen.
| Metrik | Können die Astra-only-Studien sie berechnen? | Warum es wichtig ist |
|---|---|---|
| Erkennungsrate bei bekanntem KI-Text | Ja | Zeigt, wie oft das Tool die ihm gegebenen KI-Stichproben erfasst |
| Falsch-Negativ-Rate | Ja | Zeigt, wie viele bekannte KI-Stichproben unter den Testregeln übersehen wurden |
| Spezifität | Nein | Erfordert menschlichen Text, um zu messen, wie oft menschliche Arbeit korrekt freigegeben wird |
| Falsch-Positiv-Rate | Nein | Erfordert menschlichen Text, um zu zählen, wie oft Menschen fälschlicherweise gekennzeichnet werden |
| Präzision | Nein | Hängt sowohl von falsch-positiven Ergebnissen als auch davon ab, wie häufig KI-Text in der überprüften Population vorkommt |
| Gesamtgenauigkeit | Nein | Erfordert sowohl positive als auch negative Beispiele sowie eine definierte Klassenbalance |
999 von 1.000 als „99,9 % Genauigkeit“ zu bezeichnen, setzt stillschweigend voraus, dass der einzige mögliche Fehler das Übersehen von KI ist. In einem Klassenzimmer, einer Nachrichtenredaktion oder einem Einstellungsprozess ist das fälschliche Kennzeichnen eines Menschen ein anderer und oft folgenreicherer Fehler. Die Astra-only-Tests waren nicht darauf ausgelegt, dies zu messen.
Warum derselbe GPT-6 Astra-Text unterschiedliche Bewertungen erhalten kann
Detektorergebnisse sind empfindlich gegenüber dem vorliegenden Dokument. Ein Modellname allein kann die endgültige Punktzahl nicht vorhersagen.
Die Passagenlänge ändert das verfügbare Signal. Eine 20-Wörter-E-Mail und ein 1.000-Wörter-Bericht können vom selben Modell stammen, bieten aber sehr unterschiedliche Mengen an Beweisen. Niedrige Punktzahlen bei kurzen Auszügen verdienen eine besonders vorsichtige Interpretation.
Das Genre ändert das Sprachmuster. Im Test von Originality.ai enthielt konversatives Schreiben den einzigen Fehler. Pangrams nicht vollständig-KI-Klassifizierungen umfassten Formate wie ein Gedicht, eine E-Mail und eine kurze Erklärung. Ein auf Aufsätze kalibrierter Detektor kann sich bei Dialogen oder kreativer Prosa anders verhalten.
Der Prompt prägt die Ausgabe. Astra kann detaillierte Einschränkungen bezüglich Ton, Struktur, Zielgruppe und Beispielen befolgen. Zwei Personen, die dasselbe Modell verwenden, können Texte mit sehr unterschiedlichem Rhythmus und Spezifität erhalten.
Detektorversionen und Schwellenwerte unterscheiden sich. Jedes Tool definiert seine eigenen Labels, Trainingsdaten, Mindestlänge und Entscheidungsschwelle. Ein Prozentsatz von einem Dienst ist keine Punktzahl, die Sie Punkt für Punkt mit einem anderen vergleichen können.
Menschliche Bearbeitung ändert den zu überprüfenden Text. Das Hinzufügen origineller Beweise, das Neuordnen eines Arguments, das Korrigieren von Fakten und das Umschreiben aus persönlichem Wissen können das statistische Muster verändern. Das liefert kein zuverlässiges Rezept zur Vermeidung der Erkennung und beseitigt nicht die Notwendigkeit, die KI-Nutzung offenzulegen, wenn eine Richtlinie dies erfordert.
Kann ein Detektor erkennen, dass GPT-6 Astra es geschrieben hat?
Nein. Ein typischer Textdetektor identifiziert nicht das genaue Modell, das eine Passage erstellt hat. Keines der fünf Tools im Detektorvergleich nannte Astra; sie gaben Varianten von KI, gemischt, menschlich oder eine Wahrscheinlichkeitspunktzahl zurück.
| Frage | Kann ein Textdetektor sie beantworten? |
|---|---|
| Ähnelt diese Passage Mustern, die mit KI-Schreiben assoziiert werden? | Er kann dies mit Unsicherheit schätzen. |
| War KI irgendwo im Schreibprozess beteiligt? | Nicht zuverlässig allein aus dem endgültigen Text. |
| Hat GPT-6 Astra diese Passage speziell erstellt? | Nein. Die Punktzahl identifiziert nicht das genaue Modell. |
| Wer hat den Prompt eingegeben oder die Ausgabe bearbeitet? | Nein. Diese Historie liegt außerhalb des Textes. |
| Verstößt das Dokument gegen eine Schul- oder Arbeitsplatzrichtlinie? | Nein. Das erfordert die Richtlinie, den Kontext und menschliches Urteilsvermögen. |
Die am besten vertretbare Formulierung ist daher „die Passage wurde als KI-ähnlich gekennzeichnet“, nicht „der Detektor bewies, dass dies von GPT-6 Astra geschrieben wurde“.
So überprüfen Sie GPT-6 Astra-Text mit Lynote
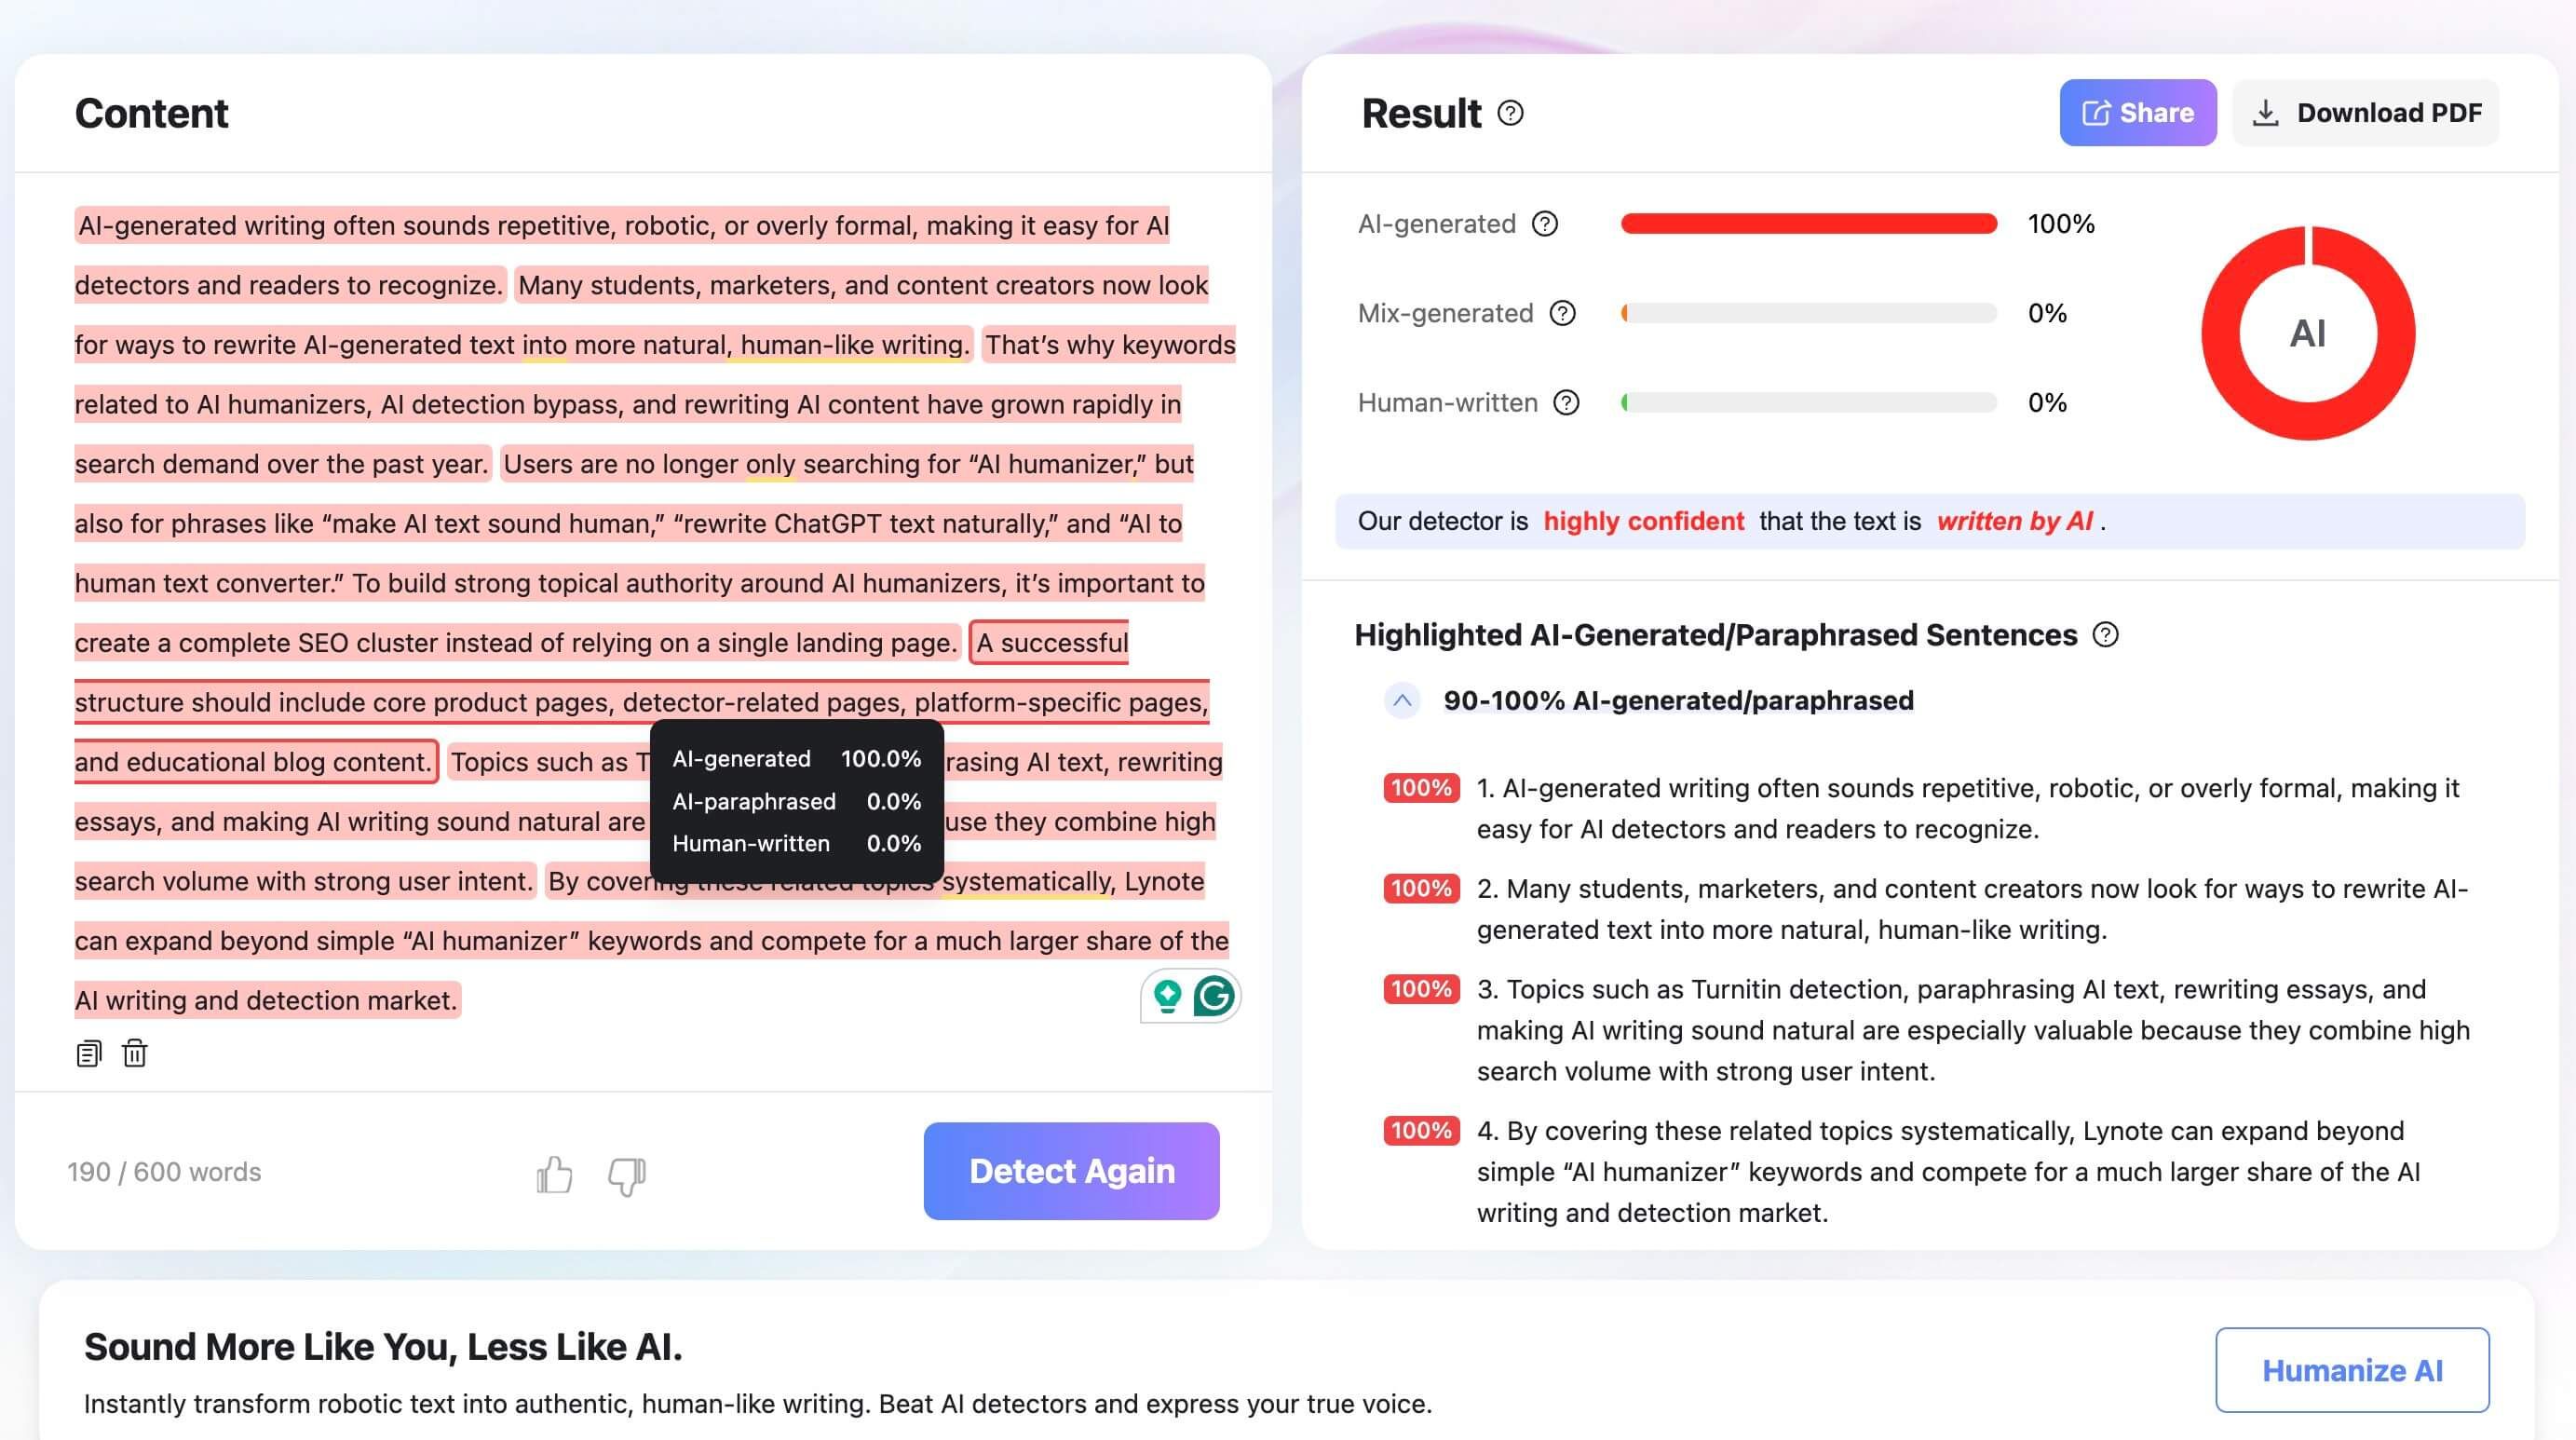
Wenn Sie einen vollständigen Entwurf überprüfen möchten, anstatt aus ein paar Sätzen zu raten, bietet der Lynote AI Detector einen einfachen ersten Arbeitsablauf. Er trennt sein Ergebnis in KI-generierte, gemischte und von Menschen geschriebene Prozentsätze und hebt Sätze zur genaueren Überprüfung hervor.
-
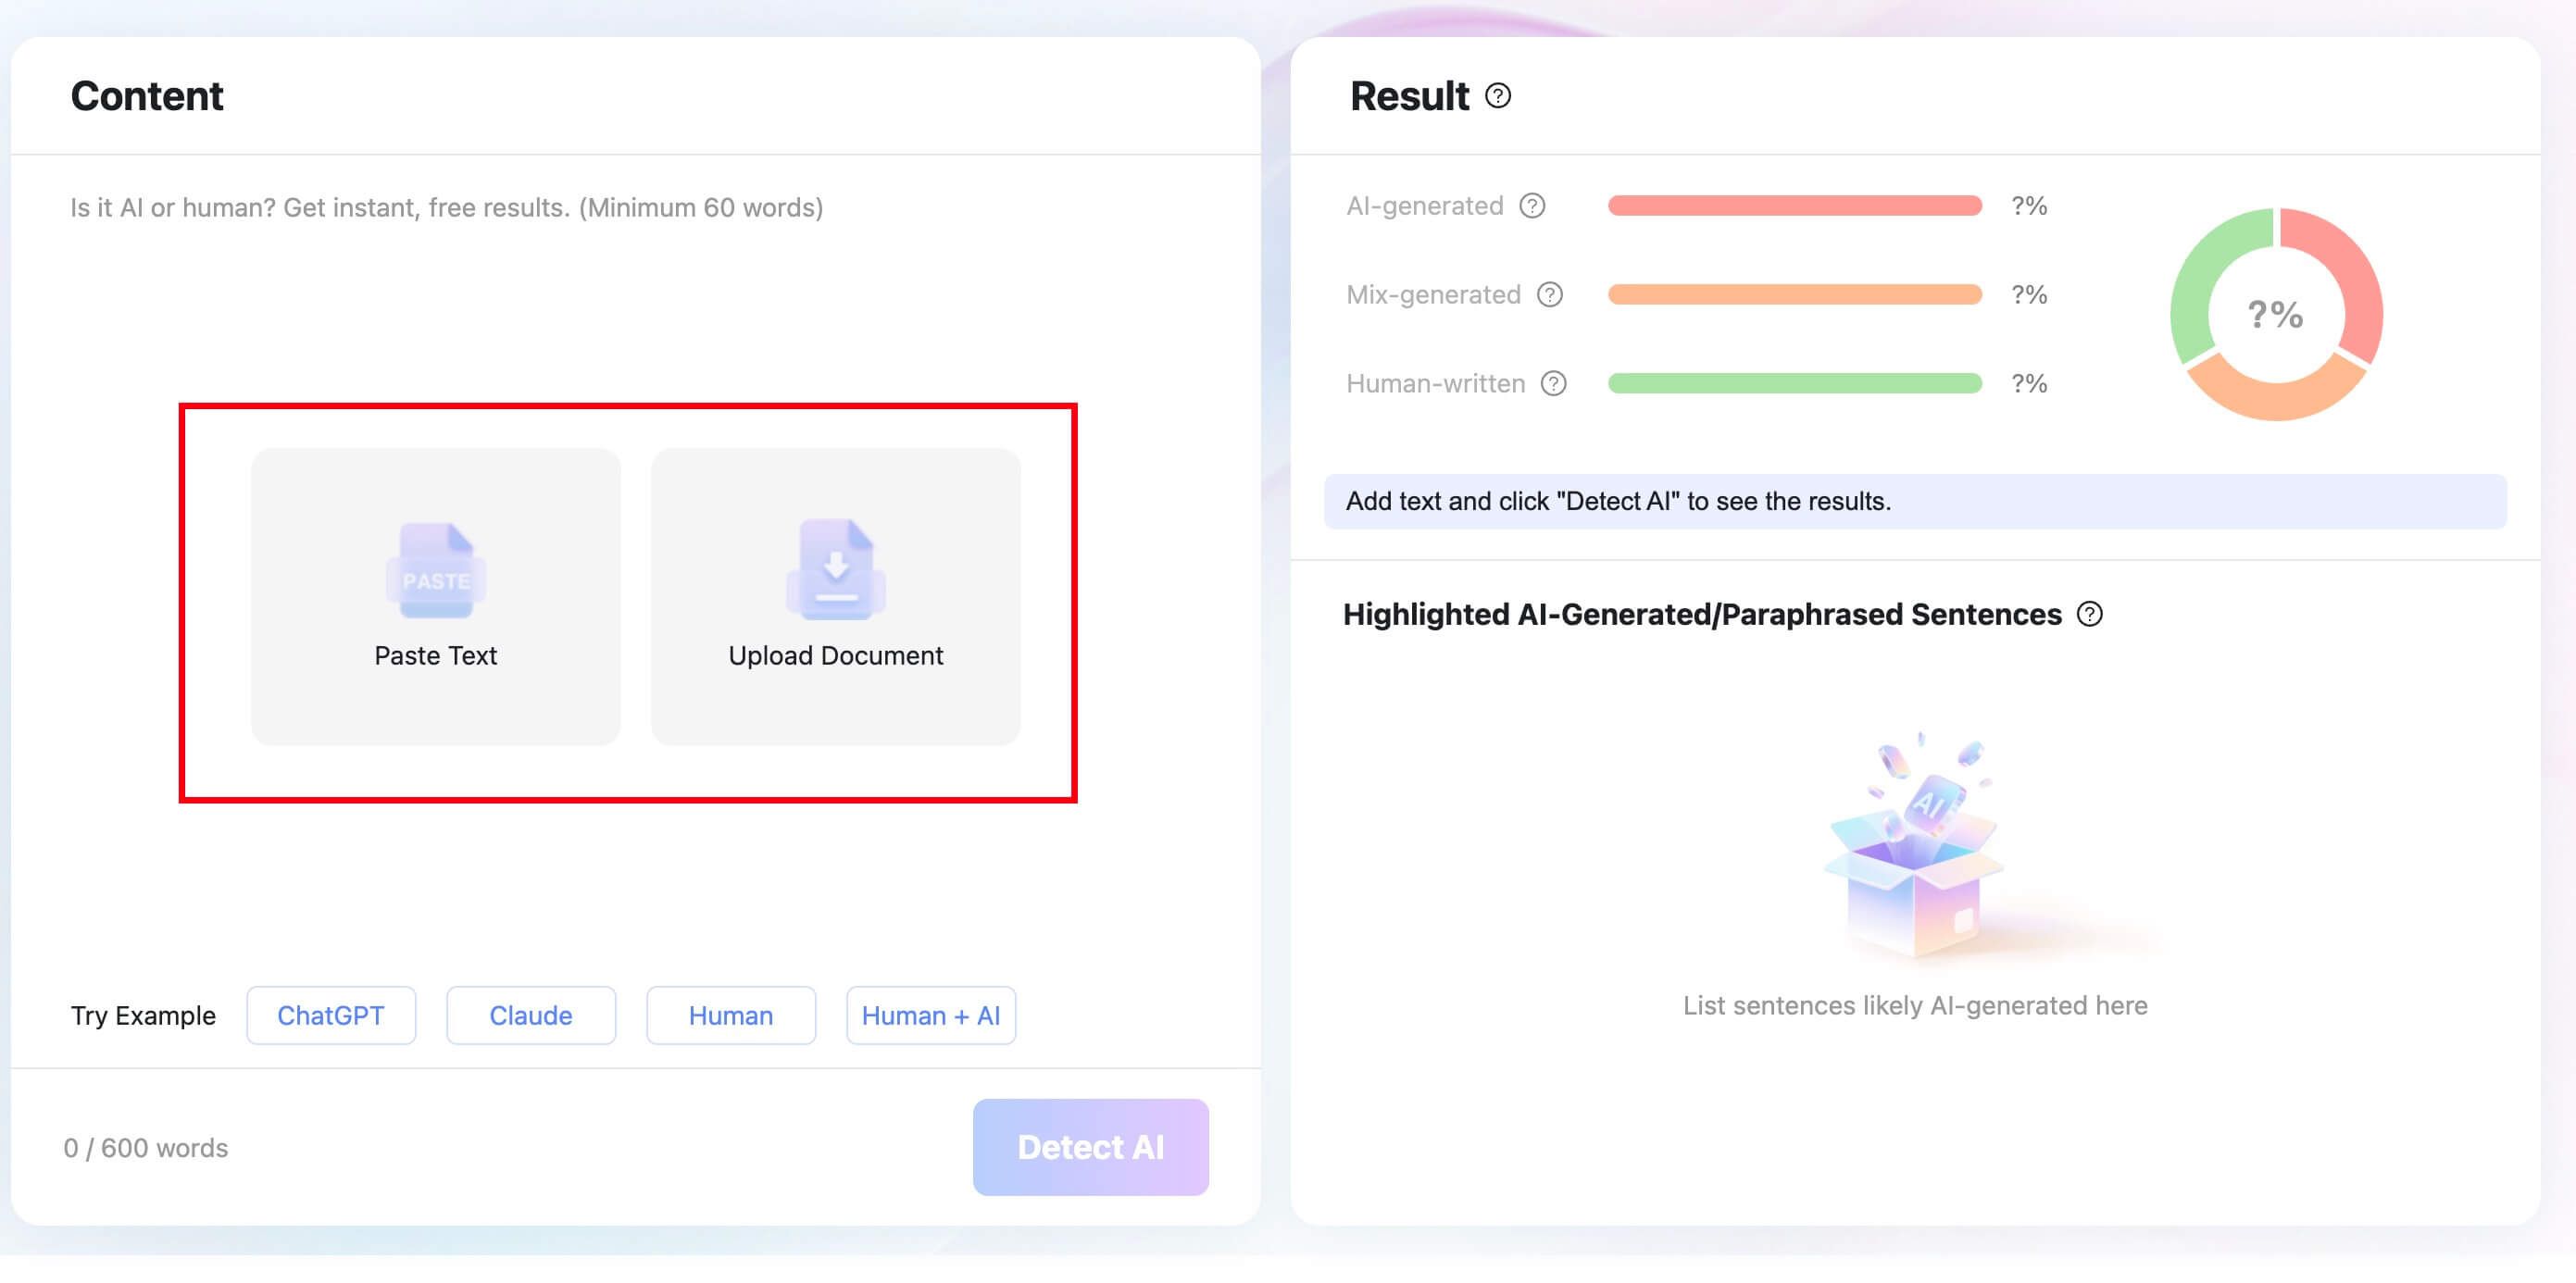
Fügen Sie den Text ein oder laden Sie ein Dokument hoch. Verwenden Sie das Textfeld für eine schnelle Überprüfung oder laden Sie eine unterstützte DOCX-, PDF- oder TXT-Datei hoch. Reichen Sie nach Möglichkeit einen aussagekräftigen Abschnitt statt einer isolierten Zeile ein.
-
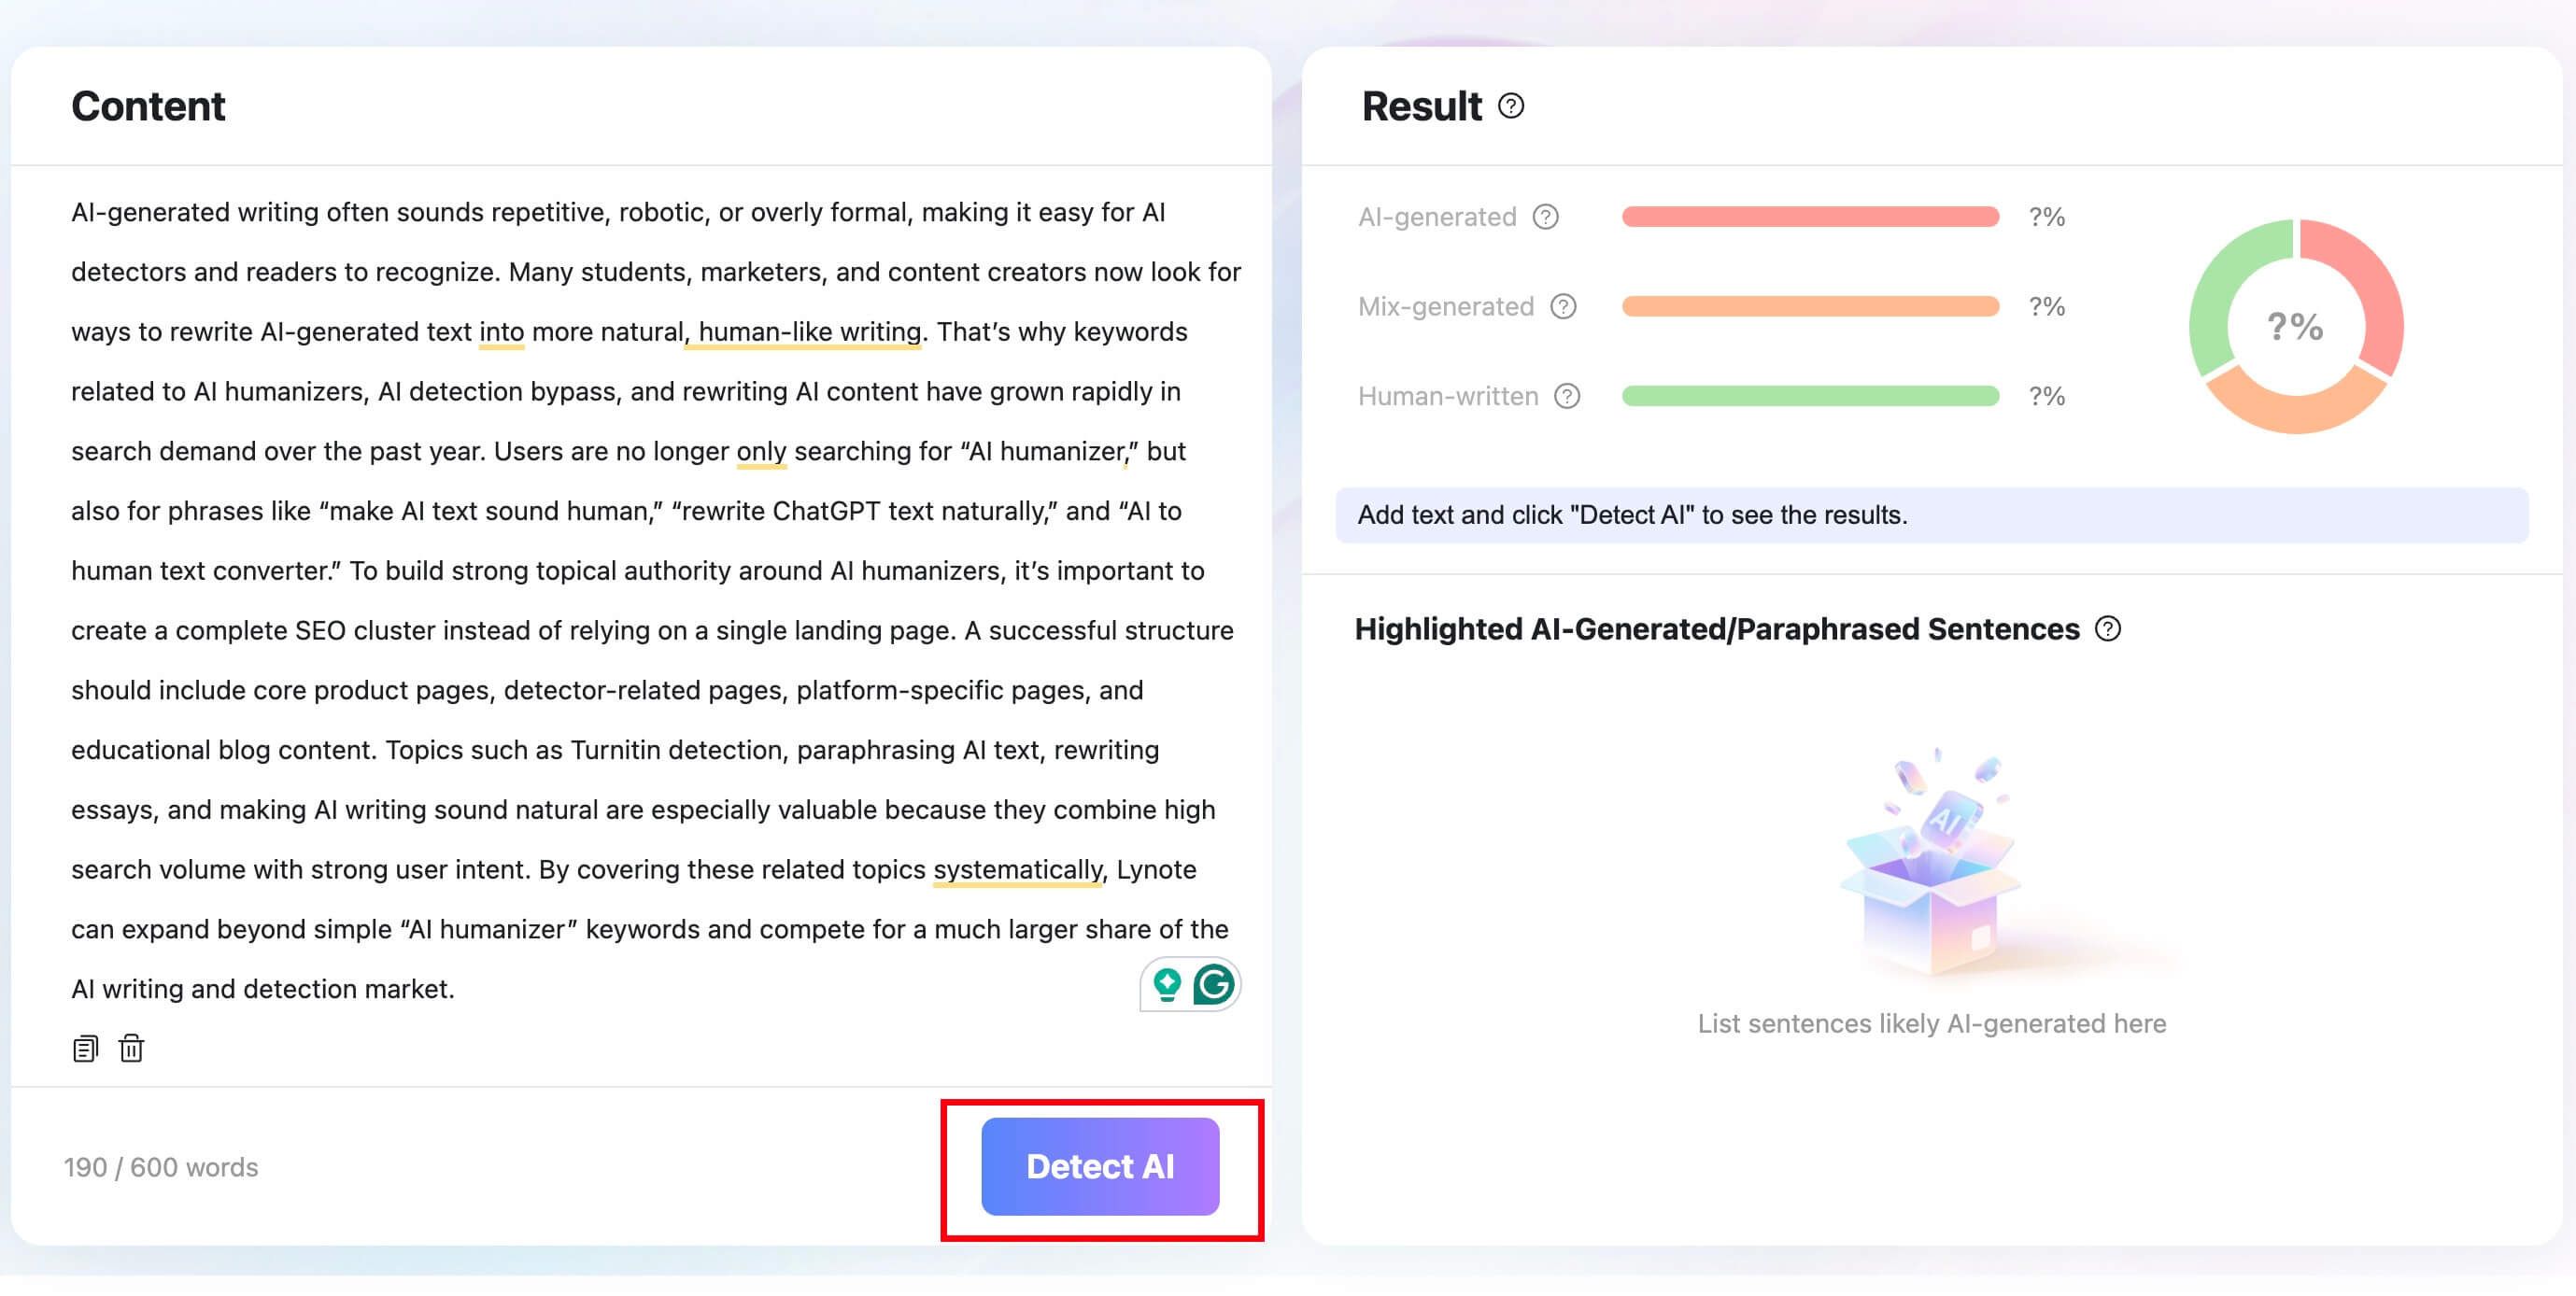
Führen Sie den Scan aus. Klicken Sie auf KI erkennen und lassen Sie das Tool den übermittelten Text analysieren.
-
Überprüfen Sie das vollständige Ergebnis. Lesen Sie die KI-, gemischten und menschlichen Prozentsätze zusammen und überprüfen Sie dann die hervorgehobenen Sätze, anstatt nur auf die größte Zahl zu reagieren.
-
Vergleichen Sie das Signal mit Beweisen außerhalb des Detektors. Betrachten Sie Entwürfe, Versionshistorie, zitierte Quellen, Notizen und die Erklärung des Autors, bevor Sie eine Schlussfolgerung ziehen.
Das Ergebnis kann Ihnen sagen, wo Sie suchen müssen. Es kann Ihnen nicht sagen, wer das Dokument geschrieben hat oder ob die Verwendung von KI erlaubt war.

So interpretieren Sie eine hohe oder niedrige KI-Punktzahl
Eine Punktzahl wird nur dann nützlich, wenn sie ändert, was Sie als Nächstes überprüfen.
| Wenn die Punktzahl hoch ist | Wenn die Punktzahl niedrig ist |
|---|---|
| Lesen Sie die hervorgehobenen Passagen im Kontext. | Behandeln Sie das Ergebnis nicht als Beweis dafür, dass eine Person es geschrieben hat. |
| Überprüfen Sie Behauptungen, Zitate, Beispiele und ungewöhnliche Stimmungswechsel. | Überprüfen Sie, ob die Passage zu kurz für ein stabiles Ergebnis ist. |
| Vergleichen Sie das Dokument mit früheren Entwürfen oder der Versionshistorie. | Denken Sie daran, dass Detektoren KI-Text übersehen können und Modellaktualisierungen die Leistung ändern können. |
| Fragen Sie den Autor nach dem Prozess, anstatt die Punktzahl als Urteil zu präsentieren. | Verwenden Sie andere Beweise, wenn Autorschaft oder Richtlinienkonformität wichtig sind. |
| Fordern Sie eine zweite menschliche Überprüfung für wichtige Entscheidungen an. | Vermeiden Sie es, das Dokument nach einem Scan als „menschlich verifiziert“ zu deklarieren. |
Für Autoren, die ihre eigene Arbeit überprüfen, ist eine hohe Punktzahl keine Anweisung, zufällige Ersetzungen vorzunehmen oder absichtliche Fehler hinzuzufügen. Eine bessere Reaktion ist, jede Behauptung zu überprüfen, generisches Füllmaterial durch spezifische Beweise zu ersetzen und sicherzustellen, dass das endgültige Argument Ihr eigenes Verständnis widerspiegelt.
Für Pädagogen und Redakteure sollte der Detektor eine Überprüfung beginnen, nicht beenden. Prozessbeweise sagen oft mehr aus als eine Wahrscheinlichkeit, die dem endgültigen Entwurf beigefügt ist.
Das Problem der falsch-positiven Ergebnisse ist immer noch wichtig
Hohe Erkennungsraten für bekannte KI und falsch-positive Ergebnisse können gleichzeitig existieren. Ein Detektor kann fast jede Astra-Stichprobe in einem Benchmark erfassen, während er immer noch Schwierigkeiten mit bestimmten Arten menschlichen Schreibens hat.
Stanford-Forscher fanden zuvor heraus, dass weit verbreitete GPT-Detektoren Texte von nicht-muttersprachlichen englischen Autoren häufig falsch klassifizierten. Eine neuere Studie aus dem Jahr 2026 untersuchte 135.389 Paare von von Menschen geschriebenen Manuskripten vor und nach professioneller englischer Bearbeitung. Über 13 Detektoren hinweg erstreckten sich die gemeldeten falsch-positiven Raten über den gesamten möglichen Bereich, und dieselben Bearbeitungsänderungen drängten verschiedene Detektoren in entgegengesetzte Richtungen.
Das bedeutet nicht, dass jeder Detektor nutzlos ist. Es bedeutet, dass der Stil eine störende Variable werden kann: formale Formulierungen, konsistente Grammatik, begrenzter Wortschatz oder professionelle Bearbeitung können eine Punktzahl beeinflussen, auch wenn sich die Autorschaft nicht geändert hat.
Turnitins eigene Anleitung spiegelt diese Unsicherheit wider. Sie beschreibt ihren KI-Bericht als einen Datenpunkt und sagt, dass er nicht dazu gedacht ist, isoliert definitive Antworten zu liefern.
Das ist auch außerhalb der Bildung ein vernünftiger Ratschlag. Eine Note, ein Job, eine Veröffentlichungsentscheidung oder eine Anschuldigung sollten nicht auf einem undurchsichtigen Prozentsatz beruhen.
FAQs zur GPT-6 Astra KI-Erkennung
Kann Turnitin GPT-6 Astra erkennen?
Turnitin kann Text kennzeichnen, der von neueren Sprachmodellen generiert wurde, wenn der Text Muster aufweist, die sein System mit KI assoziiert. Es gibt jedoch keine öffentliche Astra-spezifische Turnitin-Benchmark, die für diesen Artikel überprüft wurde und eine Erkennungsrate festlegt, und Turnitin sagt, dass sein Bericht nicht als definitive Antwort allein verwendet werden sollte.
Kann ein KI-Detektor GPT-6 Astra spezifisch identifizieren?
Nein. Aktuelle Detektorergebnisse schätzen im Allgemeinen, ob Text KI-generiert, gemischt oder menschenähnlich aussieht. Sie identifizieren Astra nicht zuverlässig als das genaue Modell oder enthüllen den Prompt und die Bearbeitungshistorie.
Ändert die Bearbeitung von GPT-6 Astra-Text seine Punktzahl?
Das kann sie. Eine sinnvolle menschliche Bearbeitung ändert Wortlaut, Struktur, Beweise und Stimme, was die Musterschätzung eines Detektors verändern kann. Die Richtung ist unvorhersehbar, und die Bearbeitung sollte die Genauigkeit und Autorschaftsqualität verbessern, anstatt darauf abzuzielen, eine Punktzahl zu manipulieren.
Wie viel Text benötigt ein Detektor?
Die Anforderungen variieren je nach Tool. In einem Astra-Experiment stieg die Erkennung derselben Passagen von 9 von 40 bei 25 Wörtern auf 29 von 40 bei 50 Wörtern und alle 40 bei 100 Wörtern. Dieses Ergebnis gehört zu einem Detektor, aber es zeigt, warum eine vollständige Passage informativer ist als ein Satz.
Ist die höchstmögliche KI-Punktzahl ein Beweis dafür, dass Astra den Text geschrieben hat?
Nein. Es ist die stärkste Klassifizierung des Detektors unter seinem eigenen Modell und seiner Skala. Es beweist nicht, welches KI-Modell verwendet wurde, wer es verwendet hat oder ob eine Person das Dokument wesentlich bearbeitet hat.
Kann menschliches Schreiben als GPT-6-Inhalt gekennzeichnet werden?
Menschliches Schreiben kann eine KI-ähnliche Punktzahl erhalten, insbesondere wenn ein Detektor auf den Stil statt auf den Ursprung reagiert. Nicht-muttersprachliches englisches Schreiben, hochstandardisierte akademische Prosa und professionell bearbeiteter Text verdienen besondere Vorsicht, da die Forschung inkonsistente falsch-positive Ergebnisse dokumentiert hat.
Ist eine niedrige Punktzahl ein Beweis dafür, dass ein Mensch den Text geschrieben hat?
Nein. Eine niedrige Punktzahl bedeutet, dass der Detektor nicht genügend KI-assoziierte Beweise gefunden hat, um seinen Schwellenwert zu überschreiten. Kurze Passagen, ungewöhnliche Genres und bearbeitete KI-Ausgaben können alle die Erkennungssicherheit verringern.
Endgültiges Urteil
GPT-6 Astra ist in den bisher stärksten veröffentlichten Tests nachweisbar. Originality.ai kennzeichnete 999 von 1.000 bekannten Astra-Ausgaben, Pangram klassifizierte 982 von 986 geeigneten Ausgaben vollständig als KI, und fünf separate Detektoren stimmten bei einem unbearbeiteten Astra-Aufsatz überein.
Diese Ergebnisse stützen eine enge Schlussfolgerung: Aktuelle Detektoren können unbearbeitete, lange Astra-Prosa oft erkennen. Sie zeigen nicht, dass jeder Detektor gleichermaßen zuverlässig ist, dass kurze oder bearbeitete Texte sich auf die gleiche Weise verhalten werden oder dass eine Punktzahl die Autorschaft beweist.
Nutzen Sie die KI-Erkennung als Triage. Geben Sie dem Tool genügend Text, lesen Sie die hervorgehobenen Passagen und überprüfen Sie dann die Beweise, die ein Klassifikator nicht sehen kann: Entwürfe, Quellen, Kontext, Schreibhistorie und die Person hinter der Arbeit.
Verfasst von Danny
Produktmarketing-Manager
Danny erklärt, wie Lynote-Funktionen in reale Arbeitsabläufe passen, von der alltäglichen Produktivität bis hin zu produktgesteuerten Schreib-Anwendungsfällen. Alle Artikel ansehen →