
ChatGPT 無法從 PDF 提取文字?這才是真正原因及 3 步解決方案

您有一個完美的 PDF 檔案——一份密集的學術論文、一份掃描的客戶合約,或教科書中的一個章節。您將其上傳到 ChatGPT,準備進行摘要或分析,然後卻碰壁了:「無法從此檔案中提取文字。」 這是一個令人沮喪的常見障礙,會讓您的工作流程停滯不前。如果您一直盯著這個錯誤訊息,您並不孤單,問題不在於您——而是對 ChatGPT 的設計用途存在根本性的誤解。
核心問題在於 ChatGPT 是一個語言模型,而不是通用的文件轉換器。它擅長處理清晰的數位文字。然而,許多 PDF,尤其是掃描件或複雜的報告,本質上是文字的圖像,而不是文字本身。ChatGPT 缺乏內建的光學字元辨識 (OCR) 功能來「讀取」這些基於圖像的文件。這就像要求一位看不見的傑出語言學家描述一本圖書頁面的照片一樣。本指南將詳細解釋為什麼會發生此錯誤,並為您提供一個可靠的三步驟解決方案,以獲取您所需的文字。
快速判斷:ChatGPT 與專用 PDF 文字擷取工具的比較
對於時間緊迫的人來說,重點如下。您從 PDF 中獲取文字的方法完全取決於您擁有的 PDF 類型。它是一個簡單的、基於文字的文件,還是一個棘手的、掃描的圖像?
此表格比較了使用 ChatGPT 的原生功能與使用專用工具的選擇。
| 功能 / 情境 | ChatGPT (原生上傳) | 專用 OCR 擷取工具 (例如 Lynote) |
|---|---|---|
| 掃描/僅圖像 PDF | 失敗 (分數:1/5) | 優秀 (分數:5/5) |
| 多欄佈局 | 時好時壞;常會打亂文字 | 良好;保留閱讀順序 |
| 受密碼保護的檔案 | 失敗 (分數:1/5) | 失敗 (基於安全設計) |
| 速度 (對於清晰的 PDF) | 對於簡短、簡單的檔案很快 | 很快;針對大量批次處理進行優化 |
| 最佳使用案例 | 分析簡單的、數位原生 PDF (例如,匯出的 Word 文件) | 從掃描件、文件照片或複雜佈局中擷取文字 |
分數為編輯啟發式評分 (1=差,5=優),而非測量基準。
結論很簡單:如果您的 PDF 是直接從文字編輯器 (例如 Microsoft Word 或 Google Docs) 建立的,ChatGPT 可能可以處理。對於其他任何情況——尤其是已經掃描、拍照或經過精心設計的文件——您需要一個具有專用 OCR 引擎的工具。
ChatGPT 無法讀取您的 PDF 的 4 個主要原因
您可能想知道:「如果我能在螢幕上看到文字,為什麼 ChatGPT 看不到?」答案在於 PDF 的建構方式。PDF 並不總是看起來那樣。以下是導致可怕的擷取錯誤的四個主要原因。
1. 僅圖像或掃描的 PDF (最大的罪魁禍首)
這是迄今為止最常見的失敗原因。當您掃描實體文件或將檔案儲存為「圖像 PDF」時,您並不是在儲存文字。您是在儲存頁面的照片。對於電腦來說,該檔案中的字母與樹木圖片中的像素沒有什麼不同。
- 情境: 您是一名學生,試圖分析教授從圖書館書籍中掃描的 30 頁期刊文章。您將其上傳,而 ChatGPT 看到的只是一堆圖像。
- 技術障礙: 如果沒有光學字元辨識 (OCR)——一種分析圖像以識別並將字元轉換為數位文字的過程——ChatGPT 對內容是盲目的。它需要一個文字「圖層」來讀取,而掃描的 PDF 沒有這個圖層。
2. 複雜的佈局和格式
PDF 非常適合保留視覺設計——欄位、表格、頁首、頁尾和浮動圖像。這種優勢對於文字擷取來說也是一個弱點。ChatGPT 的內建解析器是基本的;它期望一個直接、線性的文字流。
- 情境: 您是一名商業分析師,擁有一份市場研究報告,其中包含兩欄文字、帶有註釋的圖表和數據表格。當 ChatGPT 試圖讀取它時,來自欄位的文字會交錯,將連貫的句子變成亂碼。
The company's growth in Q3 was a result of the new marketing... remarkable, reaching 5 million units... strategy that focused on social media. - 技術障礙: 解析器無法區分欄位斷裂和段落結尾。它根據文字在頁面上的位置而不是其邏輯流程來讀取文字,導致混亂。
3. 受密碼保護或加密的檔案
這個比較直接。如果 PDF 需要密碼才能打開或對複製文字有限制,ChatGPT 將會遵守這些安全設定。它不會 (也無法) 嘗試繞過它們。
- 情境: 一位同事透過電子郵件向您發送一份敏感的、受密碼保護的財務報告以供分析。您不能只是上傳它並期望 ChatGPT 能夠破解它。
- 技術障礙: 檔案的內容已加密。在用正確的密碼解鎖之前,任何應用程式,包括 AI 模型,都無法讀取數據。
4. 檔案損壞或非標準編碼
雖然較不常見,但仍有可能,PDF 檔案本身可能已損壞或使用 ChatGPT 解析器無法識別的異常文字編碼。這可能發生在下載不良、檔案轉換錯誤或處理非常舊的文件時。文字圖層可能在技術上存在,但它以一種使其無法存取的方式被打亂了。
總結: 專用工具在 PDF 擷取方面優於 ChatGPT 的主要原因在於其內建的光學字元辨識 (OCR) 引擎,該引擎專門設計用於將文字圖像轉換為 AI 可以理解的機器可讀字元。
解決方案:如何透過 3 個步驟可靠地從任何 PDF 中擷取文字
當 ChatGPT 失敗時,不要浪費時間嘗試不同的提示或重新上傳相同的檔案。解決方案是使用專為此任務設計的工具預處理 PDF。使用具有強大 OCR 引擎的 AI 驅動轉錄和數據擷取工具是向前邁進最可靠的途徑。
以下是如何使用 Lynote AI Transcription 等工具在不到一分鐘的時間內完成此操作,該工具提供基本免費使用,無需帳戶即可開始。
步驟 1. 上傳您的問題 PDF 檔案
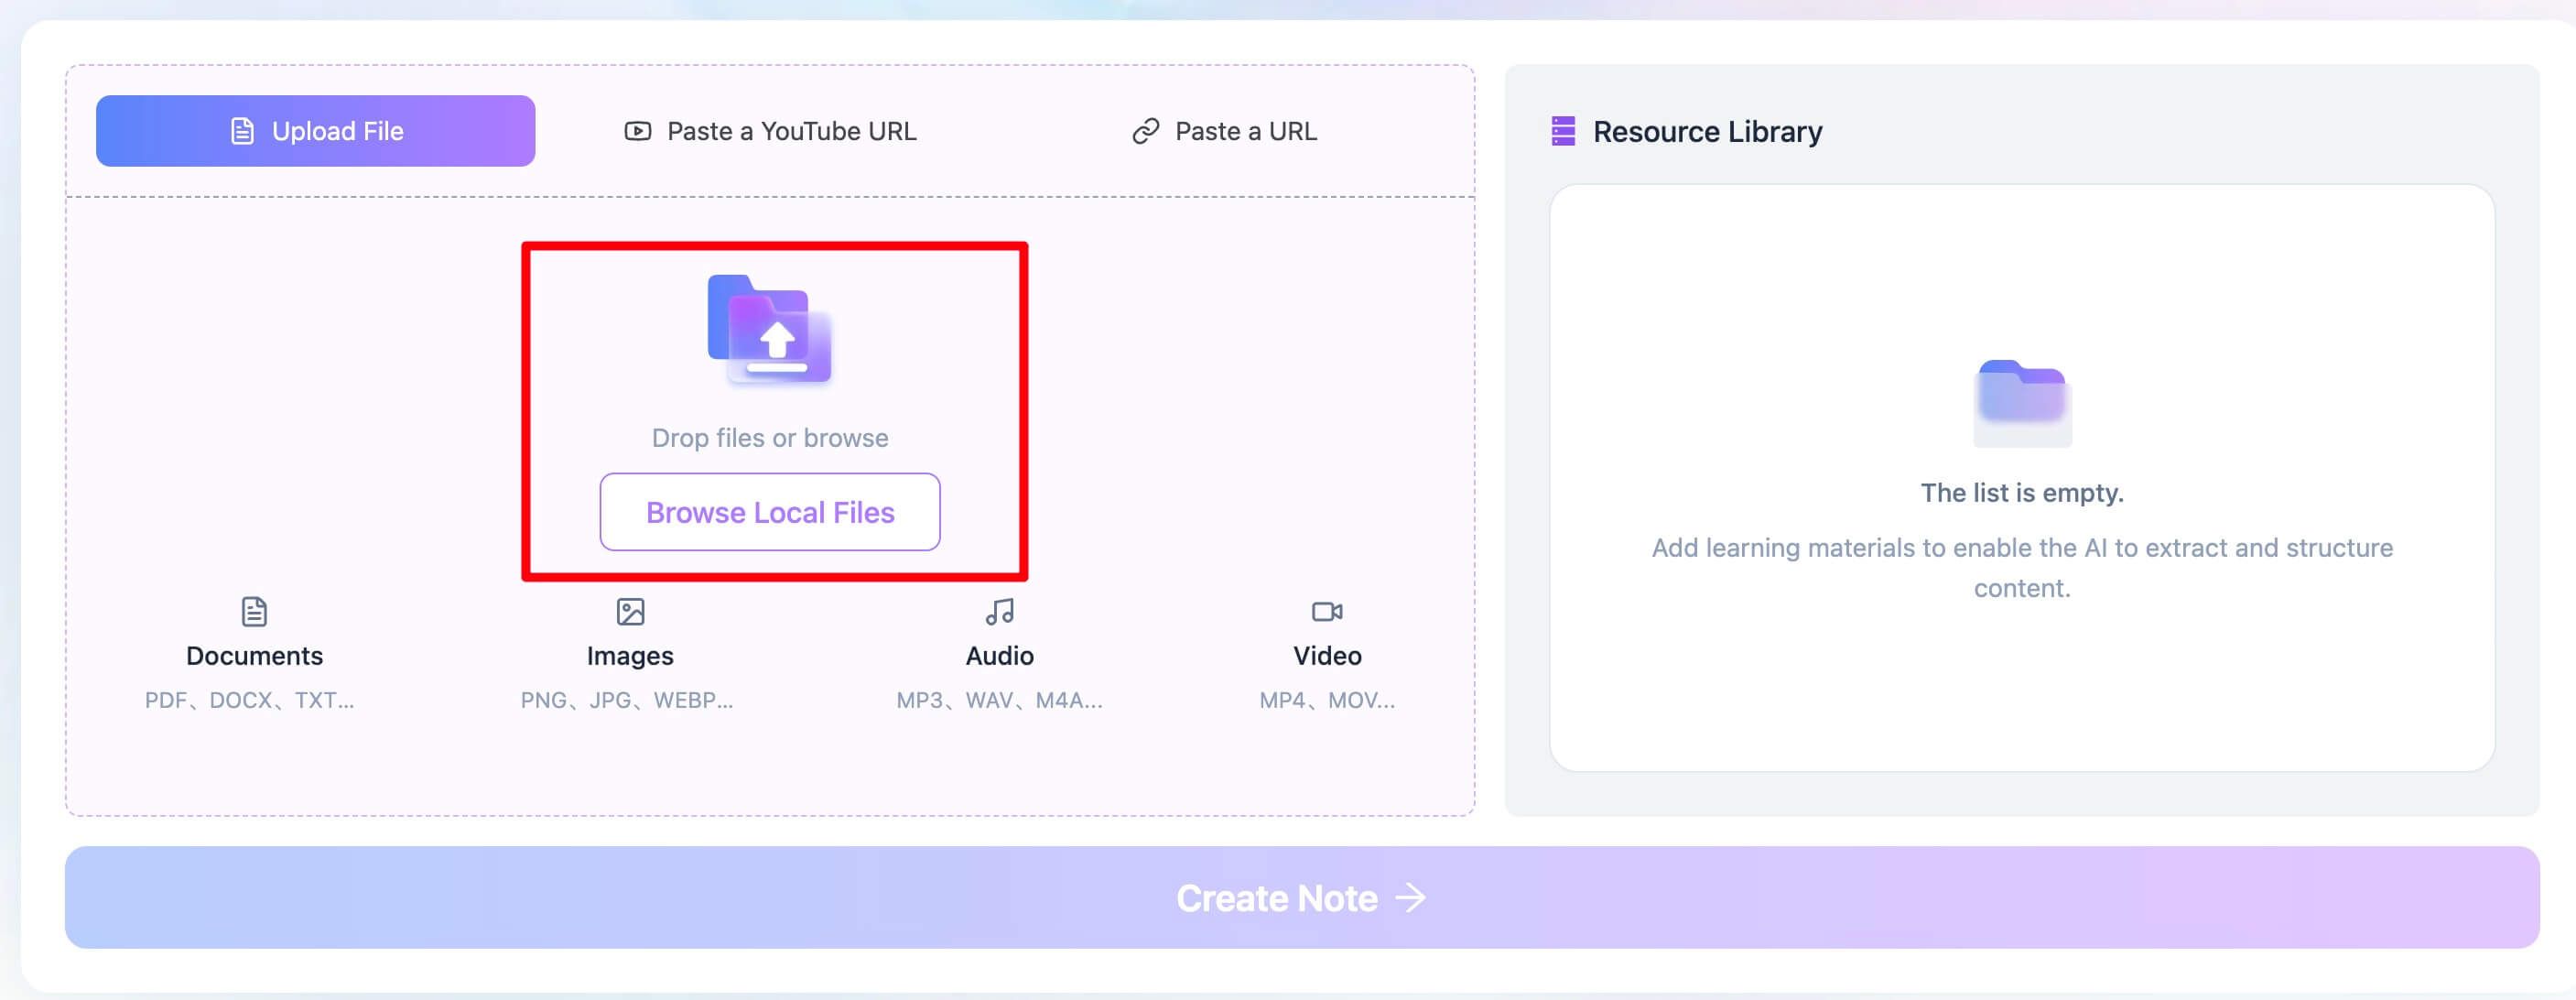
首先,前往 Lynote PDF 文字擷取工具。不要將檔案上傳到 ChatGPT,而是將有問題的 PDF 直接拖放到 Lynote 上傳區域。您也可以點擊瀏覽您的電腦並選擇檔案。這對於那些掃描的講義、複雜的報告或 ChatGPT 立即拒絕的基於圖像的文件來說非常有效。
步驟 2. 從 PDF 中擷取文字
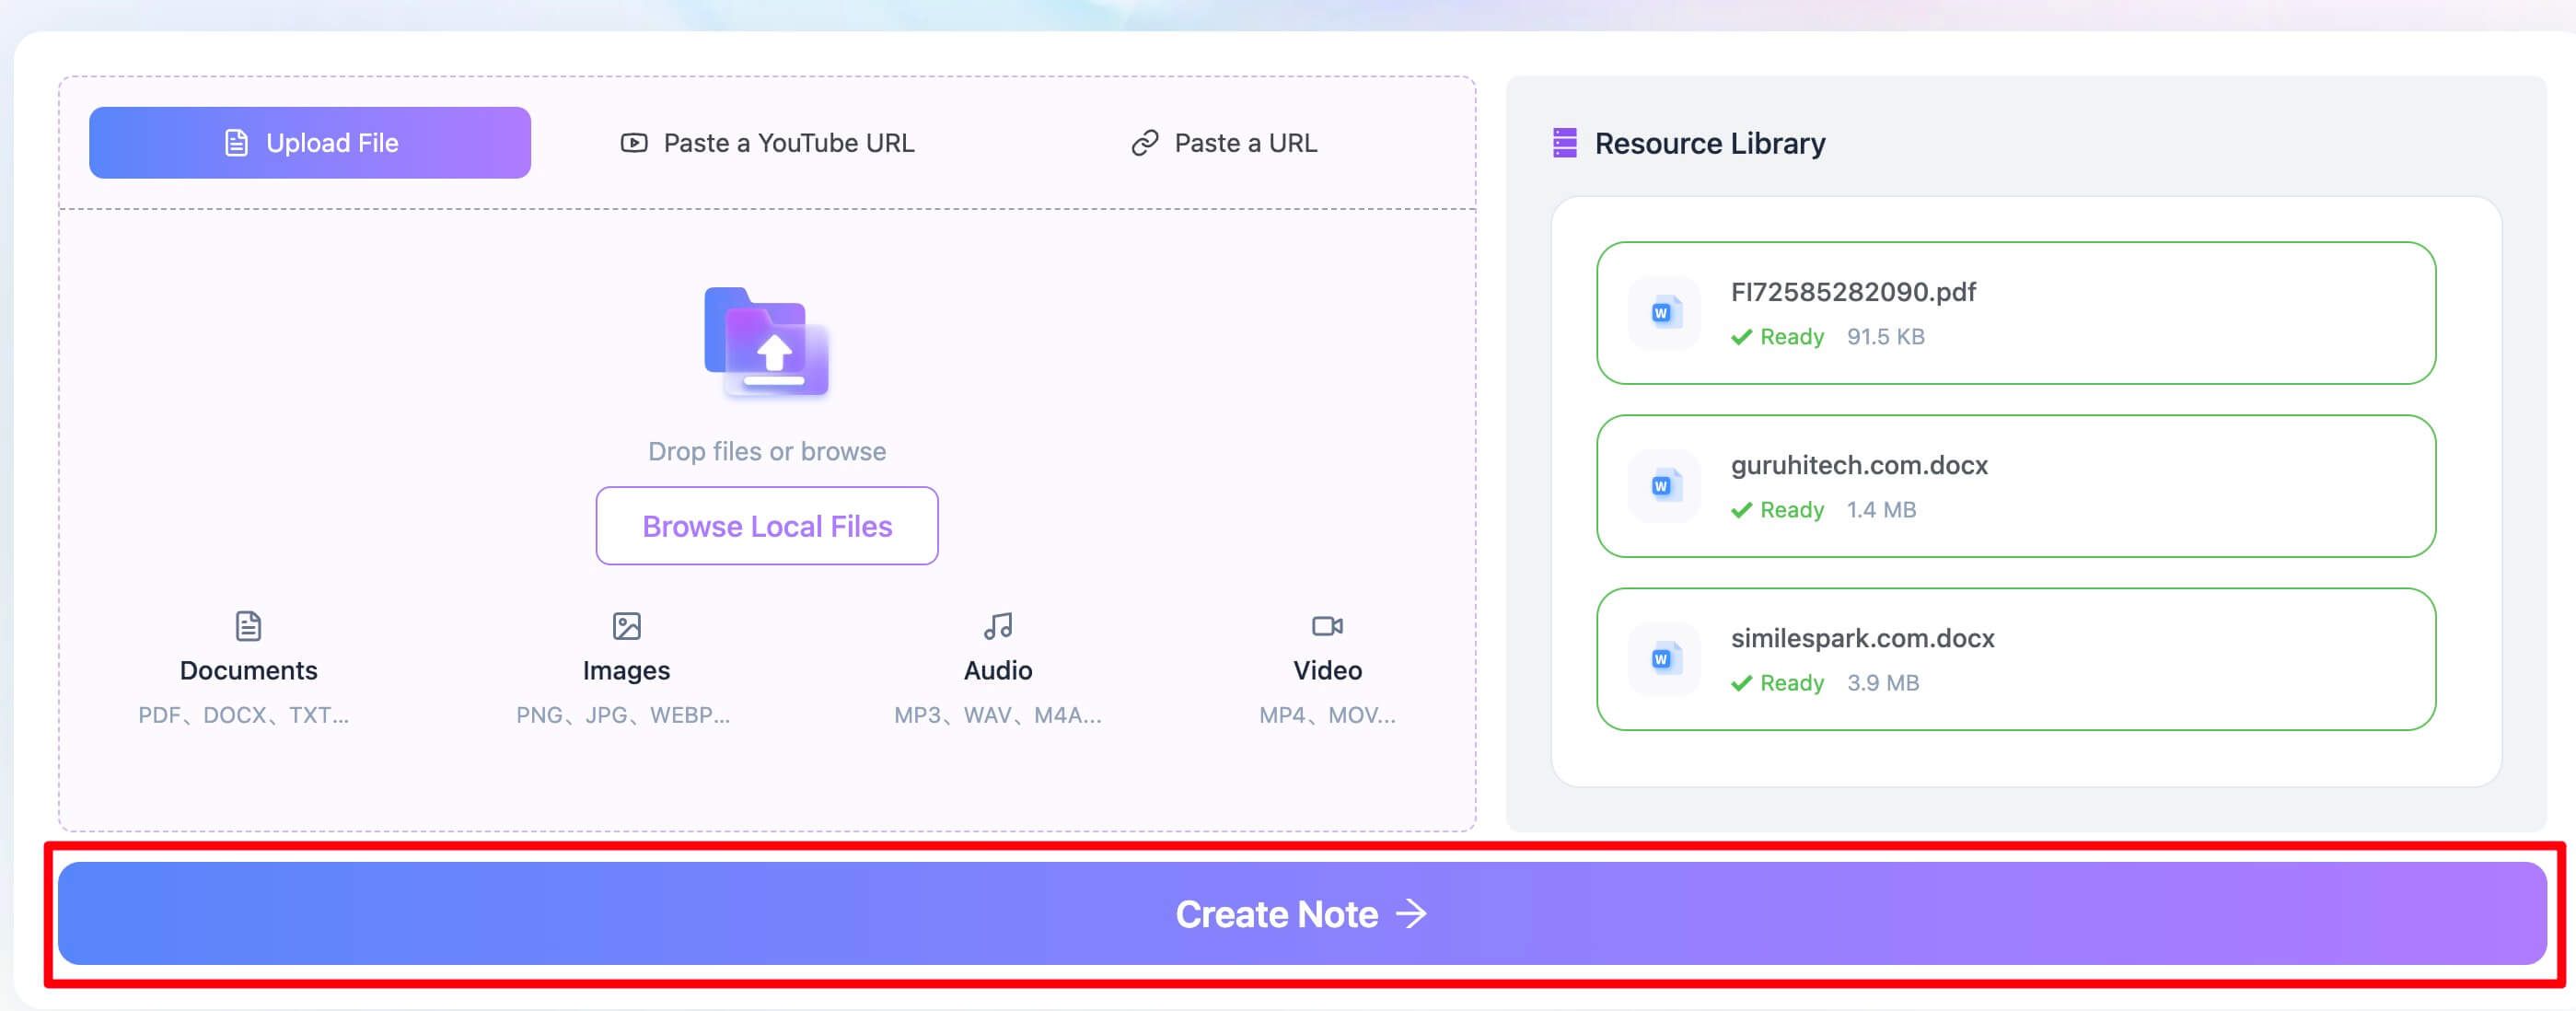
檔案上傳後,只需點擊 「建立筆記」 按鈕。這是關鍵步驟。Lynote 的後端會立即開始工作,將強大的 OCR 引擎應用於您的文件。它不僅僅是尋找現有的文字圖層;它會將頁面作為圖像進行分析,識別字元,並以數位方式重建文字。它支援超過 130 種語言,因此對於國際文件也有效。
步驟 3. 審閱並複製 PDF 文字
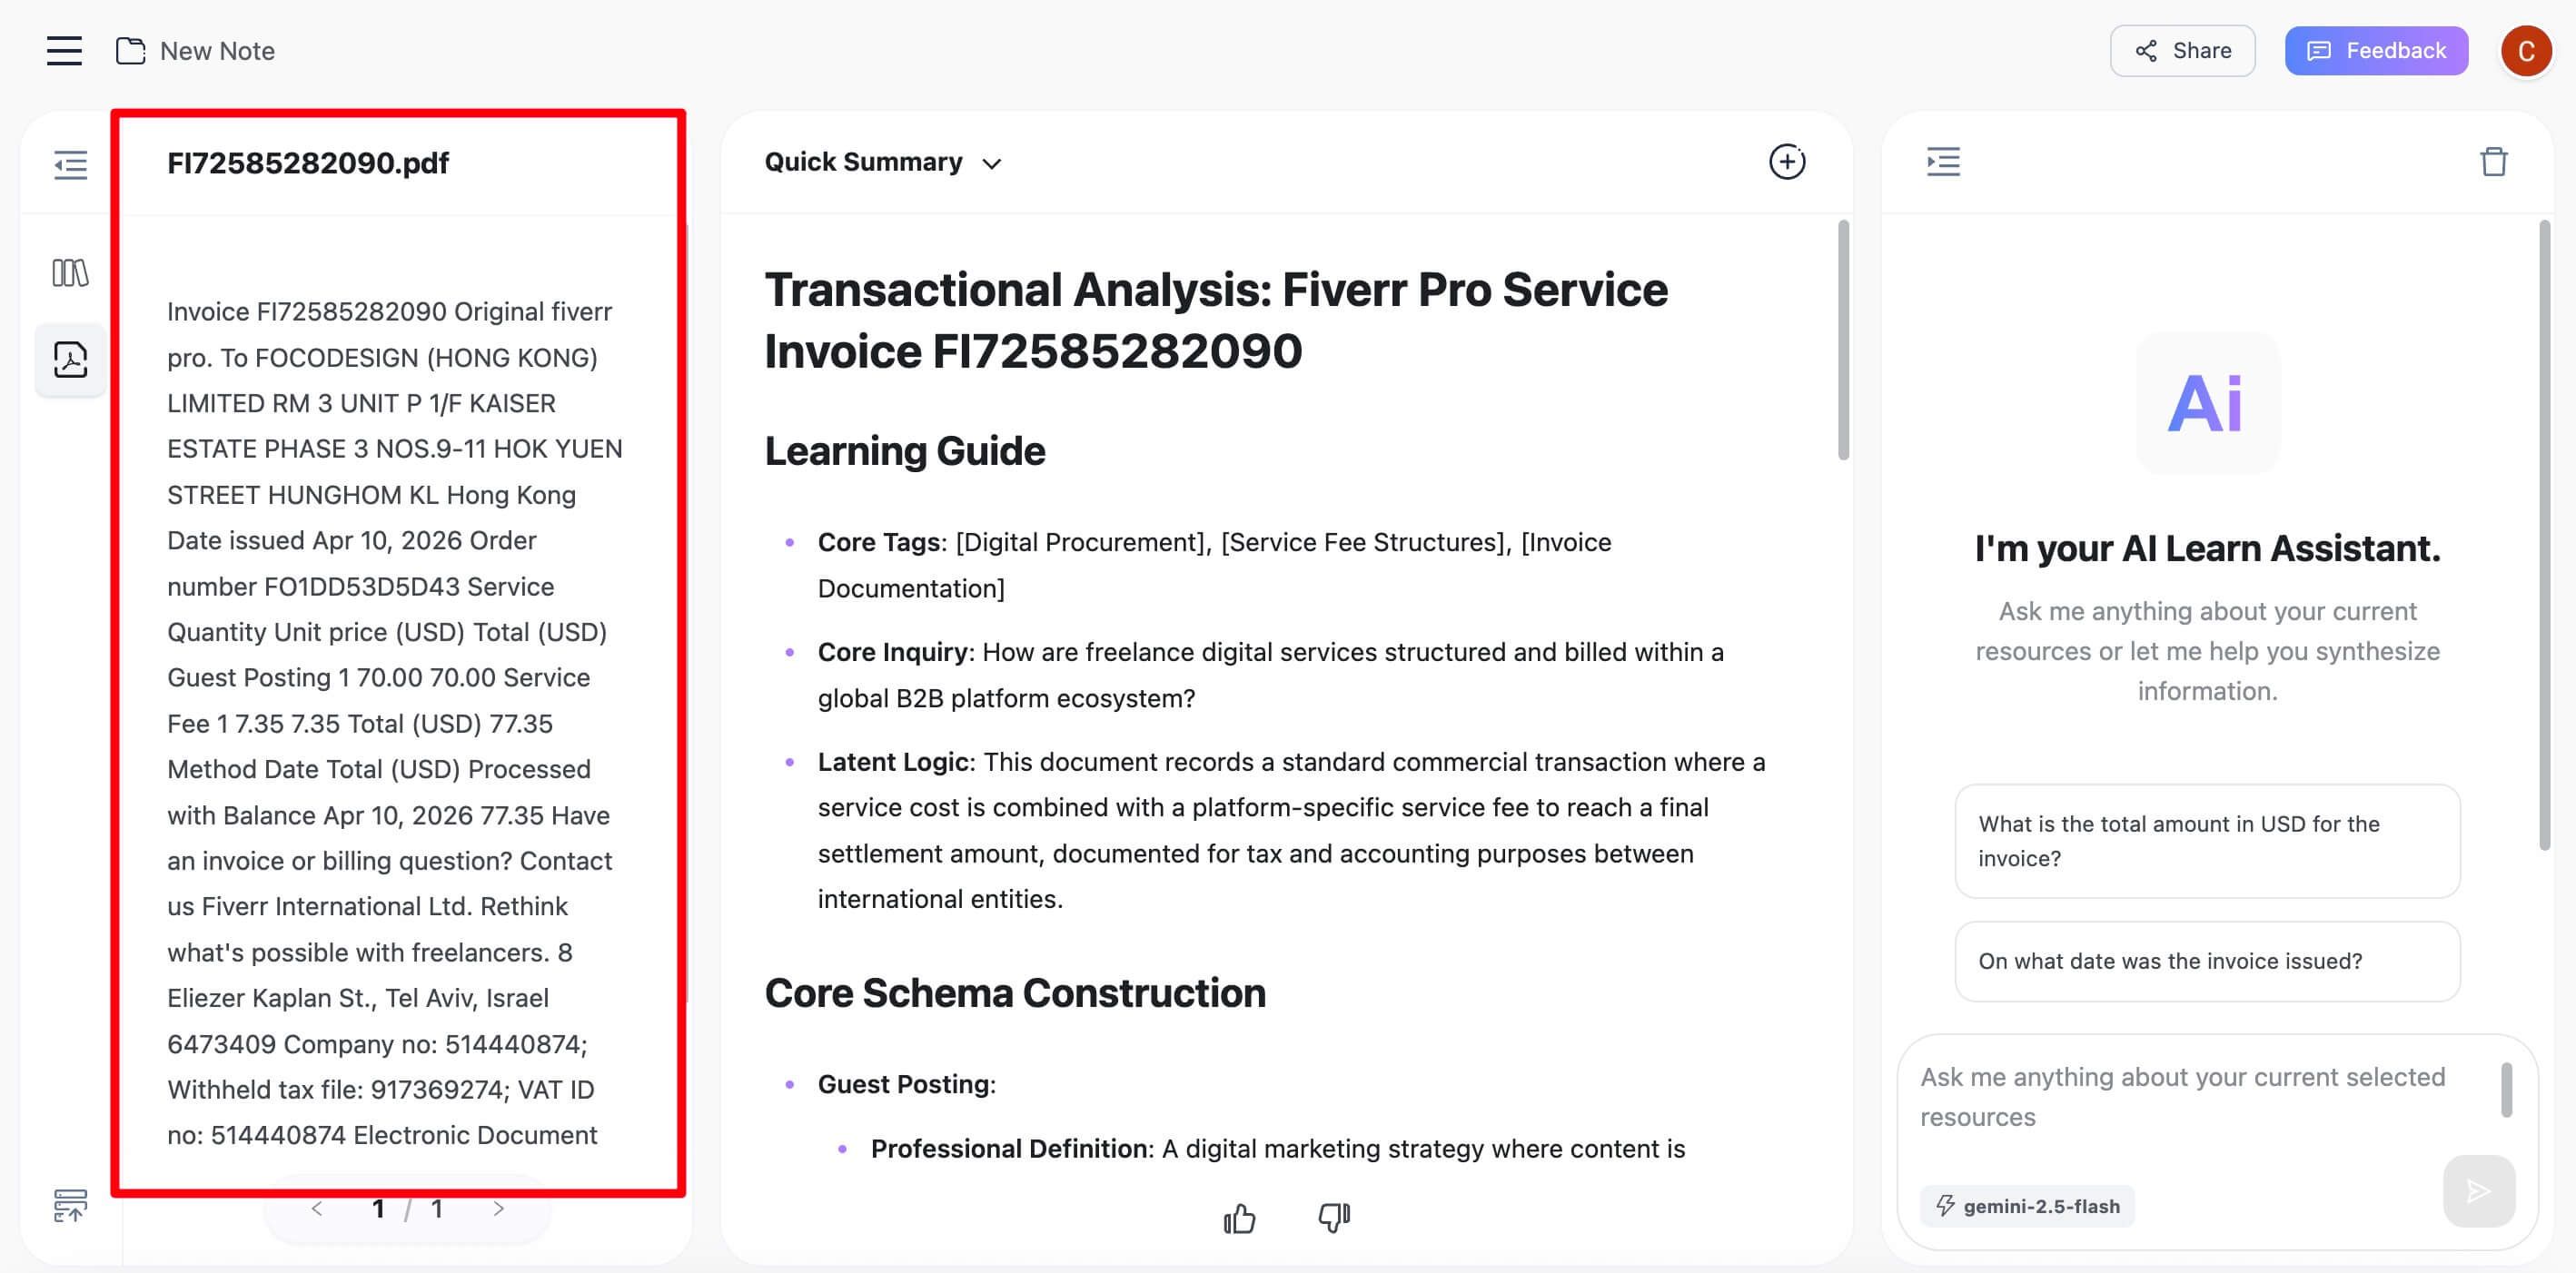
幾秒鐘內,您將在線上編輯器中看到清晰、擷取出的文字。現在您擁有了一個完美的、基於文字的來源,ChatGPT 可以輕鬆理解。您可以快速掃描是否有任何明顯的 OCR 錯誤,進行少量編輯,然後複製以獲取所有文字。從那裡,只需將其直接貼到您的 ChatGPT 提示中,然後繼續您的分析、摘要或查詢。您也可以將文字下載為 .txt 檔案以供將來使用。
這個三步驟過程有效地彌合了您基於圖像的 PDF 與 ChatGPT 基於文字的世界之間的鴻溝。

超越修復:選擇 PDF 文字擷取工具時應注意什麼
一旦您意識到需要一個專用工具,您會發現許多選項。那麼,是什麼讓一個優秀的工具脫穎而出呢?以下是您應該注意的關鍵功能,特別是如果您經常處理文件。
- 高準確度 OCR: 這是不可協商的。該工具的主要工作是準確地將圖像轉換為文字。一個好的引擎可以最大限度地減少錯誤 (例如將
l誤認為1或將rn誤認為m),並處理各種字體和解析度。 - 多語言支援: 如果您處理國際文件、研究論文或歷史文本,請確保該工具能夠識別您所需語言的字元和變音符號。像 Lynote 這樣支援 130 多種語言的工具提供了關鍵的靈活性。
- 批次處理: 您是否正在嘗試從整個掃描發票資料夾或十幾篇研究論文中擷取文字?一個允許您一次上傳多個檔案並在佇列中處理它們的工具,與一個一個處理相比,可以節省大量時間。
- 靈活的匯出選項: 擷取文字只是成功的一半。您需要能夠使用它。尋找簡單的一鍵選項,例如複製到剪貼簿、下載為 .txt 或 .docx 檔案,甚至進一步整合。現代工具可能還允許您立即與文件聊天或在同一介面中翻譯擷取出的文字。
選擇具有這些功能的工具,將一個令人沮喪的障礙轉變為您研究和分析工作流程中無縫的一部分。
專業提示:處理混亂或不準確的擷取文字
即使是最好的 OCR 技術也並非 100% 完美,尤其是在低品質掃描、手寫筆記或極其複雜的佈局下。當您擷取出的文字有點混亂時,不要絕望。這裡有一些專業技巧可以快速清理它。
- 修復斷裂的段落: 如果來自欄位的文字合併了,您會看到很長的、連貫的行。最快的修復方法是將文字貼到一個簡單的編輯器 (如記事本或 TextEdit) 中,然後手動按下「Enter」鍵以重新建立段落斷裂。這需要一分鐘,但會使文字對您和 ChatGPT 來說無限可讀。
- 使用尋找和取代來修正常見錯誤: OCR 存在經典錯誤。如果您看到許多
1應該是l的地方,或者!應該是i的地方,請使用您的文字編輯器的「尋找和取代」功能 (Ctrl+H 或 Cmd+Shift+H)。一些策略性的取代可以在幾秒鐘內清理 90% 的錯誤。 - 在摘要之前簡化: 在將清理後的文字提供給 ChatGPT 進行摘要之前,請考慮刪除不相關的部分,例如頁首、頁尾、頁碼和圖表標題。這會將 AI 的注意力集中在核心內容上,通常會產生更準確和簡潔的輸出。
前端的一點點清理可以為您省去很多困惑,並從您的 AI 分析中獲得更好的結果。
常見問題
ChatGPT-4o 可以讀取掃描 PDF 中的文字嗎?
不行,不能直接讀取。即使是像 GPT-4o 這樣更進階的模型,其標準檔案上傳功能仍然缺乏內建的、面向用戶的 OCR 引擎。如果您上傳掃描的、僅圖像的 PDF,您將收到相同的「無法從此檔案中提取文字」錯誤。您必須先使用外部 OCR 工具將 PDF 轉換為文字,然後再將該文字貼到您的提示中。
為什麼我的 PDF 可以複製貼上,但 ChatGPT 卻失敗了?
這是一個很好的問題,它揭示了 PDF 的隱藏層。許多 PDF 既有圖像層 (您看到的) 又有不可見的文字層 (檔案建立時生成的)。當您反白並複製時,您的 PDF 閱讀器 (如 Adobe Acrobat 或 Preview) 是從該隱藏文字層中提取的。然而,如果該文字層損壞、缺失或編碼不良,ChatGPT 較簡單的伺服器端解析器就無法讀取它,即使您的本地軟體可以。
有沒有免費的方法可以讓我的 PDF 文字對 ChatGPT 可讀?
有。本文中描述的使用像 Lynote 這樣的工具的免費層級是其中最有效的免費選項之一。它使用高品質的 OCR 引擎,無需付費或帳戶即可進行基本擷取。雖然還有其他一些免費的線上 OCR 工具,但它們通常充斥著廣告、準確度低或施加非常嚴格的檔案大小限制。
為什麼擷取後格式 (粗體、斜體) 消失了?
文字擷取工具,尤其是基於 OCR 的工具,專注於擷取_字元_,而不是富文本格式。輸出幾乎總是純文字。這通常對 AI 模型更好,因為它們主要關注語義內容,而不是視覺樣式。
結論:為工作選擇正確的工具
ChatGPT 是一個處理語言的革命性工具,但它並不是適用於所有檔案格式的瑞士軍刀。「無法從此檔案中提取文字」錯誤不是一個錯誤;它是一個能力邊界。該模型旨在處理文字,而不是解讀鎖定在掃描件或複雜佈局中的文字圖像。
對於經常處理各種文件的學生、研究人員和專業人士來說,教訓很清楚:不要與工具對抗,而是補充它。 透過在您的工作流程中添加一個專用的 OCR 驅動文字擷取工具,您可以將一個持續的挫折點轉變為一個可靠的兩步驟過程:先擷取,然後分析。這種方法不僅可以節省您的時間,還可以釋放 AI 在您所有文件上的全部潛力,而不僅僅是簡單的文件。