

ใช่ ข้อความที่สร้างโดย GPT-5.6 ที่บริสุทธิ์และไม่มีการแก้ไข มักจะถูกตรวจจับได้โดยเครื่องมือตรวจจับ AI เชิงพาณิชย์ในปัจจุบัน การศึกษาเบื้องต้นจากผู้จำหน่ายที่ครอบคลุม GPT-5.6 Sol, Terra และ Luna รายงานอัตราการจดจำที่สูง รวมถึงผลลัพธ์ที่สูงกว่า 96 เปอร์เซ็นต์ในการกำหนดค่าการทดสอบหลายรายการ
คำตอบนั้นจำเป็นต้องมีคุณสมบัติที่สำคัญ เครื่องมือตรวจจับ AI สามารถระบุรูปแบบที่คล้ายกับการเขียนที่สร้างโดยเครื่องจักรได้ แต่โดยทั่วไปแล้วไม่สามารถพิสูจน์ได้ว่า GPT-5.6 สร้างเอกสารฉบับใดฉบับหนึ่ง ระบุบุคคลที่ใช้งาน หรือสร้างใหม่ว่ามีงานของมนุษย์เข้าไปในข้อความสุดท้ายมากน้อยเพียงใด
ความแตกต่างมีความสำคัญ “ข้อความนี้ดูเหมือนสร้างโดย AI” เป็นการจัดประเภทตามความน่าจะเป็น; “GPT-5.6 เขียนข้อความนี้” เป็นการอ้างสิทธิ์แหล่งที่มา หลักฐานที่มีอยู่สนับสนุนข้อสรุปแรกมากกว่าข้อสรุปที่สองอย่างมาก
คำตอบด่วน: GPT-5.6 ตรวจจับได้หรือไม่?
เนื้อหา GPT-5.6 สามารถตรวจจับได้เมื่ออินพุตมีความยาวเพียงพอ สร้างโดย AI เป็นหลัก และใกล้เคียงกับผลลัพธ์ดั้งเดิมของโมเดล ทั้ง Originality.ai และ Pangram ได้เผยแพร่การประเมินเฉพาะสำหรับ GPT-5.6 ไม่นานหลังจากที่ตระกูลโมเดลนี้เปิดให้ใช้งานทั่วไปในเดือนกรกฎาคม 2026
อย่างไรก็ตาม การทดสอบเหล่านั้นไม่ได้กำหนดอัตราการตรวจจับที่เป็นสากลสำหรับเอกสารที่ใช้ GPT-5.6 ทุกฉบับ การเขียนจริงอาจรวมผลลัพธ์ของโมเดลเข้ากับการวางแผนของมนุษย์ การรายงานต้นฉบับ การอ้างอิง การแก้ไข การอ้างอิง การแปล และการแก้ไขร่วมกัน
| คำถาม | คำตอบเชิงปฏิบัติ |
|---|---|
| เครื่องมือตรวจจับ AI สามารถระบุผลลัพธ์ GPT-5.6 บริสุทธิ์ได้หรือไม่? | บ่อยครั้งที่ทำได้ |
| Sol, Terra และ Luna ได้รับการทดสอบต่อสาธารณะทั้งหมดหรือไม่? | ใช่ ในการศึกษาที่เผยแพร่โดยผู้จำหน่าย |
| เครื่องมือตรวจจับสามารถระบุ GPT-5.6 เป็นแหล่งที่มาที่แน่นอนได้หรือไม่? | โดยปกติแล้วไม่ได้ |
| คะแนน AI ที่สูงพิสูจน์การประพฤติมิชอบหรือไม่? | ไม่ |
| ข้อความที่แก้ไขหรือผสมสามารถให้คะแนนที่แตกต่างกันได้หรือไม่? | ใช่ |
| การเขียนของมนุษย์สามารถได้รับผลบวกปลอมได้หรือไม่? | ใช่ |
ดังนั้น ข้อสรุปที่สามารถป้องกันได้มากที่สุดคือมีเงื่อนไข: GPT-5.6 สามารถตรวจจับได้ว่าเป็นข้อความที่คล้าย AI ภายใต้เงื่อนไขการทดสอบหลายประการ แต่การตรวจจับไม่เหมือนกับการระบุแหล่งที่มาที่แน่นอน
GPT-5.6 หมายถึงอะไร: Sol, Terra และ Luna
OpenAI ได้เปิดตัวตระกูล GPT-5.6 ให้ใช้งานทั่วไปเมื่อวันที่ 9 กรกฎาคม 2026 ซึ่งแตกต่างจากการเปิดตัวที่แสดงด้วยชื่อโมเดลเดียวและโปรไฟล์เอาต์พุตเดียว GPT-5.6 ถูกจัดระเบียบเป็นสามระดับความสามารถ: Sol, Terra และ Luna
Sol เป็นโมเดลเรือธงสำหรับการให้เหตุผลที่ซับซ้อนและงานระดับมืออาชีพ Terra ถูกวางตำแหน่งให้เป็นโมเดลที่สมดุลสำหรับงานประจำวัน ในขณะที่ Luna ให้ความสำคัญกับความเร็วและต้นทุนที่ต่ำกว่า
| โมเดล GPT-5.6 | ตำแหน่งของ OpenAI | บริบทการเขียนทั่วไป | เหตุใดจึงสำคัญต่อการตรวจจับ |
|---|---|---|---|
| Sol | ความสามารถระดับเรือธง | การวิเคราะห์ที่ซับซ้อน, การวิจัย, การเขียนเชิงวิชาชีพที่มีโครงสร้าง | การให้เหตุผลที่ยาวขึ้นและการปฏิบัติตามคำสั่งที่เข้มงวดขึ้นอาจเปลี่ยนรูปแบบผลลัพธ์ |
| Terra | โมเดลที่สมดุลสำหรับงานประจำวัน | อีเมล, บทความ, รายงาน, งานความรู้ทั่วไป | การใช้งานที่หลากหลายสร้างการผสมผสานของพรอมต์และประเภทเอกสารที่แตกต่างกัน |
| Luna | โมเดลที่รวดเร็วและคุ้มค่า | การร่างงานปริมาณมากและเนื้อหาประจำ | ผลลัพธ์ที่สั้นลงหรือเป็นมาตรฐานมากขึ้นอาจสร้างสัญญาณที่แตกต่างกัน |
ระดับเหล่านี้ไม่ควรถูกสันนิษฐานโดยอัตโนมัติว่ามีลายนิ้วมือการเขียนที่เหมือนกัน อาจมีความแตกต่างกันในด้านความละเอียดของคำ การจัดระเบียบประโยค ความลึกของการให้เหตุผล และความใกล้เคียงกับการปฏิบัติตามรูปแบบที่ร้องขอ
อย่างไรก็ตาม ผลลัพธ์สาธารณะในปัจจุบันชี้ให้เห็นว่าความแตกต่างที่สำคัญระหว่างสามระดับนั้นไม่เพียงพอที่จะทำให้ระดับใดระดับหนึ่งไม่สามารถตรวจจับได้โดยทั่วไป ในการประเมินเบื้องต้นของผู้จำหน่ายสองครั้ง ทั้งสามระดับให้ผลลัพธ์การจัดประเภท AI ในอัตราที่สูง
สิ่งที่การทดสอบการตรวจจับ GPT-5.6 ในปัจจุบันพบ
การทดสอบสาธารณะสองรายการให้หลักฐานเบื้องต้นที่ชัดเจนที่สุด การทดสอบเหล่านี้มีประโยชน์เนื่องจากครอบคลุมทั้ง Sol, Terra และ Luna แต่ควรอ่านเป็นการประเมินที่รายงานโดยผู้จำหน่ายมากกว่าการรับรองอิสระ
ผลลัพธ์ GPT-5.6 ของ Originality.ai
Originality.ai ได้ประเมินผลลัพธ์ของ GPT-5.6 ด้วยการกำหนดค่าการตรวจจับสี่แบบ ได้แก่ Lite, Turbo, Academic และ AI Allowance บริษัทรายงานว่า Lite, Turbo และ Academic ไม่ได้รับการฝึกฝนด้วยข้อมูล GPT-5.6 ก่อนการทดสอบ
ผลลัพธ์ที่เผยแพร่ระบุว่าค่าความแม่นยำของ Sol, Terra และ Luna อยู่ระหว่าง 96 ถึง 99 เปอร์เซ็นต์สำหรับ Lite, Turbo และ Academic ส่วน AI Allowance รายงานว่าสูงกว่า 99 เปอร์เซ็นต์สำหรับทั้งสามระดับเมื่อใช้การตั้งค่าเริ่มต้นที่ 15 เปอร์เซ็นต์
| การกำหนดค่า Originality.ai | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna |
|---|---|---|---|
| Lite | 97% | 97% | 96% |
| Turbo | 99% | 98% | 97% |
| Academic | 97% | 97% | 97% |
| AI Allowance, default setting | 99%+ | 99%+ | 99%+ |
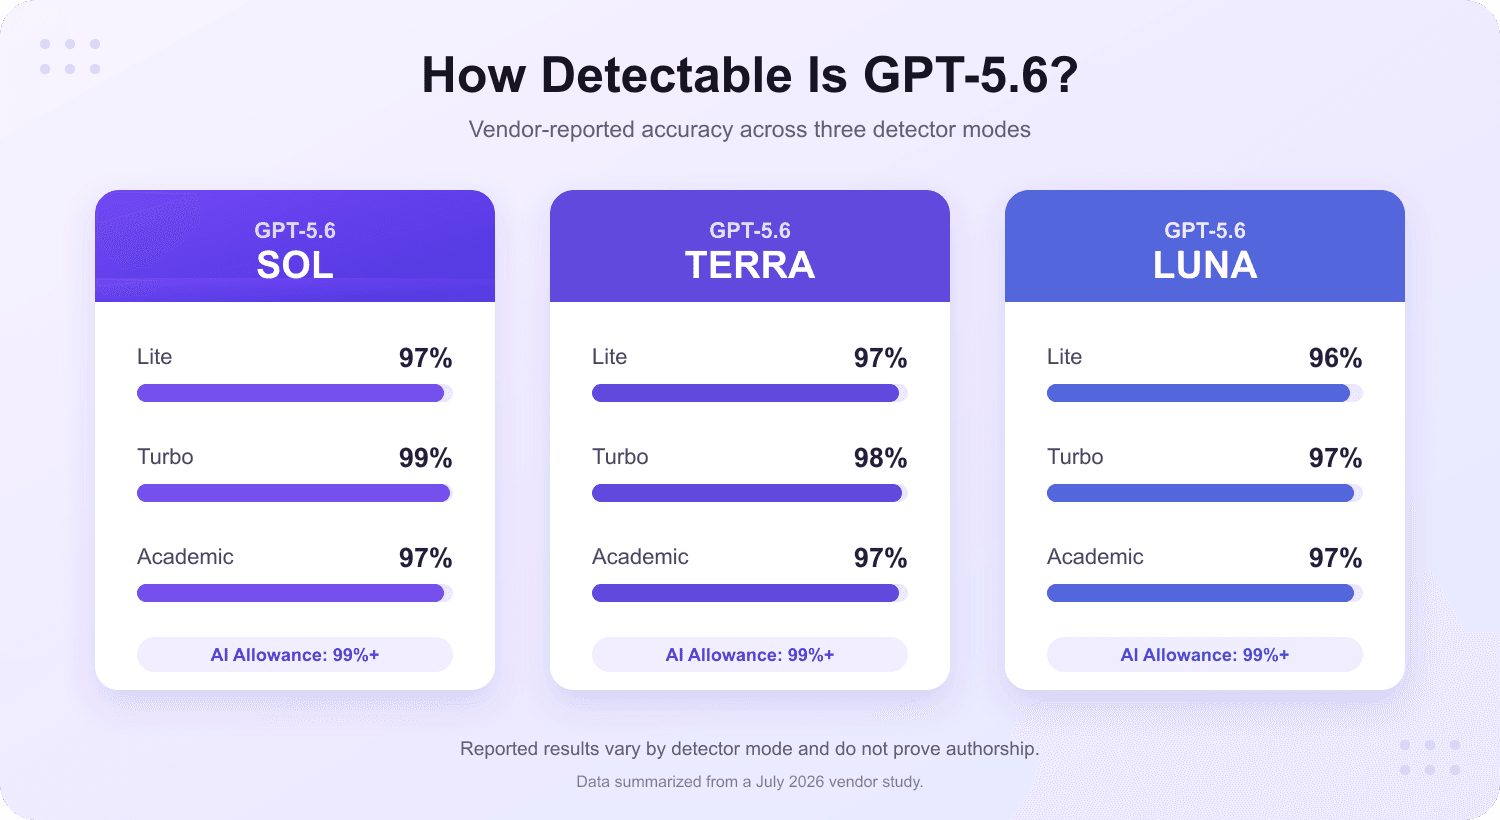
Originality.ai อธิบายชุดข้อมูลที่สร้างขึ้นจากตัวอย่างที่มนุษย์เขียน 5,000 ตัวอย่าง ครอบคลุมด้านสุขภาพ ข่าว การเงิน เทคโนโลยี ศิลปะ และความบันเทิง โดยใช้ GPT-5.6 เพื่อสร้างข้อความต่อจากพรอมต์ที่เกี่ยวข้องกับเนื้อหานั้น ซึ่งครอบคลุมบล็อก บทวิจารณ์ บทความเชิงอธิบาย และการเขียนเชิงสนทนา
ความครอบคลุมนั้นมีประโยชน์ แต่บทความสาธารณะไม่ได้ให้รายละเอียดทั้งหมดที่จำเป็นในการทำซ้ำการศึกษาตั้งแต่ต้นจนจบ ตัวอย่างเช่น ผู้อ่านไม่สามารถหาเมทริกซ์ความสับสนที่สมบูรณ์สำหรับแต่ละระดับและประเภทเนื้อหาจากตารางหัวข้อเพียงอย่างเดียวได้
ผลลัพธ์ GPT-5.6 ของ Pangram
Pangram ได้เผยแพร่การประเมินแยกต่างหากโดยใช้การตอบสนองจาก GPT-5.6 จำนวน 3,423 รายการ โดยรวบรวมการตอบสนอง 1,141 รายการจากแต่ละระดับโมเดล และระบุว่าเครื่องมือตรวจจับของตนไม่ได้รับการฝึกฝนด้วย Sol, Terra หรือ Luna
Pangram จัดประเภทการตอบสนอง 3,408 จาก 3,423 รายการว่าเป็น AI สร้างขึ้นทั้งหมด ซึ่งเท่ากับ 99.56 เปอร์เซ็นต์ของชุดทดสอบ อัตราการจัดประเภท AI สร้างขึ้นทั้งหมดต่อโมเดลคือ 99.47 เปอร์เซ็นต์สำหรับ Sol, 99.74 เปอร์เซ็นต์สำหรับ Terra และ 99.47 เปอร์เซ็นต์สำหรับ Luna
| ผลลัพธ์ Pangram | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna |
|---|---|---|---|
| ตัวอย่าง | 1,141 | 1,141 | 1,141 |
| จัดประเภทเป็น AI ทั้งหมด | 1,135 | 1,138 | 1,135 |
| อัตรา AI ทั้งหมด | 99.47% | 99.74% | 99.47% |
พรอมต์ขอให้โมเดลสร้างเนื้อหา เช่น อีเมล เรียงความ และเรื่องราวตั้งแต่เริ่มต้น นั่นเป็นวิธีที่สมเหตุสมผลในการทดสอบว่าเครื่องมือตรวจจับรู้จักผลลัพธ์โดยตรงของโมเดลหรือไม่ แม้ว่าจะไม่ได้จำลองขั้นตอนการทำงานการเขียนจริงทุกขั้นตอนก็ตาม
สิ่งที่การศึกษาทั้งสองสนับสนุน
การศึกษาเหล่านี้ใช้ชุดข้อมูลที่แตกต่างกันและระบบการตรวจจับที่แตกต่างกัน แต่ก็ชี้ไปในทิศทางเดียวกัน ข้อความ GPT-5.6 ที่สร้างขึ้นใหม่และไม่มีการแก้ไข มักจะยังคงมีรูปแบบที่เกี่ยวข้องกับเครื่องจักรมากพอที่จะถูกจัดประเภทเป็น AI
| การศึกษา | วัสดุที่ใช้ทดสอบ | ผลลัพธ์หลักที่รายงาน | สิ่งที่สนับสนุน |
|---|---|---|---|
| Originality.ai | ข้อความที่ GPT-5.6 สร้างขึ้นในหลายโดเมนและรูปแบบ | 96-99% หรือสูงกว่า ขึ้นอยู่กับโมเดลและโหมดตรวจจับ | เครื่องมือตรวจจับของมันสามารถใช้ได้กับผลลัพธ์ GPT-5.6 บริสุทธิ์ |
| Pangram | การตอบสนองที่สร้างขึ้น 3,423 รายการ แบ่งเท่าๆ กันในแต่ละระดับ | 99.56% จัดประเภทเป็น AI ทั้งหมดโดยรวม | เครื่องมือตรวจจับของมันรู้จักการตอบสนองโดยตรงส่วนใหญ่ของ GPT-5.6 ในชุดข้อมูลนั้น |
ไม่มีการศึกษาใดแสดงให้เห็นว่าเครื่องมือตรวจจับทุกตัวทำงานได้ดีเท่ากัน นอกจากนี้ยังไม่แสดงให้เห็นว่าอัตราเดียวกันนี้จะใช้ได้กับข้อความสั้นๆ เอกสารที่ทำร่วมกัน ข้อความที่แปล ร่างที่แก้ไขอย่างหนัก หรือข้อความที่มีความช่วยเหลือจาก AI เพียงเล็กน้อย
เหตุใดอัตราการตรวจจับที่สูงจึงไม่สามารถสรุปคำถามได้
ผลลัพธ์เช่น 99 เปอร์เซ็นต์ฟังดูเหมือนเป็นที่สิ้นสุด แต่ตอบคำถามที่แคบกว่าที่ผู้อ่านหลายคนคิดไว้ มันอธิบายประสิทธิภาพบนชุดข้อมูลเฉพาะภายใต้เกณฑ์และขั้นตอนการทดสอบเฉพาะ
เอกสารแต่ละฉบับมาถึงโดยไม่มีเงื่อนไขที่ควบคุมเหล่านั้น ประวัติการเขียน กระบวนการแก้ไข ประเภท ความยาว และสัดส่วนของภาษาที่สร้างโดย AI อาจไม่เป็นที่ทราบทั้งหมด
การทดสอบมุ่งเน้นไปที่ผลลัพธ์ของโมเดลบริสุทธิ์
การศึกษา GPT-5.6 ทั้งสองในปัจจุบันส่วนใหญ่ประเมินข้อความที่สร้างขึ้นโดยตรงจากพรอมต์ นั่นคือการตั้งค่าที่ชัดเจนที่สุดสำหรับการวัดว่าเครื่องมือตรวจจับรู้จักโมเดลใหม่หรือไม่ แต่มันไม่ใช่วิธีเดียวที่ผู้คนใช้ GPT-5.6
นักวิจัยอาจใช้ Sol เพื่อจัดระเบียบคำถามแล้วเขียนรายงานด้วยตนเอง นักการตลาดอาจใช้ Terra สำหรับร่างแรกและแทนที่ครึ่งหนึ่งด้วยการสัมภาษณ์ ข้อเท็จจริงของผลิตภัณฑ์ และตัวอย่างต้นฉบับ ทีมงานอาจใช้ Luna สำหรับทางเลือกประโยคภายในเอกสารที่เขียนโดยคนหลายคน
เอกสารเหล่านั้นไม่เทียบเท่ากับการตอบสนองที่คัดลอกโดยตรงจาก ChatGPT หรือ API การเรียกทั้งหมดว่าเป็นเพียง “ข้อความ GPT-5.6” ซ่อนความแตกต่างที่มีความหมายในการเขียนและการควบคุมการแก้ไข
การศึกษาที่ดำเนินการโดยผู้พัฒนาเครื่องมือตรวจจับต้องอ่านอย่างระมัดระวัง
Originality.ai และ Pangram ต่างทดสอบเครื่องมือตรวจจับของตนเอง ซึ่งไม่ได้ทำให้ผลลัพธ์ไร้ประโยชน์ ผู้พัฒนาเครื่องมือตรวจจับมักมีโครงสร้างพื้นฐานและความเร่งด่วนที่จำเป็นในการประเมินโมเดลใหม่ได้อย่างรวดเร็ว
แต่หมายความว่าตัวเลขควรได้รับการอธิบายอย่างถูกต้องว่าเป็นผลลัพธ์ที่รายงานโดยผู้จำหน่าย หลักฐานอิสระที่แข็งแกร่งกว่าจะทำซ้ำชุดข้อมูล เกณฑ์ และขั้นตอนการให้คะแนนในเครื่องมือตรวจจับหลายตัว ในขณะที่วัดทั้งตัวอย่าง AI และการควบคุมของมนุษย์อย่างแท้จริง
ประสิทธิภาพการเกิดผลบวกปลอมมีความสำคัญเป็นพิเศษ เครื่องมือตรวจจับที่สามารถจับตัวอย่าง AI ได้เกือบทุกตัวอย่างยังคงสามารถสร้างปัญหาที่ร้ายแรงได้ หากมันยังติดธงผิดพลาดในส่วนสำคัญของการเขียนของมนุษย์
ความแม่นยำไม่ใช่ความน่าจะเป็นที่ธงจะถูกต้อง
สมมติว่าการทดสอบรายงานความแม่นยำ 97 เปอร์เซ็นต์บนชุดข้อมูลที่สมดุลซึ่งมีจำนวนตัวอย่างที่เขียนโดยมนุษย์และ AI เท่ากัน ตัวเลขนั้นไม่ได้หมายความว่าเอกสารที่ได้รับคะแนนสูงมีความน่าจะเป็น 97 เปอร์เซ็นต์ที่จะถูกเขียนโดย GPT-5.6
ความน่าจะเป็นขึ้นอยู่กับอัตราผลบวกปลอมและผลลบปลอมของเครื่องมือตรวจจับ เกณฑ์ของมัน ประเภทของเอกสาร และความแพร่หลายของข้อความที่สร้างโดย AI ในประชากรที่กำลังตรวจสอบ นี่คือปัญหาอัตราพื้นฐาน: ความแม่นยำของเกณฑ์มาตรฐานและความน่าเชื่อถือของการกล่าวหาแต่ละครั้งไม่สามารถใช้แทนกันได้
สำหรับการคัดแยกเนื้อหาที่มีความเสี่ยงต่ำ ผลบวกปลอมอาจเพียงแค่กระตุ้นให้มีการตรวจสอบอีกครั้ง ในด้านการศึกษา การจ้างงาน การเผยแพร่ หรือการปฏิบัติตามข้อกำหนด ผลบวกปลอมเดียวกันนี้อาจนำมาซึ่งผลกระทบที่ใหญ่กว่ามาก และดังนั้นจึงต้องการหลักฐานสนับสนุนที่แข็งแกร่งกว่า
เครื่องมือตรวจจับสามารถบอกได้หรือไม่ว่า GPT-5.6 เป็นผู้เขียนข้อความนั้นโดยเฉพาะ?
เครื่องมือตรวจจับ AI สาธารณะส่วนใหญ่ออกแบบมาเพื่อแยกแยะรูปแบบที่เกี่ยวข้องกับการเขียนของมนุษย์และเครื่องจักร โดยทั่วไปแล้วไม่ใช่เครื่องมือทางนิติวิทยาศาสตร์ที่สามารถกู้คืน ID โมเดลจากข้อความได้
คะแนนที่สูงอาจสอดคล้องกับ GPT-5.6 แต่อาจสอดคล้องกับโมเดล OpenAI อื่นๆ เช่น Claude, Gemini, โมเดลภาษาขนาดเล็ก หรือร้อยแก้วของมนุษย์ที่เป็นสูตรสำเร็จ โมเดลต่างๆ มีอิทธิพลจากการฝึกฝน รูปแบบการปฏิบัติตามคำสั่งที่พบบ่อย และแนวโน้มที่คล้ายกันในการสร้างโครงสร้างที่สมบูรณ์
สิ่งนี้สร้างระดับการอนุมานที่แตกต่างกันสามระดับ:
- การตรวจจับรูปแบบคล้าย AI: ข้อความนั้นคล้ายกับเนื้อหาที่เครื่องมือตรวจจับเชื่อมโยงกับการสร้างโดยเครื่องจักร
- ข้อสงสัยเกี่ยวกับตระกูลโมเดล: ข้อความนั้นอาจมาจากโมเดลภาษาที่ทันสมัย
- แหล่งที่มาที่แน่นอน: GPT-5.6 Sol, Terra หรือ Luna สร้างข้อความนั้นในการทำงานเฉพาะ
เครื่องมือตรวจจับสำหรับผู้บริโภคในปัจจุบันสามารถให้หลักฐานสำหรับระดับแรกได้ พวกเขาอาจสนับสนุนสมมติฐานที่ระมัดระวังในระดับที่สอง แต่ไม่ค่อยสามารถยืนยันระดับที่สามได้
แหล่งที่มาที่แน่นอนจะต้องใช้หลักฐานภายนอกข้อความเอง เช่น บันทึกแพลตฟอร์ม บันทึก API ประวัติเอกสาร กิจกรรมบัญชี หรือระบบแหล่งที่มาทางเข้ารหัสที่เชื่อถือได้ คะแนนทางภาษาเพียงอย่างเดียวไม่สามารถยืนยันห่วงโซ่การดูแลนั้นได้
อะไรที่ทำให้ผลการตรวจจับ GPT-5.6 เปลี่ยนแปลง?
พฤติกรรมของเครื่องมือตรวจจับไม่ได้คงที่ในทุกตัวอย่าง โมเดลเดียวกันสามารถสร้างข้อความที่มีรูปแบบที่แตกต่างกันได้เมื่อพรอมต์ ประเภท ความยาว การตั้งค่าการให้เหตุผล และปริมาณการแก้ไขของมนุษย์เปลี่ยนแปลงไป
| ปัจจัย | ผลกระทบที่อาจเกิดขึ้นต่อความเสถียรของคะแนน | การตีความที่รับผิดชอบ |
|---|---|---|
| ความยาวของข้อความ | ข้อความที่สั้นมากให้สัญญาณน้อยลง | หลีกเลี่ยงข้อสรุปที่แข็งกร้าวจากประโยคไม่กี่ประโยค |
| ประเภท | ร้อยแก้วทางเทคนิค กฎหมาย วิชาการ และแบบฟอร์มอาจมีความสม่ำเสมอโดยธรรมชาติ | เปรียบเทียบผลลัพธ์กับการเขียนของมนุษย์ที่เหมาะสมกับประเภท |
| ข้อจำกัดของพรอมต์ | คำสั่งรูปแบบหรือน้ำเสียงที่เข้มงวดสามารถทำให้ผลลัพธ์สม่ำเสมอมากขึ้น | ถือว่าคะแนนนั้นเฉพาะเจาะจงกับผลลัพธ์นั้น ไม่ใช่โมเดลทั้งหมด |
| Sol, Terra หรือ Luna | ระดับโมเดลอาจเปลี่ยนแปลงโครงสร้างและถ้อยคำ | อย่าสันนิษฐานว่าผลลัพธ์เดียวเป็นตัวแทนของตระกูลทั้งหมด |
| การแก้ไขโดยมนุษย์ | การแก้ไขสามารถนำเสนอทางเลือกของมนุษย์และรูปแบบที่ผสมผสาน | อธิบายเอกสารว่าเป็นแบบผสมเมื่อกระบวนการของมันเป็นแบบผสม |
| การแปล | ระบบการแปลสามารถทำให้รูปแบบประโยคเป็นมาตรฐานได้ | ตรวจสอบข้อความต้นฉบับและประวัติการแปล |
| การอ้างอิงและแหล่งที่มา | ภาษาต้นฉบับที่ฝังอยู่ อาจส่งผลต่อการเน้นเฉพาะจุด | แยกเนื้อหาที่อ้างอิงออกก่อนตีความข้อความ |
| เกณฑ์การตรวจจับ | การตั้งค่าที่ละเอียดอ่อนมากขึ้นจะจับ AI ได้มากขึ้นและอาจเพิ่มผลบวกปลอม | บันทึกโหมดและเกณฑ์ที่เลือก |
| การอัปเดตเครื่องมือตรวจจับ | โมเดลและเครื่องมือตรวจจับเปลี่ยนแปลงไปตามกาลเวลา | ระบุวันที่สแกนและหลีกเลี่ยงการถือว่าเป็นการถาวร |
ความยาวและบริบทของข้อความ
เครื่องมือตรวจจับต้องการภาษาที่เพียงพอในการประมาณรูปแบบต่างๆ เช่น ความสามารถในการคาดเดา ความหลากหลาย และความสม่ำเสมอของโครงสร้าง อีเมล 40 คำและบทความ 1,200 คำไม่ได้ให้หลักฐานในปริมาณที่เท่ากัน
ดังนั้น ผลลัพธ์สั้นๆ ควรถือว่าต้องใช้ความระมัดระวังเป็นพิเศษ การรวมข้อความสั้นๆ ที่ไม่เกี่ยวข้องกันเพื่อให้ถึงจำนวนคำขั้นต่ำยังสามารถบิดเบือนบริบทและสร้างคะแนนที่ไม่สามารถอธิบายข้อความใดข้อความหนึ่งได้ดี
การแก้ไขโดยมนุษย์และการเขียนแบบผสม
การแก้ไขไม่ใช่สวิตช์ไบนารีที่เปลี่ยนการเขียนของ AI ให้เป็นการเขียนของมนุษย์ มันสร้างความต่อเนื่องของการมีส่วนร่วม ตั้งแต่การพิสูจน์อักษรเล็กน้อยไปจนถึงการสร้างใหม่ทั้งหมดโดยอิงจากการวิจัยและวิจารณญาณดั้งเดิม
เอกสารแบบผสมอาจมีส่วนที่มีประวัติแตกต่างกัน การเน้นระดับประโยคสามารถให้ข้อมูลได้มากกว่าเปอร์เซ็นต์โดยรวมเพียงอย่างเดียว เพราะช่วยให้ผู้ตรวจสอบถามได้ว่าเกิดอะไรขึ้นในข้อความเฉพาะ
ประเภทและรูปแบบมืออาชีพ
การเขียนของมนุษย์บางอย่างถูกทำให้เป็นมาตรฐานโดยเจตนา ภาษาของนโยบาย วิธีการในห้องปฏิบัติการ เอกสารสนับสนุน ข้อกำหนดทางกฎหมาย และแม่แบบขององค์กร อาจใช้สำนวนซ้ำๆ และรักษารูปแบบประโยคที่สอดคล้องกัน
นั่นอาจคล้ายกับความสม่ำเสมอที่เกี่ยวข้องกับผลลัพธ์ของโมเดล ผู้ตรวจสอบควรพิจารณาว่าลักษณะที่ถูกตั้งค่าสถานะเกิดจากการเขียน รูปแบบตามประเภท แม่แบบของสถาบัน หรือการรวมกันของปัจจัยต่างๆ
วิธีตรวจสอบข้อความที่เขียนโดย OpenAI ด้วย Lynote
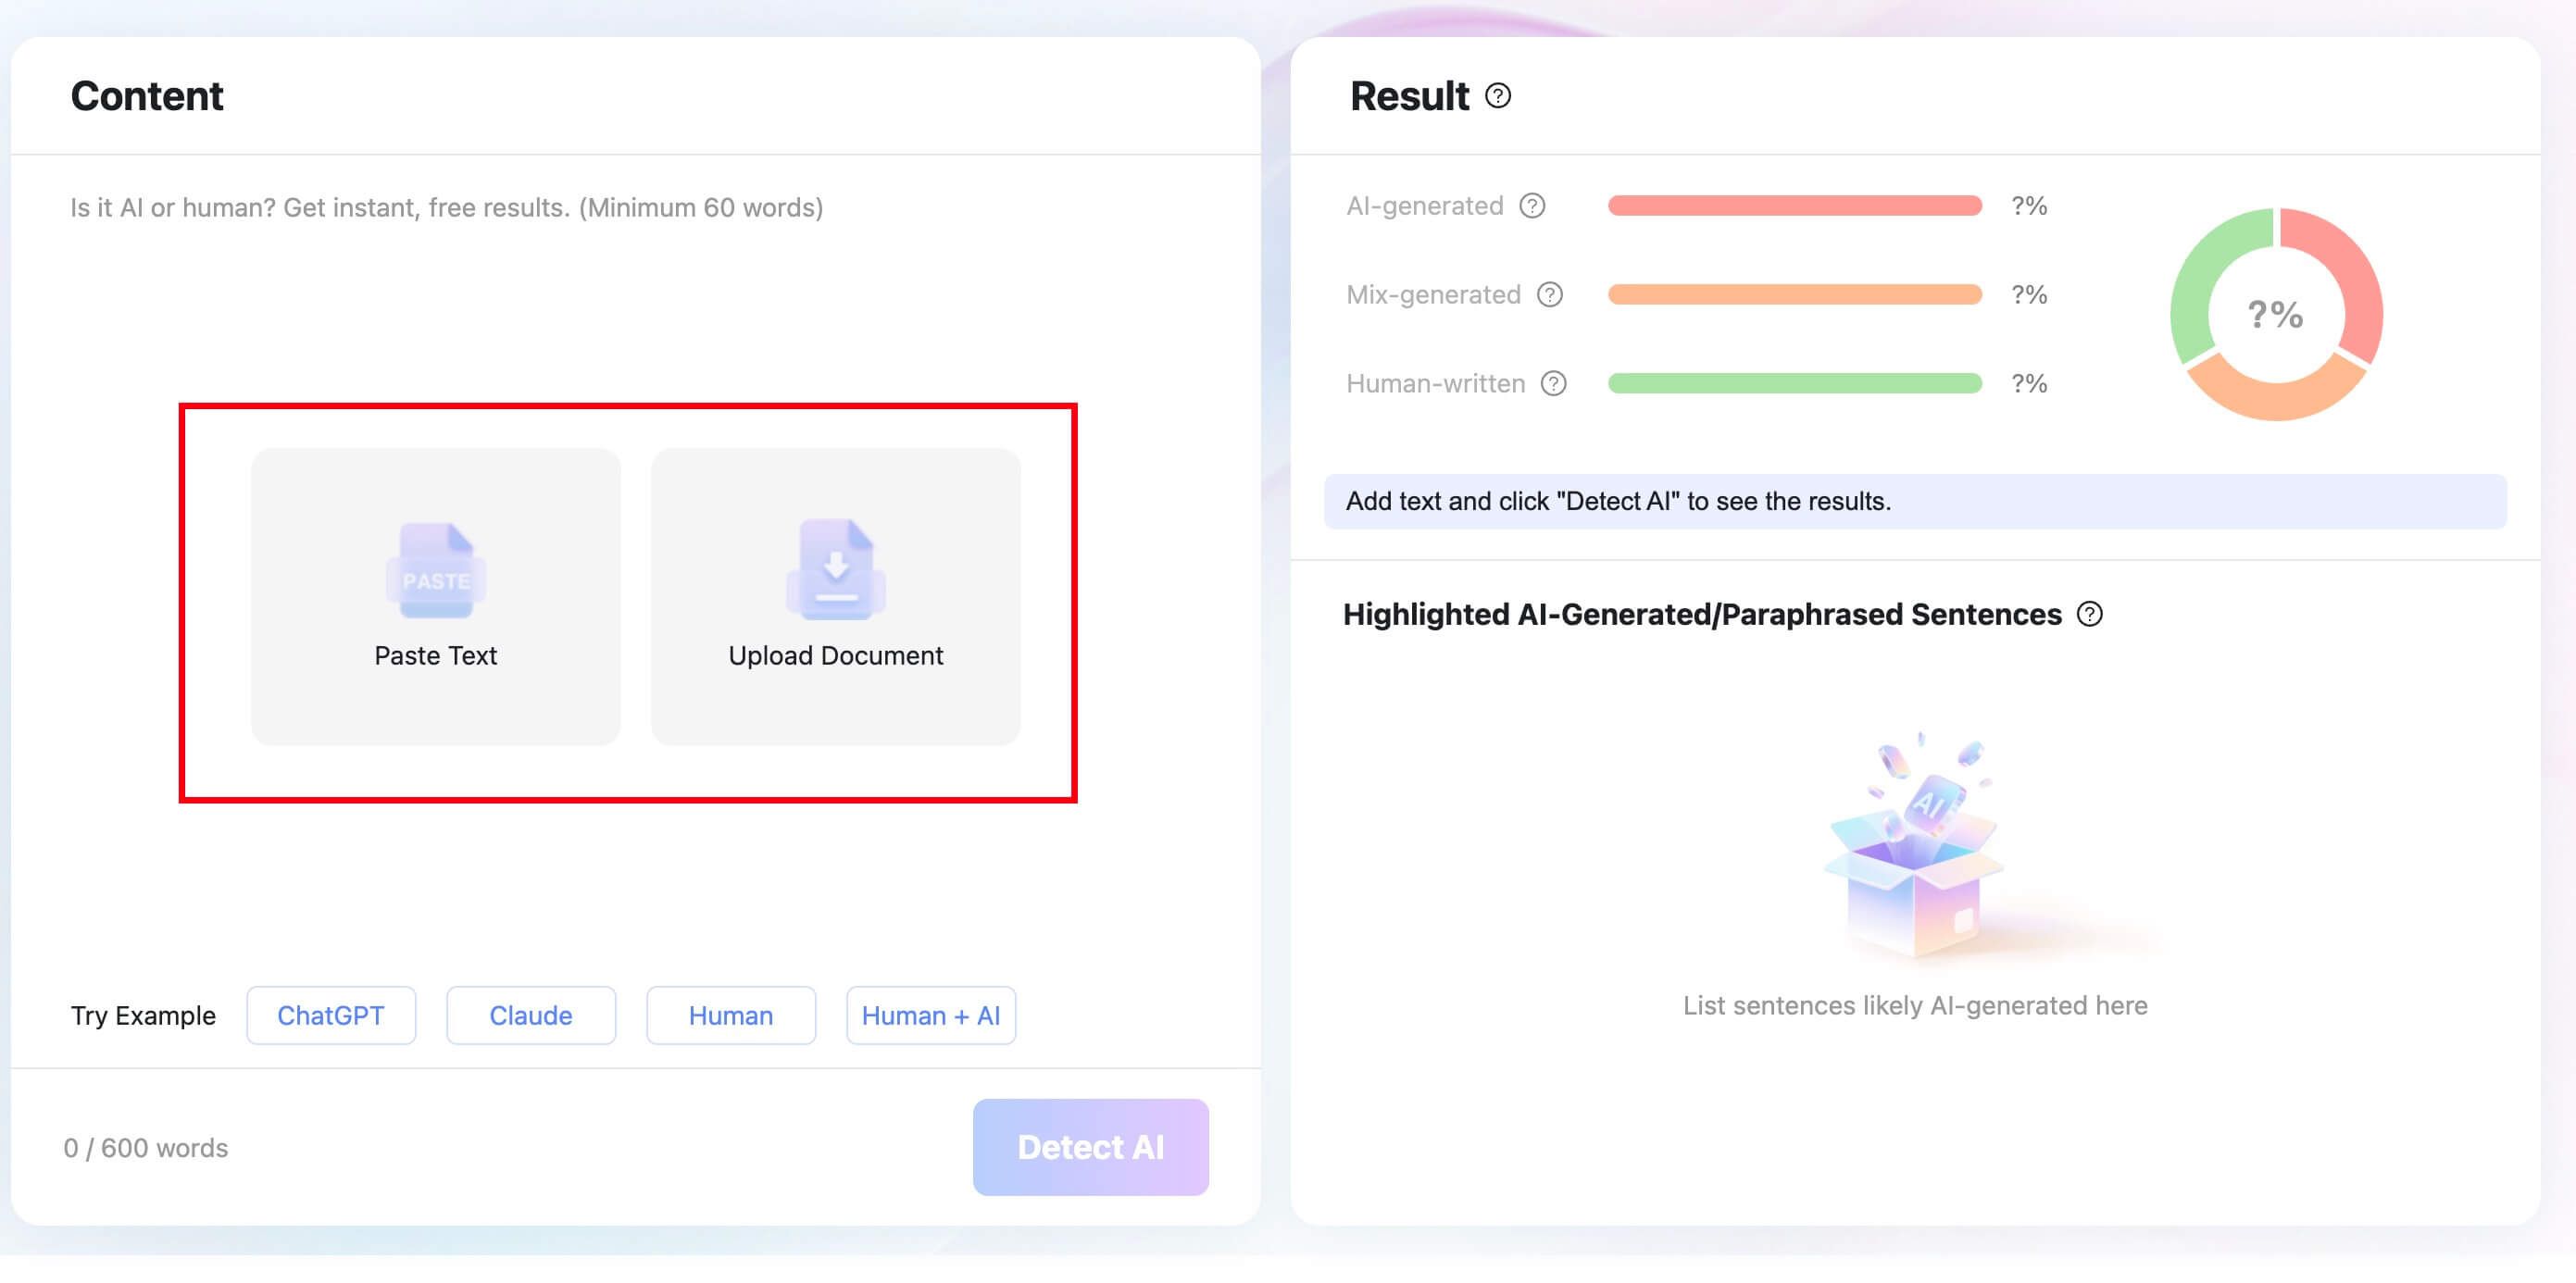
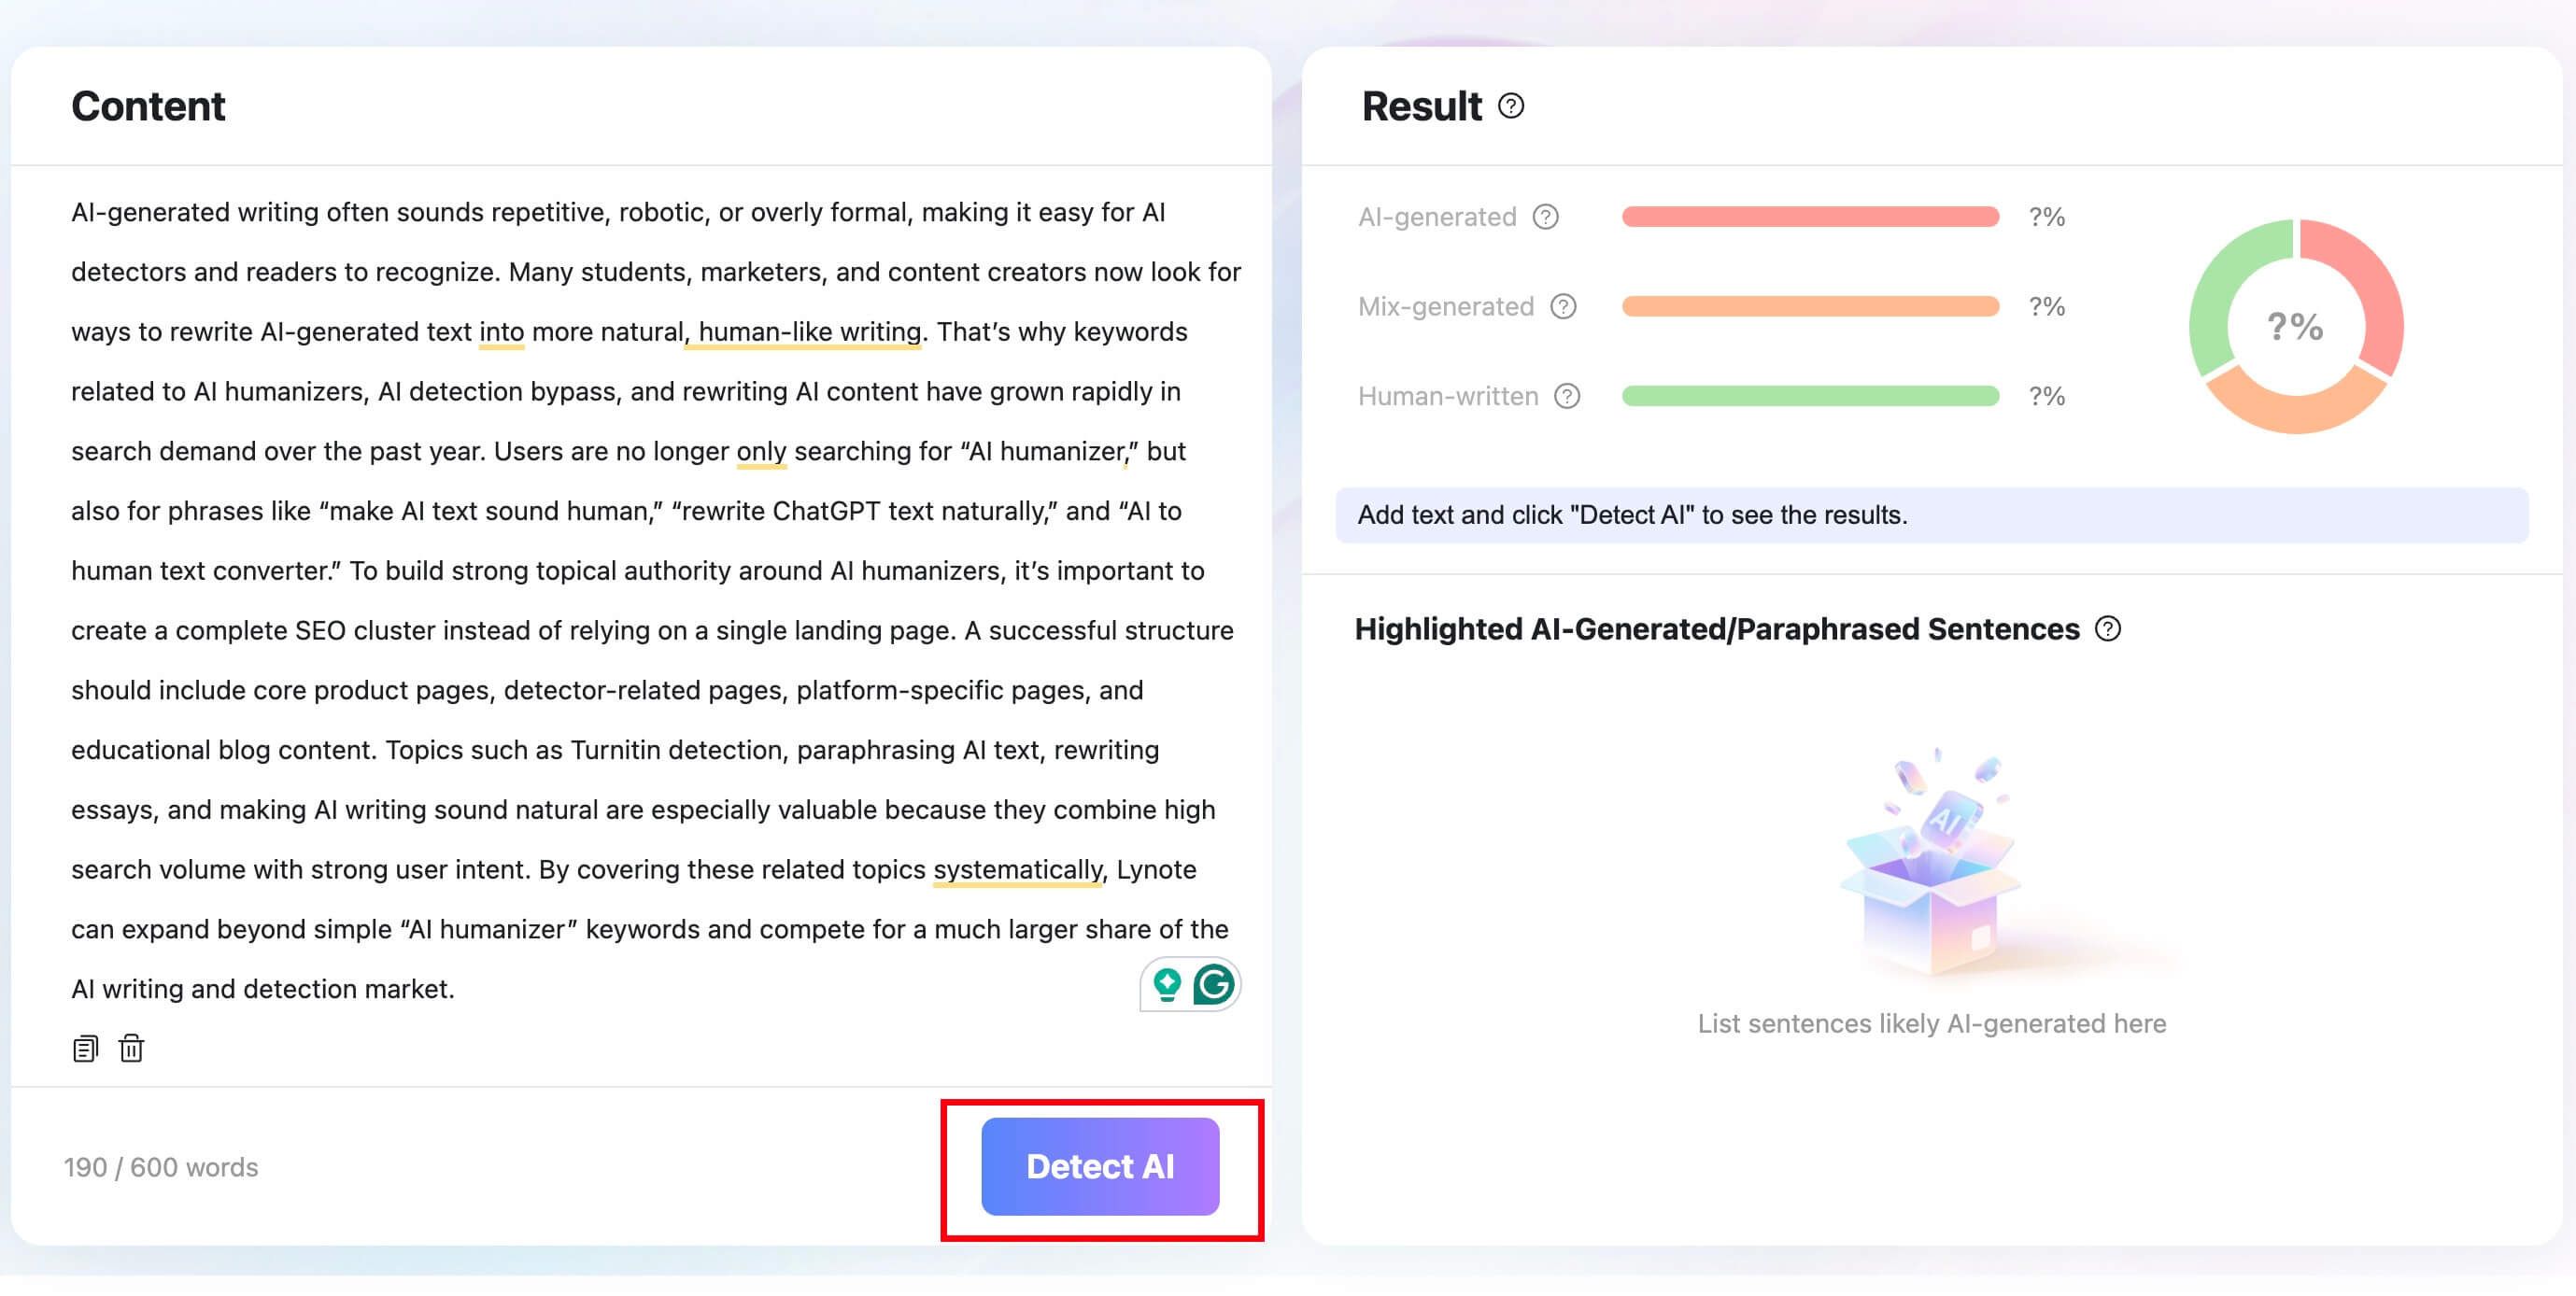
เครื่องมือตรวจจับเนื้อหา OpenAI ของ Lynote สามารถให้สัญญาณเบื้องต้นเมื่อคุณต้องการตรวจสอบข้อความที่อาจรวมถึงความช่วยเหลือจาก ChatGPT หรือ GPT-5.6 โดยจะรายงานเปอร์เซ็นต์ที่สร้างโดย AI, แบบผสม และที่เขียนโดยมนุษย์ และเน้นประโยคที่ควรได้รับการตรวจสอบอย่างละเอียด
- วางข้อความลงใน Lynote หรืออัปโหลดเอกสารที่รองรับ
- คลิก Detect AI เพื่อวิเคราะห์ข้อความ
- ตรวจสอบการกระจายของ AI, แบบผสม และที่เขียนโดยมนุษย์
- ตรวจสอบการเน้นระดับประโยคแทนที่จะพึ่งพาคะแนนโดยรวมเท่านั้น
- เปรียบเทียบข้อความที่เน้นกับฉบับร่าง บันทึก การอ้างอิง และประวัติเวอร์ชัน
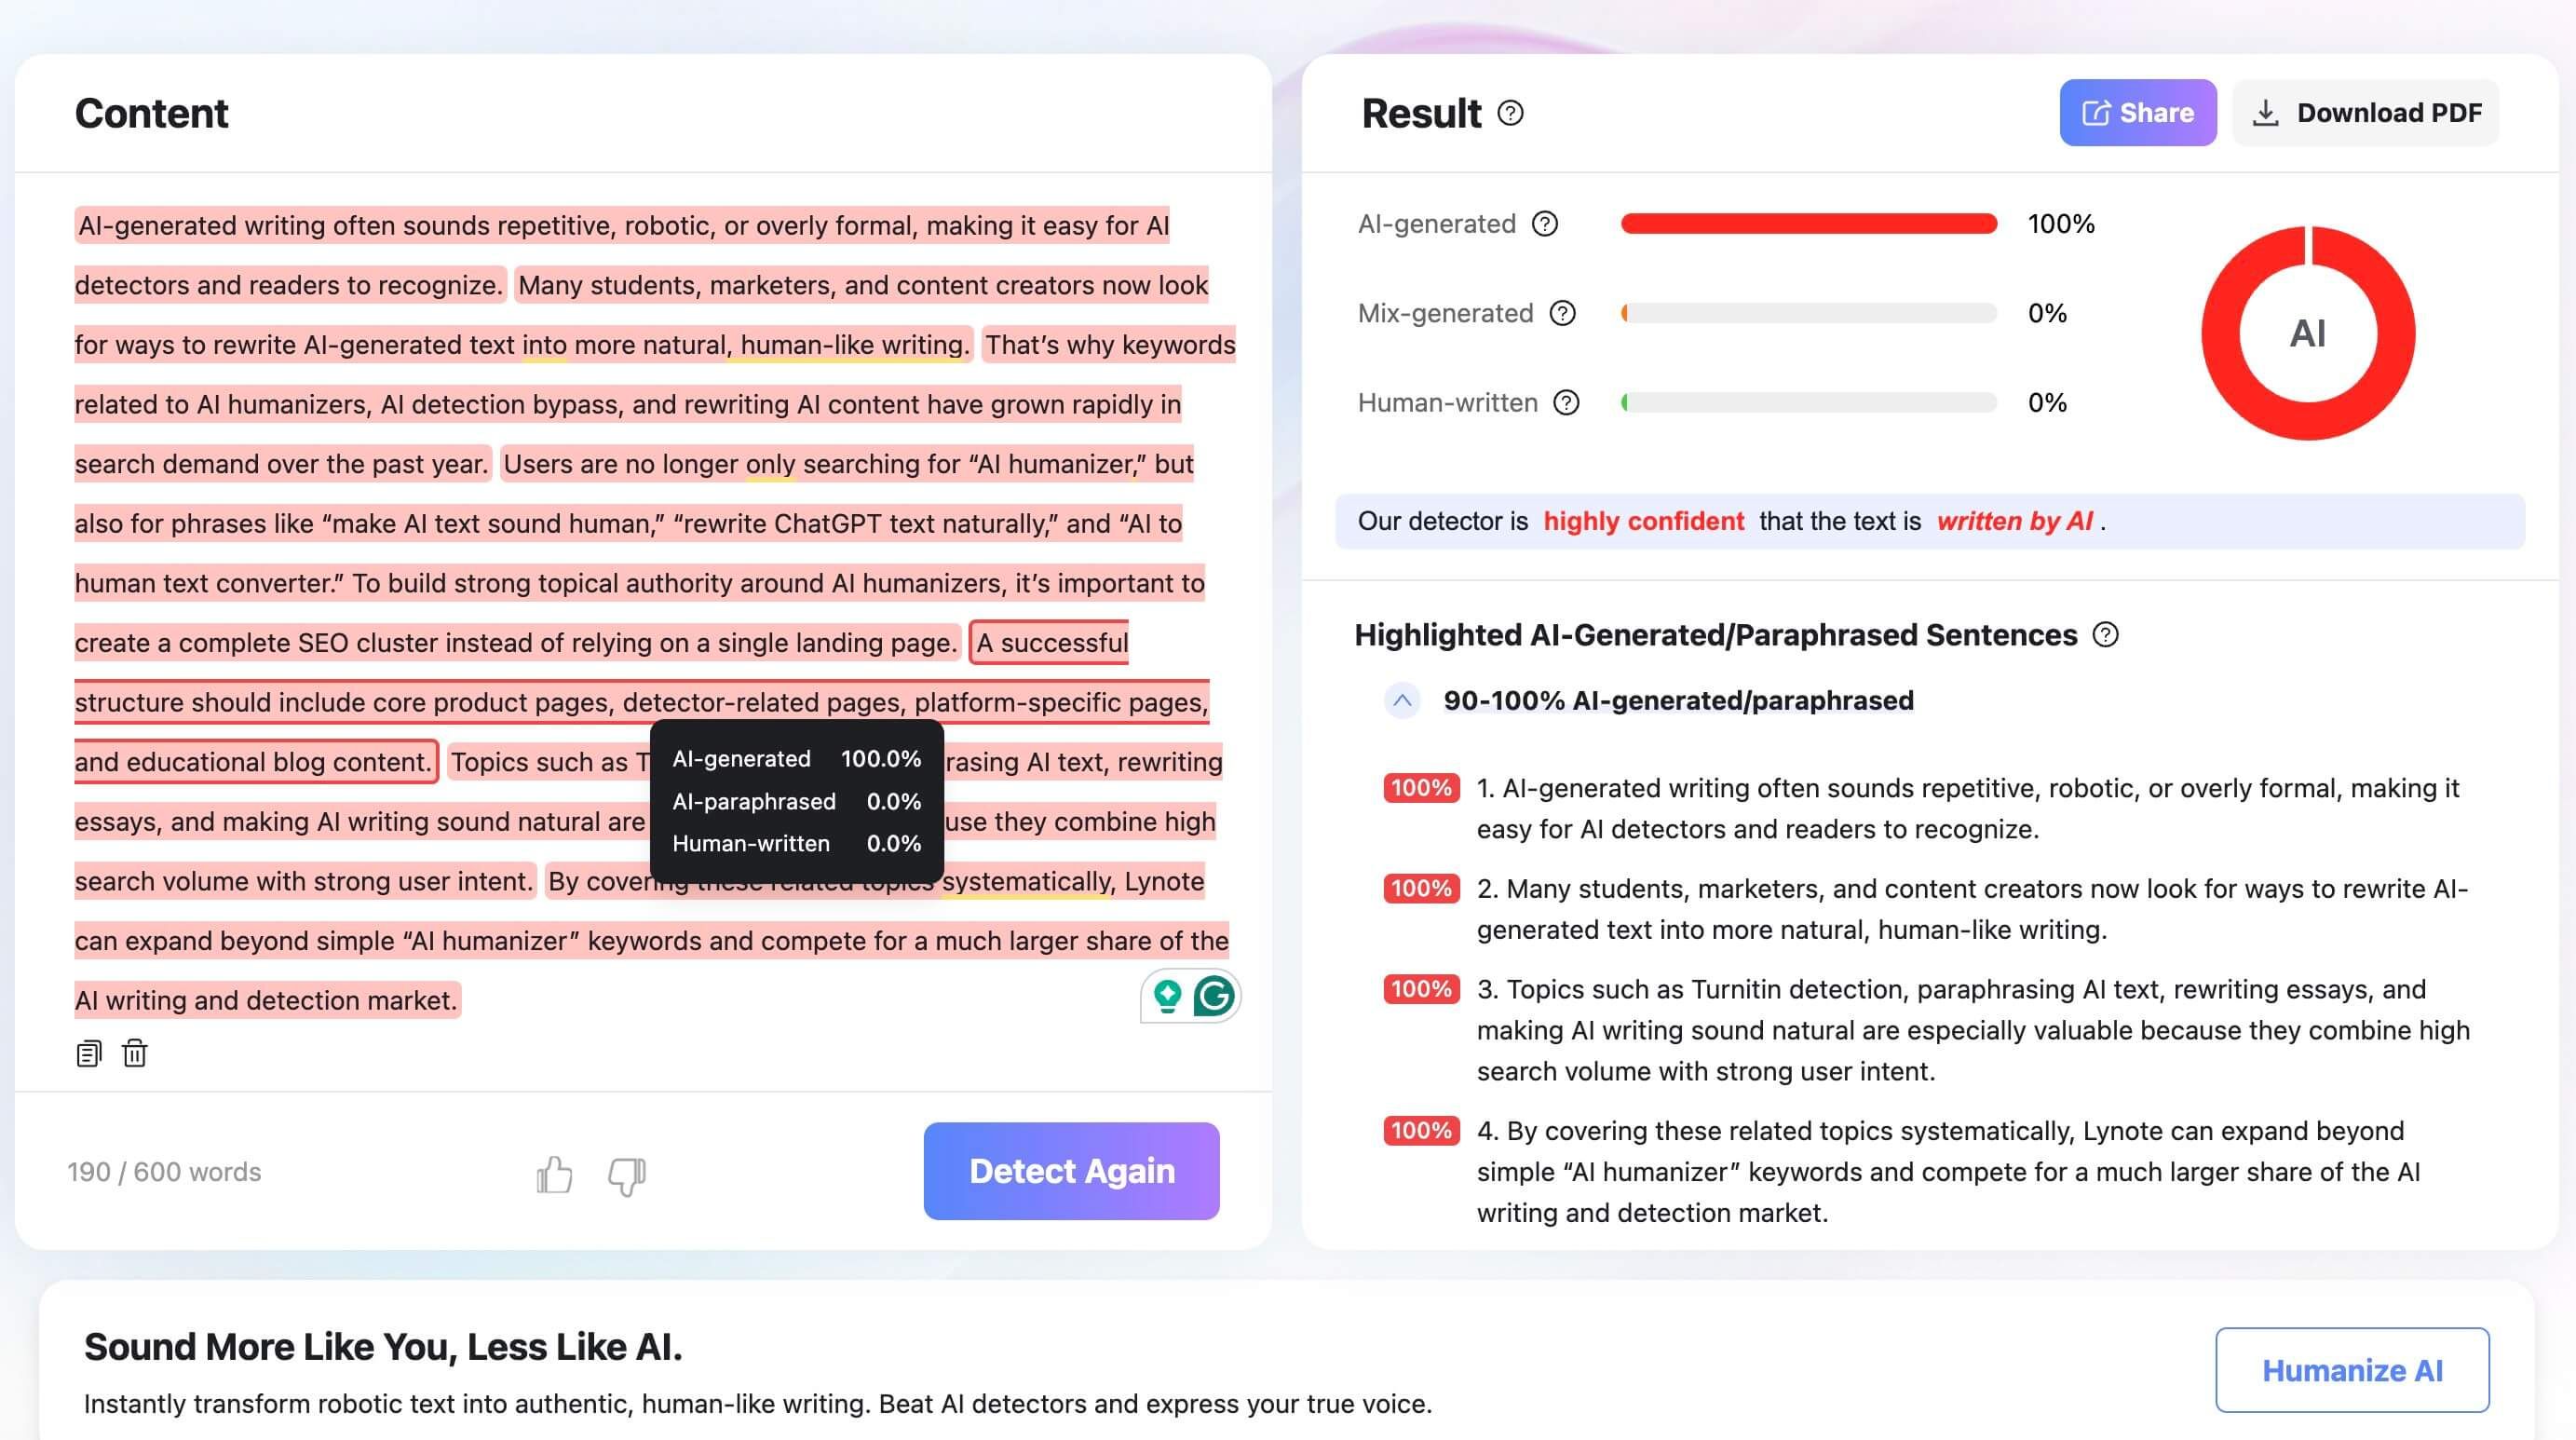
ขั้นตอนสุดท้ายมีความสำคัญที่สุด Lynote สามารถช่วยระบุรูปแบบสำหรับการตรวจสอบได้ แต่ผลลัพธ์ของมันไม่ควรถูกนำเสนอเป็นหลักฐานว่า GPT-5.6 เป็นผู้เขียนเอกสาร
หากเอกสารมีความช่วยเหลือจาก AI ที่ถูกต้องตามกฎหมาย ให้ระบุกระบวนการนั้นอย่างถูกต้อง ร่างที่เริ่มต้นด้วย GPT-5.6 แต่ได้รับการวิจัย ตรวจสอบ และเขียนใหม่โดยบุคคลอย่างมาก ควรได้รับการประเมินแตกต่างจากการตอบสนองของโมเดลที่ไม่ได้ตรวจสอบ แม้ว่าทั้งสองจะกระตุ้นเครื่องมือตรวจจับก็ตาม

นักเรียนและนักเขียนควรอ่านธง GPT-5.6 อย่างไร
ความหมายของธงขึ้นอยู่กับการตัดสินใจที่กำลังทำอยู่ ผู้จัดพิมพ์ที่ตรวจสอบสำเนาที่เข้ามามีความรับผิดชอบที่แตกต่างจากอาจารย์ที่กำลังสอบสวนการประพฤติมิชอบทางวิชาการที่อาจเกิดขึ้น
สำหรับนักเรียน
เก็บหลักฐานกระบวนการเขียนของคุณ: โครงร่าง, บันทึกแหล่งที่มา, ประวัติเอกสาร, ฉบับร่าง, การอ้างอิง และข้อเสนอแนะ หากสถาบันอนุญาตการสนับสนุน AI แบบจำกัด ให้เก็บคำแนะนำและเปิดเผยการใช้งานของคุณตามนโยบายที่เกี่ยวข้อง
เมื่อผลงานของมนุษย์ถูกตั้งค่าสถานะผิดพลาด หลักฐานกระบวนการมักจะน่าเชื่อถือมากกว่าการสแกนข้อความเดิมซ้ำๆ ด้วยเครื่องมือตรวจจับเพิ่มเติม เปอร์เซ็นต์ที่สองไม่ได้สร้างวิธีการเขียนเอกสารขึ้นมาใหม่
สำหรับนักเขียนและผู้จัดพิมพ์
คะแนน AI ไม่ใช่คะแนนคุณภาพ ข้อความ GPT-5.6 อาจมีข้อเท็จจริงที่อ่อนแอหรือไม่เป็นประโยชน์ ในขณะที่ข้อความของมนุษย์อาจไม่ถูกต้อง ลอกเลียนแบบ หรือมีข้อมูลสนับสนุนที่ไม่ดี
การตรวจสอบโดยบรรณาธิการควรรวมถึงการตรวจสอบแหล่งที่มาของข้อเท็จจริง ความคิดริเริ่ม การอ้างอิง น้ำเสียง คุณค่าต่อผู้อ่าน และความรับผิดชอบ คำถามหลักไม่ใช่เพียงแค่ว่าโมเดลมีส่วนร่วมในการสร้างคำหรือไม่ แต่เป็นว่าบุคคลที่มีความรับผิดชอบได้ตรวจสอบและเป็นเจ้าของผลงานสุดท้ายหรือไม่
สำหรับนักการศึกษาและผู้ตรวจสอบ
ใช้การตรวจจับเป็นสัญญาณคัดแยกเบื้องต้นมากกว่าการตัดสินอัตโนมัติ ตรวจสอบการออกแบบงานที่มอบหมาย นโยบาย AI ที่อนุญาต ประวัติเวอร์ชัน แหล่งที่มา กระบวนการเขียน และความสามารถของนักเรียนในการอธิบายผลงาน
ผลลัพธ์จากเครื่องมือตรวจจับเพียงอย่างเดียวไม่ควรกำหนดเกรดหรือผลลัพธ์ทางวินัย ยิ่งผลกระทบสูงเท่าไร หลักฐานอิสระและการตรวจสอบโดยมนุษย์ก็ยิ่งมีความสำคัญมากขึ้นเท่านั้น
รายการตรวจสอบหลักฐานที่ดีกว่าคะแนน AI เพียงอย่างเดียว
การตรวจจับ AI จะมีประโยชน์มากขึ้นเมื่อถูกนำไปใช้ในกระบวนการหลักฐานที่กว้างขึ้น หลักฐานแต่ละประเภทตอบคำถามที่แตกต่างกัน และไม่ควรถูกขยายเกินกว่าสิ่งที่สามารถแสดงได้
| หลักฐาน | สิ่งที่สามารถแสดงได้ | สิ่งที่ไม่สามารถพิสูจน์ได้ด้วยตัวเอง |
|---|---|---|
| ผลลัพธ์เครื่องมือตรวจจับ AI | ข้อความมีรูปแบบที่เกี่ยวข้องกับผลลัพธ์ AI | โมเดลใดสร้างขึ้น หรือใครใช้โมเดลนั้น |
| การเน้นประโยค | ข้อความส่วนใดที่มีอิทธิพลต่อการจัดประเภทมากที่สุด | ประวัติของแต่ละประโยค |
| ประวัติเวอร์ชัน | เอกสารเปลี่ยนแปลงไปอย่างไรเมื่อเวลาผ่านไป | การแก้ไขทุกครั้งทำโดยไม่มี AI หรือไม่ |
| บันทึกและโครงร่าง | การวางแผน การเลือกแหล่งที่มา และการพัฒนาแนวคิด | การเขียนที่แน่นอนของทุกวลีสุดท้าย |
| การอ้างอิงและการตรวจสอบแหล่งที่มา | การอ้างสิทธิ์สามารถตรวจสอบย้อนกลับได้และได้รับการสนับสนุนอย่างรับผิดชอบหรือไม่ | ข้อความร้อยแก้วถูกสร้างขึ้นหรือไม่ |
| บันทึกแพลตฟอร์มหรือ API | โมเดลถูกเข้าถึงหรือสร้างผลลัพธ์ที่บันทึกไว้ | ผลลัพธ์นั้นปรากฏไม่เปลี่ยนแปลงในเอกสารหรือไม่ |
| การสนทนากับผู้เขียน | ความเข้าใจในการให้เหตุผล หลักฐาน และทางเลือก | แหล่งที่มาทางเทคนิคที่สมบูรณ์ |
| การตรวจสอบโดยมนุษย์ | การตัดสินตามบริบทจากหลักฐานที่มีอยู่ทั้งหมด | ความแน่นอนสมบูรณ์ในทุกกรณี |
การตรวจสอบที่เป็นธรรมจะถามว่าหลักฐานสอดคล้องกันหรือไม่ หากธงของเครื่องมือตรวจจับขัดแย้งกับประวัติการร่างที่ครอบคลุม บันทึกต้นฉบับ แหล่งที่มาที่ได้รับการยืนยัน และคำอธิบายที่น่าเชื่อถือ ความขัดแย้งนั้นควรได้รับการสอบสวนแทนที่จะแก้ไขโดยอัตโนมัติเพื่อสนับสนุนซอฟต์แวร์
ในทางกลับกันก็เป็นจริงเช่นกัน หากการตอบสนองของโมเดลที่ไม่มีการแก้ไขถูกนำเสนอว่าเป็นผลงานของมนุษย์ที่เป็นอิสระ และผลลัพธ์ของเครื่องมือตรวจจับสอดคล้องกับการขาดฉบับร่าง การอ้างอิงที่สร้างขึ้น และความไม่สามารถอธิบายข้อโต้แย้งได้ คะแนนนั้นอาจมีส่วนช่วยให้ภาพหลักฐานโดยรวมชัดเจนขึ้น
คำถามที่พบบ่อยเกี่ยวกับการตรวจจับ GPT-5.6
Turnitin สามารถตรวจจับ GPT-5.6 ได้หรือไม่?
Turnitin อาจจัดประเภทผลลัพธ์ GPT-5.6 ว่าสร้างโดย AI หากข้อความมีรูปแบบที่โมเดลปัจจุบันของ Turnitin จดจำได้ อย่างไรก็ตาม ผลลัพธ์เฉพาะของ GPT-5.6 ที่เผยแพร่โดยเครื่องมือตรวจจับอื่นไม่สามารถถือเป็นความแม่นยำของ Turnitin ได้ และผลลัพธ์ของ Turnitin ไม่ควรใช้เป็นหลักฐานเดียวในการพิสูจน์การเป็นผู้เขียน
GPTZero สามารถตรวจจับ GPT-5.6 ได้หรือไม่?
GPTZero ได้รับการออกแบบมาเพื่อตรวจจับการเขียนที่สร้างโดย AI และอาจตั้งค่าสถานะเนื้อหา GPT-5.6 ประสิทธิภาพของมันอาจแตกต่างกันไปตามความยาวของข้อความ ประเภท การแก้ไข และการอัปเดตโมเดล ดังนั้นคะแนนควรถือเป็นสัญญาณมากกว่าการระบุแหล่งที่มาของ GPT-5.6 ที่แน่นอน
GPT-5.6 Sol ตรวจจับได้ง่ายกว่า Terra หรือ Luna หรือไม่?
การศึกษาของผู้จำหน่ายในปัจจุบันไม่ได้สร้างการจัดอันดับที่มีความหมายที่สอดคล้องกัน ตัวเลขที่รายงานโดย Originality.ai แตกต่างกันเล็กน้อยตามโหมดตรวจจับ ในขณะที่ Pangram รายงานอัตราการจัดประเภท AI ทั้งหมดสูงกว่า 99 เปอร์เซ็นต์สำหรับทั้งสามระดับ
ข้อความ GPT-5.6 ที่แก้ไขแล้วยังสามารถตรวจจับได้หรือไม่?
ใช่ การแก้ไขไม่ได้รับประกันการจัดประเภทว่าเป็นงานของมนุษย์ โดยเฉพาะอย่างยิ่งเมื่อโครงสร้างและถ้อยคำดั้งเดิมส่วนใหญ่ยังคงอยู่ การมีส่วนร่วมของมนุษย์จำนวนมากอาจสร้างสัญญาณผสม ทำให้ประวัติเอกสารและการตรวจสอบตามบริบทมีความสำคัญ
การเขียนของมนุษย์สามารถถูกตั้งค่าสถานะผิดพลาดว่าเป็น GPT-5.6 ได้หรือไม่?
การเขียนของมนุษย์สามารถได้รับการจัดประเภท AI ที่ผิดพลาดได้ โดยเฉพาะอย่างยิ่งเมื่อข้อความสั้น เป็นสูตรสำเร็จ เป็นมาตรฐานสูง ถูกแปล หรือเขียนในรูปแบบที่ไม่ได้ถูกนำเสนออย่างเพียงพอในข้อมูลการฝึกอบรมของเครื่องมือตรวจจับ เครื่องมือตรวจจับโดยทั่วไปไม่สามารถระบุผลบวกปลอมว่าเป็น “GPT-5.6” โดยเฉพาะได้ มันจะรายงานการจัดประเภทที่เกี่ยวข้องกับ AI
คะแนน AI สูงสุดพิสูจน์ได้หรือไม่ว่า GPT-5.6 เป็นผู้เขียนข้อความนั้น?
ไม่ คะแนนสูงสุดที่แสดงของเครื่องมือตรวจจับคือความมั่นใจหรือผลลัพธ์การจัดประเภทภายใต้ระบบการให้คะแนนของมันเอง มันไม่ได้พิสูจน์แหล่งที่มาของโมเดลที่แน่นอน ระบุผู้ใช้ หรือใช้แทนหลักฐานสนับสนุน
GPT-5.6 มีลายน้ำข้อความที่มองไม่เห็นหรือไม่?
ข้อมูลการเปิดตัว GPT-5.6 ต่อสาธารณะไม่ได้ระบุว่าผลลัพธ์ข้อความทั่วไปมีลายน้ำที่สามารถอ่านได้ทั่วโลกซึ่งเครื่องมือตรวจจับสำหรับผู้บริโภคสามารถเข้าถึงได้ เครื่องมือตรวจจับส่วนใหญ่ในปัจจุบันวิเคราะห์รูปแบบทางภาษาและสถิติ แทนที่จะสอบถามบันทึกแหล่งที่มาอย่างเป็นทางการของ OpenAI
GPT-5.6 จะตรวจจับได้ยากขึ้นหลังจากการอัปเดตหรือไม่?
มันอาจจะง่ายขึ้นหรือยากขึ้นสำหรับเครื่องมือตรวจจับบางตัวเมื่อพฤติกรรมของโมเดลและการฝึกอบรมเครื่องมือตรวจจับเปลี่ยนแปลงไป ผลลัพธ์จากเดือนกรกฎาคม 2026 ควรกำหนดวันที่และไม่ควรถือว่าอธิบายถึงการแก้ไข GPT-5.6 หรือเวอร์ชันเครื่องมือตรวจจับในอนาคตทุกครั้ง
คำตัดสินสุดท้าย
GPT-5.6 สามารถตรวจจับได้ในทางปฏิบัติที่เครื่องมือตรวจจับเชิงพาณิชย์ในปัจจุบันมักจะจดจำผลลัพธ์บริสุทธิ์จาก Sol, Terra และ Luna ได้ การศึกษาเบื้องต้นจากผู้จำหน่ายรายงานผลลัพธ์ที่แข็งแกร่งจากตัวอย่างที่สร้างขึ้นหลายพันรายการ ดังนั้นตระกูล OpenAI ใหม่ล่าสุดจึงไม่สามารถมองไม่เห็นโดยอัตโนมัติเพียงเพราะเครื่องมือตรวจจับได้รับการฝึกฝนก่อนการเปิดตัวทั่วไป
สิ่งที่ยังไม่แน่นอนคือการตีความเอกสารจริงฉบับหนึ่ง คะแนนที่สูงไม่สามารถพิสูจน์ได้ด้วยตัวเองว่า GPT-5.6 สร้างข้อความนั้น แยกแยะ Sol จาก Terra หรือ Luna ระบุผู้ใช้ หรือวัดปริมาณการเขียนของมนุษย์
ใช้การตรวจจับเพื่อระบุข้อความที่สมควรได้รับการตรวจสอบ สำหรับการตัดสินใจที่มีผลกระทบ ให้รวมสัญญาณนั้นเข้ากับประวัติเวอร์ชัน บันทึก การอ้างอิง บริบทนโยบาย หลักฐานแพลตฟอร์มเมื่อมี และการตัดสินใจของมนุษย์ที่มีข้อมูล
เขียนโดย Danny
ผู้จัดการฝ่ายการตลาดผลิตภัณฑ์
แดนนี่อธิบายว่าฟีเจอร์ของ Lynote เข้ากับเวิร์กโฟลว์จริงได้อย่างไร ตั้งแต่การทำงานประจำวันไปจนถึงกรณีการใช้งานการเขียนที่ใช้ประโยชน์จากผลิตภัณฑ์ ดูบทความทั้งหมด →