

Kurze Antwort
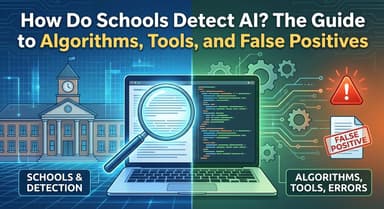
KI-Detektoren schätzen ein, ob ein Text Beispielen von KI-generierten oder von Menschen geschriebenen Inhalten ähnelt. Moderne Systeme können Deep-Learning-Klassifikatoren, satzbasierte Modelle, statistische Merkmale, linguistische Muster oder Kombinationen dieser Methoden verwenden. Die genaue Architektur variiert je nach Anbieter und ist oft proprietär. Da die Ausgabe probabilistisch ist, kann ein Detektor falsch positive und falsch negative Ergebnisse liefern, insbesondere bei kurzen, bearbeiteten, gemischten oder mehrsprachigen Texten.

Moderne Erkennung ist mehr als Perplexität und Burstiness
Perplexität und Burstiness sind nützliche historische Konzepte zur Erklärung von Textvorhersagbarkeit und -variation, sollten aber nicht als die alleinige Grundlage hinter aktuellen KI-Detektoren dargestellt werden. GPTZero gibt beispielsweise an, dass es nach der Einführung einer Deep-Learning-basierten Architektur von der Verwendung von Perplexität und Burstiness zur KI-Erkennung abgewichen ist. Andere Anbieter verwenden möglicherweise andere oder proprietäre Methoden.
Vom Text zur Wahrscheinlichkeit
Ein Detektor wandelt Text typischerweise in modelllesbare Merkmale um, bewertet Muster, die aus menschlichen und KI-Beispielen gelernt wurden, und erzeugt eine Wahrscheinlichkeit auf Dokument- oder Satzebene. Die genaue Punktzahl ist keine Tatsache über die Autorenschaft; sie ist die Schätzung des Modells unter Berücksichtigung seiner eigenen Trainingsdaten, Schwellenwerte und Annahmen.
Warum Ergebnisse variieren
Die Ergebnisse können sich je nach Stichprobenlänge, Sprache, dem zur Erstellung des Entwurfs verwendeten KI-Modell, dem Umfang der menschlichen Bearbeitung, domänenspezifischem Schreiben und der aktuellen Version des Detektors ändern. Deshalb kann derselbe Absatz von verschiedenen Diensten unterschiedliche Bewertungen erhalten.
Häufig gestellte Fragen
Wissen KI-Detektoren, wer den Text geschrieben hat?
Nein. Sie klassifizieren Muster im eingereichten Text; sie beobachten den Schreibprozess nicht.
Warum sind sich verschiedene Detektoren uneinig?
Sie verwenden unterschiedliche Modelle, Schwellenwerte, Trainingsdaten und Dokumentregeln.
Werden Perplexität und Burstiness noch verwendet?
Einige Systeme verwenden möglicherweise verwandte statistische Merkmale, aber sie sind keine universelle Beschreibung der modernen KI-Erkennung.
Weiterführende Lektüre
-
Wie erkennt GPTZero KI? Aktueller Deep-Learning-Ansatz erklärt
-
5 KI-Detektor-Tools im Vergleich 2026: Funktionen, Zugang und Anwendungsfälle
Quellen
Verfasst von Janet L. Harris
KI-Schreibspezialistin
Janet überprüft KI-Detektoren und Humanisierungstools, wobei sie sich auf Genauigkeit, Einschränkungen und verantwortungsvollen Gebrauch konzentriert. Alle Artikel ansehen →