

是的,GPT-6 Astra 的內容在目前已發布的測試中是可偵測的。 兩項大型供應商研究標記了超過 99% 未經編輯、已知為 AI 生成的樣本,而一項較小的比較研究發現,五種不同的偵測器都標記了同一篇 Astra 論文。這有力地證明,經過潤飾的 Astra 輸出並不會自動對 AI 偵測器隱形。
這並不能證明每個偵測器都能捕捉到所有 Astra 的段落。更重要的是,高分並不能告訴你文件是誰寫的、是哪個模型生成的,或者一個人是否使用了 AI。有用的問題不只是「AI 能偵測到 GPT-6 Astra 嗎?」而是現有證據實際測量了什麼,以及它留下了什麼未解決的問題。
快速解答:GPT-6 Astra 的內容可偵測嗎?
對於未經編輯、長度適中的英文散文,答案通常是肯定的。2026 年 10 月發布的最強公開結果指向相同的方向,儘管它們來自偵測器公司,並使用了不同的樣本、閾值和納入規則。
| 已發布的測試 | 測試的 Astra 材料 | 報告結果 | 確立了什麼 | 未確立什麼 |
|---|---|---|---|---|
| Originality.ai | 1,000 個已知 Astra 回應,涵蓋五種寫作類別 | 999 個超過其 AI 閾值 | 在一個偵測器設定下,對此已知 AI 樣本的偵測率非常高 | 誤報率或對人類寫作的表現 |
| Pangram | 986 個經篩選提示的 Astra 回應 | 982 個為 AI,3 個為混合,1 個為人類 | 對符合條件的段落,完全 AI 分類率非常高 | 低於 50 字最低要求或對人類控制組的表現 |
| 五種偵測器比較 | 一篇 300 字的 Astra 論文 | 5 個工具中有 5 個標記了它;其中 4 個顯示了其最大 AI 分數 | 數個偵測器對該特定論文達成一致 | 來自單一文件樣本的模型整體準確性 |
| 段落長度實驗 | 40 篇 Astra 文本以四種長度顯示 | 25 字時偵測到 9/40,50 字時偵測到 29/40,100 和 200 字時偵測到 40/40 | 長度可以實質性地改變一個偵測器的結果 | 每個偵測器的通用最小長度 |
實際的啟示很簡單:一篇完整的 Astra 文章比從中複製出來的一句話更有可能產生有意義的偵測器訊號。即便如此,「標記」也僅表示該寫作符合偵測器與 AI 相關聯的模式。這並不意味著該工具恢復了隱藏的 GPT-6 標籤。
GPT-6 Astra 改變了什麼,以及沒有改變什麼
OpenAI 將 GPT-6 Astra 定位為其在嚴苛推理、研究、編碼、電腦使用和文件創建方面最為強大的模型。它旨在遵循詳細指令並維持複雜工作,這可以產生比刻板印象中的聊天機器人答案更連貫和有用的草稿。
該模型自身的文檔也指出,除非用戶指定不同的寫作風格,否則它傾向於詳細的格式和重複的短語。這一觀察有助於解釋為什麼改進的能力和可偵測性可以並存。一份文件可能準確、組織良好且流暢,同時仍然顯示出統計分類器會注意到的規律性。
這正是人們經常犯錯的地方。更好的散文不一定在偵測器看來更像人類寫的,因為偵測器並不是根據散文的智慧或實用性來評分。它們是在評估其語言模式是否與其 AI 和人類訓練數據中的材料相似。
笨拙的寫作也不會自動被認定為 AI 寫作。人類也會重複過渡詞、使用公式化的論文結構,並寫出通用句子。偵測器讀取的是模式,而不是意圖、作者身份或游標背後的歷史。
已發布的 GPT-6 Astra 偵測測試發現了什麼
這些頭條研究看起來非常一致。然而,它們的方法回答的問題比頭條有時暗示的要窄。
Originality.ai:1,000 個回應中有 999 個超過閾值
Originality.ai 生成並掃描了 1,000 個英文 Astra 回應:200 篇部落格、200 篇對話式文章、200 篇說明性回應、200 篇新聞回應和 200 篇評論。它將在 AI Allowance 15% 模式下得分至少 0.50 視為已偵測到。
所有部落格、說明性、新聞和評論樣本都超過了該閾值。對話類別在 200 個中返回了 199 個偵測結果,總計 1,000 個中產生了 999 個。唯一低於閾值的結果是對話式寫作。
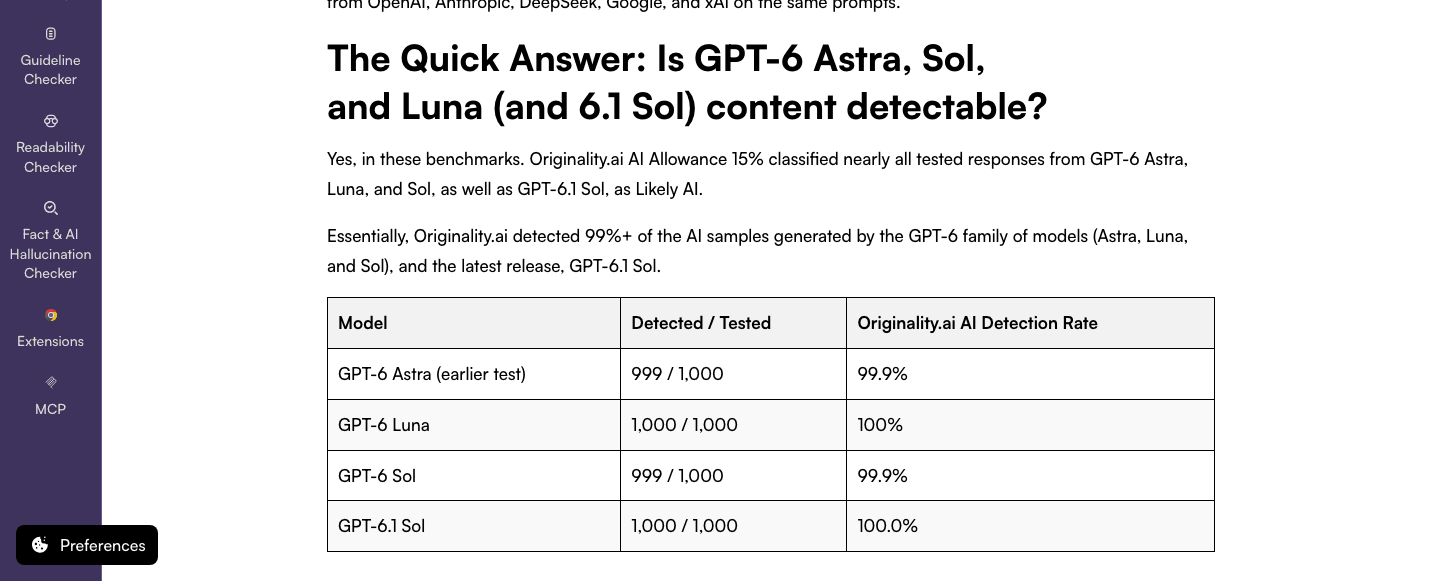
這對於該偵測器和設定來說,是一個強大的已知 AI 偵測結果。這並非一項完整的準確性研究,因為沒有匹配的人類寫作集合。如果沒有人類負面樣本,該研究無法顯示相同的偵測器可能多久會標記一個人。
Pangram:四個輸出未被完全歸類為 AI
Pangram 最初使用了 1,032 個 Astra 回應,這些回應來自經過篩選的第一輪 Chatbot Arena 提示。它沒有對少於 50 個字的 46 個回應進行評分,留下了 986 個符合條件的段落。
在這些段落中,982 個被歸類為 AI,3 個為混合,1 個為人類。非 AI 結果包括簡短或創意格式,例如電子郵件、解釋和詩歌。這個細節很重要,因為這些遺漏並非均勻分佈在一組統一的長篇論文中。
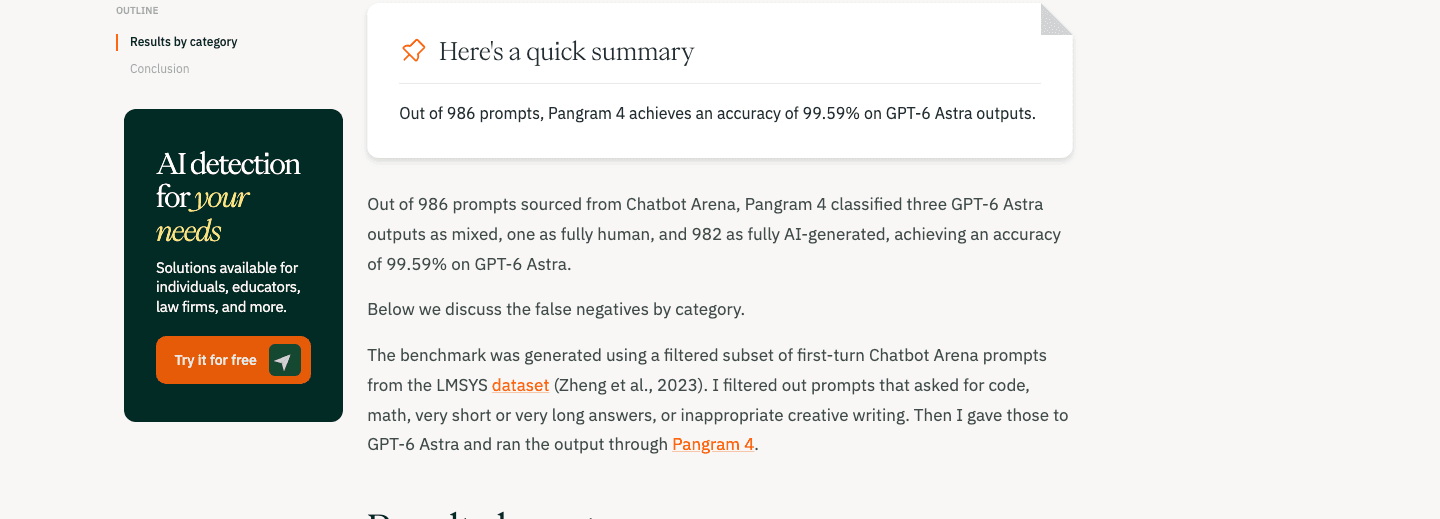
這項研究支持了符合 Pangram 長度要求的 Astra 文本具有高偵測率。它沒有告訴我們被排除的簡短答案會如何評分,而且它再次沒有包含用於估計誤報的人類對照組。
五種偵測器對一篇 Astra 論文達成一致
一項較小的研究選取了一篇 300 字的 Astra 論文,並使用 Phrasly、GPTZero、Pangram、Copyleaks 和 QuillBot 進行掃描。每個工具都標記了這篇論文。其中四個返回了其顯示的最大 AI 分數,而 QuillBot 返回了 82% 的 AI 分數。
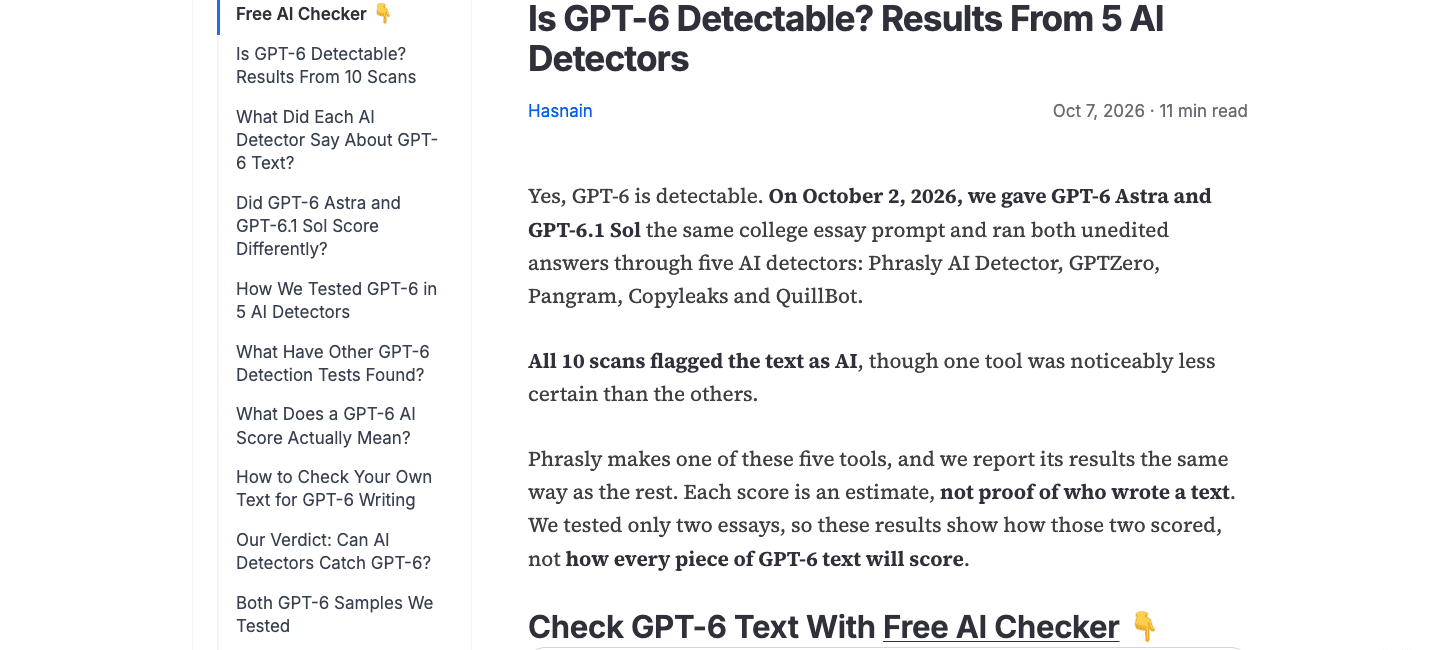
這項比較很有用,因為它在改變偵測器的同時保持文本不變。它表明工具之間達成一致是可能的,但也表明它們的百分比不可互換。82% 的分數和最高分數可以導致相同的實際標籤,但來自不同的模型和尺度。
一篇論文無法確立五種偵測器在部落格、電子郵件、技術報告和編輯草稿方面的表現。這是一個跨工具的快照,而不是排名。
相同文本在縮短後變得更難偵測
最具啟發性的結果可能是最小的研究。研究人員選取了 40 篇已知的 Astra 段落,並向相同的偵測器展示了每篇段落的前 25、50、100 或 200 個字。只有可見文本的數量發生了變化。
在 25 個字時,40 篇段落中有 9 篇被偵測到。在 50 個字時,40 篇中有 29 篇被偵測到。在 100 和 200 個字時,所有 40 篇都超過了閾值。
這並未確立一個通用的 100 字規則。它確實顯示了為什麼檢查一個孤立的句子會產生錯誤的安心感:偵測器可能沒有足夠的語言來找到穩定的模式。
我們的重新分析:99.9% 的偵測率不等於 99.9% 的實際準確性
已發布的計數允許進行有用的獨立計算。樣本結果是一個估計值,因此我們重新計算了近似的 95% Wilson 信賴區間,而不是將每個百分比視為精確值。
| 已發布的計數 | 觀察到的比率 | 近似 95% 信賴區間 | 謹慎解釋 |
|---|---|---|---|
| Originality.ai:999/1,000 | 99.90% | 99.44%-99.98% | 在報告設定下,對已知 Astra 樣本的偵測率很高 |
| Originality.ai 對話式:199/200 | 99.50% | 97.22%-99.91% | 結果強勁,但由於類別樣本較小,精確度較低 |
| Pangram 完全 AI:982/986 | 99.59% | 98.96%-99.84% | 在符合條件的評分輸出中,完全 AI 分類率很高 |
這些區間強化了報告的已知 AI 偵測率很高的結論。它們並未補足實驗中缺失的一半。
要在現實世界中衡量偵測器,我們需要 AI 和人類文件。這是唯一能判斷工具是否能在不誤判太多人的情況下捕捉到 AI 的方法。
| 指標 | 僅限 Astra 的研究能否計算? | 為何重要 |
|---|---|---|
| 對已知 AI 文本的偵測率 | 是 | 顯示工具捕捉到給定 AI 樣本的頻率 |
| 假陰性率 | 是 | 顯示在測試規則下錯過了多少已知 AI 樣本 |
| 特異性 | 否 | 需要人類文本來衡量人類作品被正確清除的頻率 |
| 假陽性率 | 否 | 需要人類文本來計算人們被錯誤標記的頻率 |
| 精確度 | 否 | 取決於假陽性以及 AI 文本在被檢查人群中的普遍程度 |
| 整體準確性 | 否 | 需要正例和反例,以及定義的類別平衡 |
將 1,000 個中的 999 個稱為「99.9% 準確性」悄悄地假設唯一的可能錯誤是遺漏 AI。在教室、新聞編輯室或招聘流程中,錯誤地標記人類是一個不同且通常更具後果的錯誤。僅限 Astra 的測試並非旨在衡量這一點。
為什麼相同的 GPT-6 Astra 文本會得到不同的分數
偵測器結果對其面前的文件很敏感。單憑模型名稱無法預測最終分數。
段落長度改變了可用訊號。 一封 20 字的電子郵件和一份 1,000 字的報告可能來自同一個模型,但提供的證據量卻大相徑庭。對短篇摘錄的低分尤其需要謹慎解釋。
文體改變了語言模式。 在 Originality.ai 的測試中,對話式寫作是唯一一個被遺漏的。Pangram 的非完全 AI 分類包括詩歌、電子郵件和簡短解釋等格式。針對論文校準的偵測器在處理對話或創意散文時可能會表現不同。
提示塑造了輸出。 Astra 可以遵循關於語氣、結構、受眾和範例的詳細限制。使用相同模型的兩個人可能會收到節奏和具體性截然不同的文本。
偵測器版本和閾值不同。 每個工具都定義了自己的標籤、訓練數據、最小長度和決策閾值。一個服務的百分比不能與另一個服務的分數逐點比較。
人工編輯改變了審查中的文本。 添加原始證據、重新組織論點、糾正事實以及根據個人知識重寫可以改變統計模式。這並不能提供避免偵測的可靠方法,也不會消除在政策要求時披露 AI 使用的必要性。
偵測器能判斷是 GPT-6 Astra 寫的嗎?
不能。典型的文本偵測器不會識別產生段落的確切模型。在跨偵測器比較中的五個工具都沒有指明 Astra;它們返回的是 AI、混合、人類或機率分數的變體。
| 問題 | 文本偵測器能回答嗎? |
|---|---|
| 這段文字是否與 AI 寫作相關的模式相似? | 它可以估計,但存在不確定性。 |
| AI 是否參與了寫作過程中的某個環節? | 單憑最終文本無法可靠判斷。 |
| 這段文字是否由 GPT-6 Astra 專門生成? | 否。分數無法識別確切的模型。 |
| 誰輸入了提示或編輯了輸出? | 否。該歷史資訊不在文本之外。 |
| 該文件是否違反了學校或工作場所政策? | 否。這需要政策、上下文和人類判斷。 |
因此,最站得住腳的措辭是「該段落被標記為類似 AI 生成」,而不是「偵測器證明這是由 GPT-6 Astra 寫的」。
如何使用 Lynote 檢查 GPT-6 Astra 文本
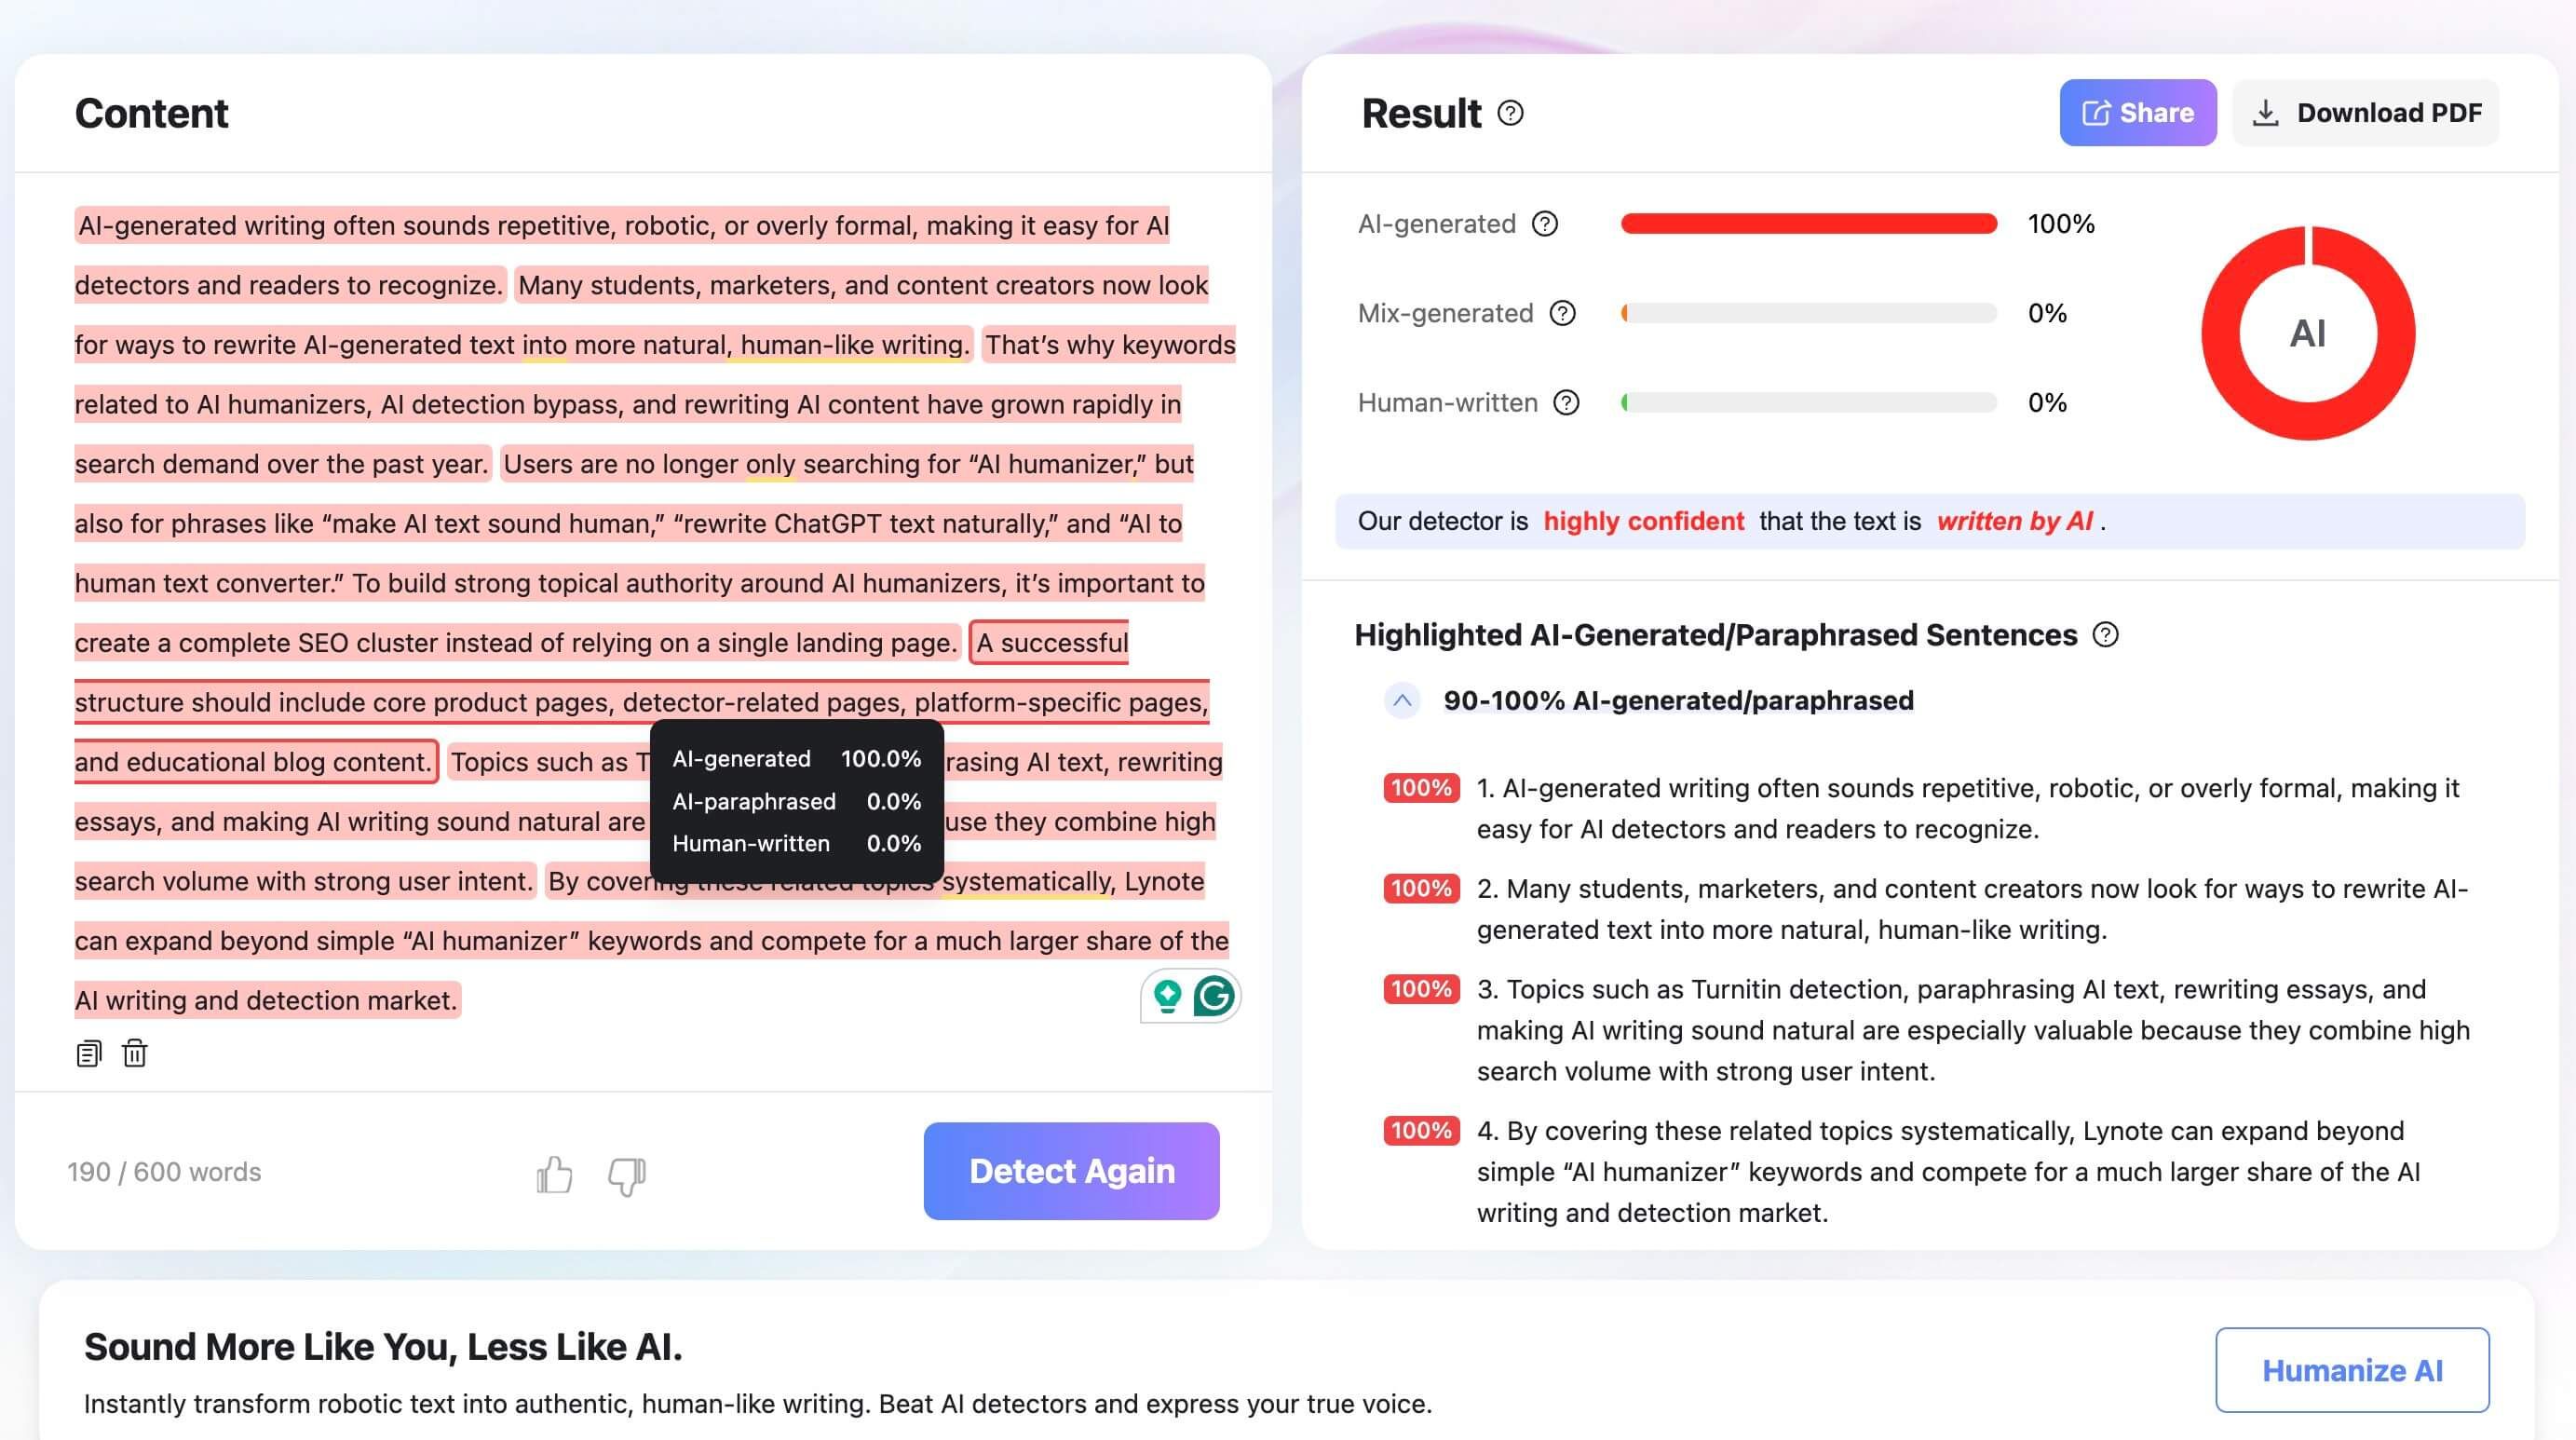
如果您想審查完整的草稿,而不是從幾句話中猜測,Lynote AI 偵測器 提供了一個簡單的初步工作流程。它將結果分為 AI 生成、混合和人類寫作的百分比,並突出顯示句子以供仔細審查。
-
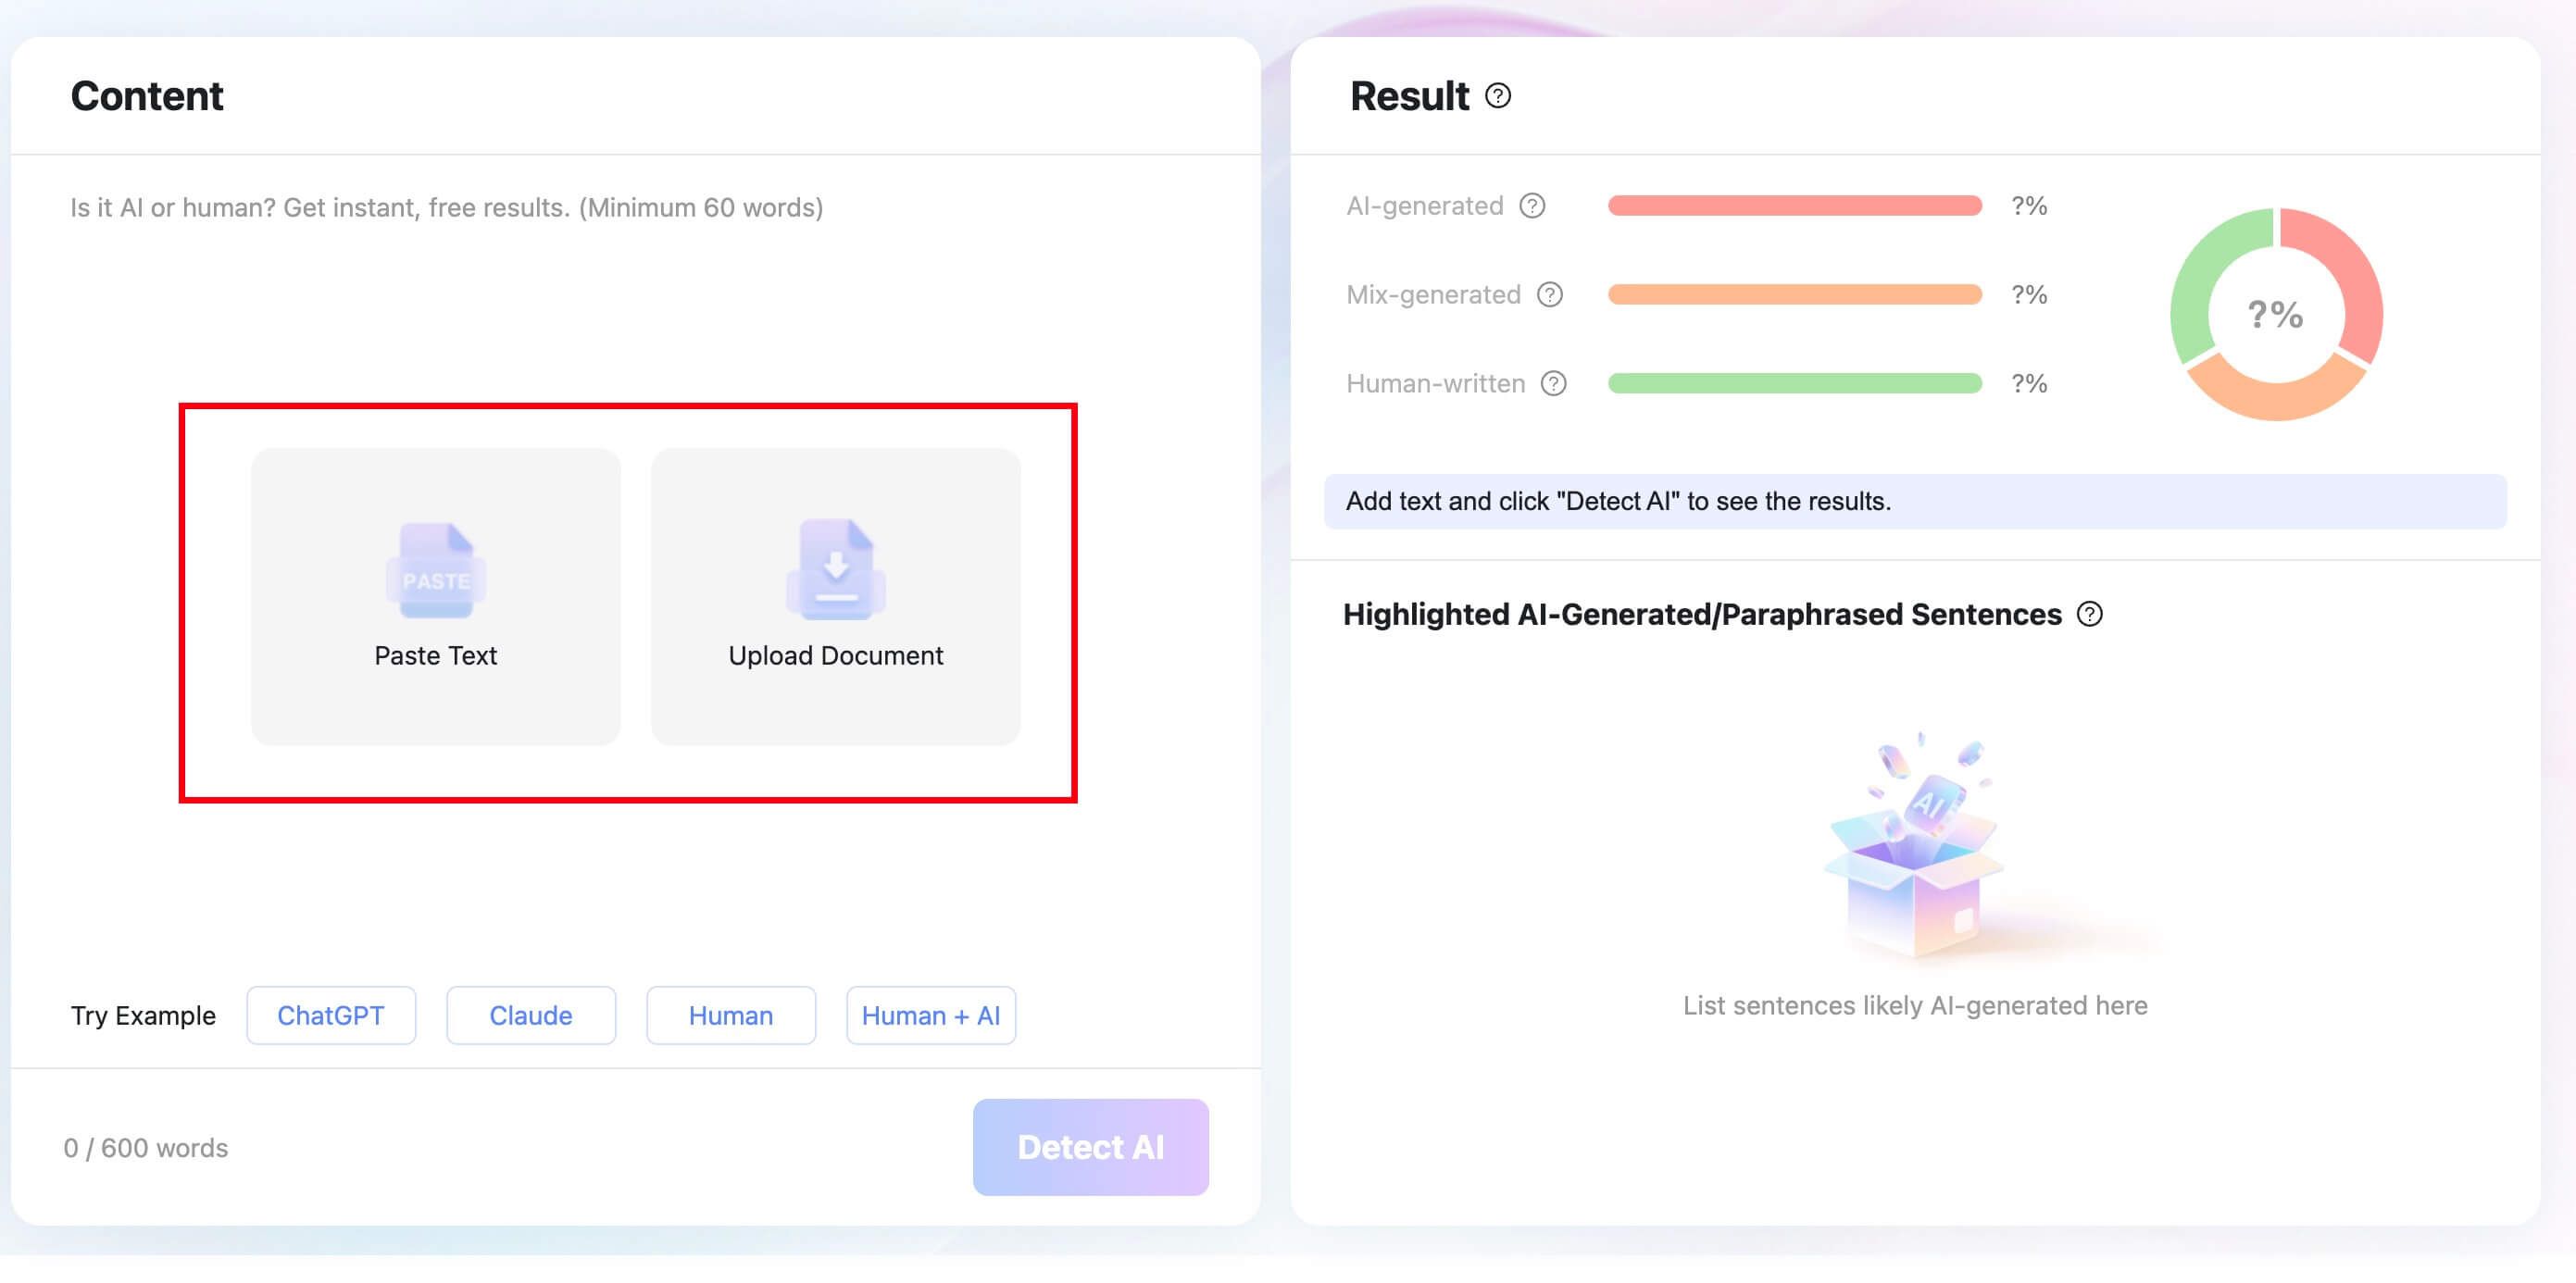
貼上文本或上傳文件。 使用文本框進行快速檢查,或上傳支援的 DOCX、PDF 或 TXT 文件。盡可能提交有意義的段落,而不是孤立的單行。
-
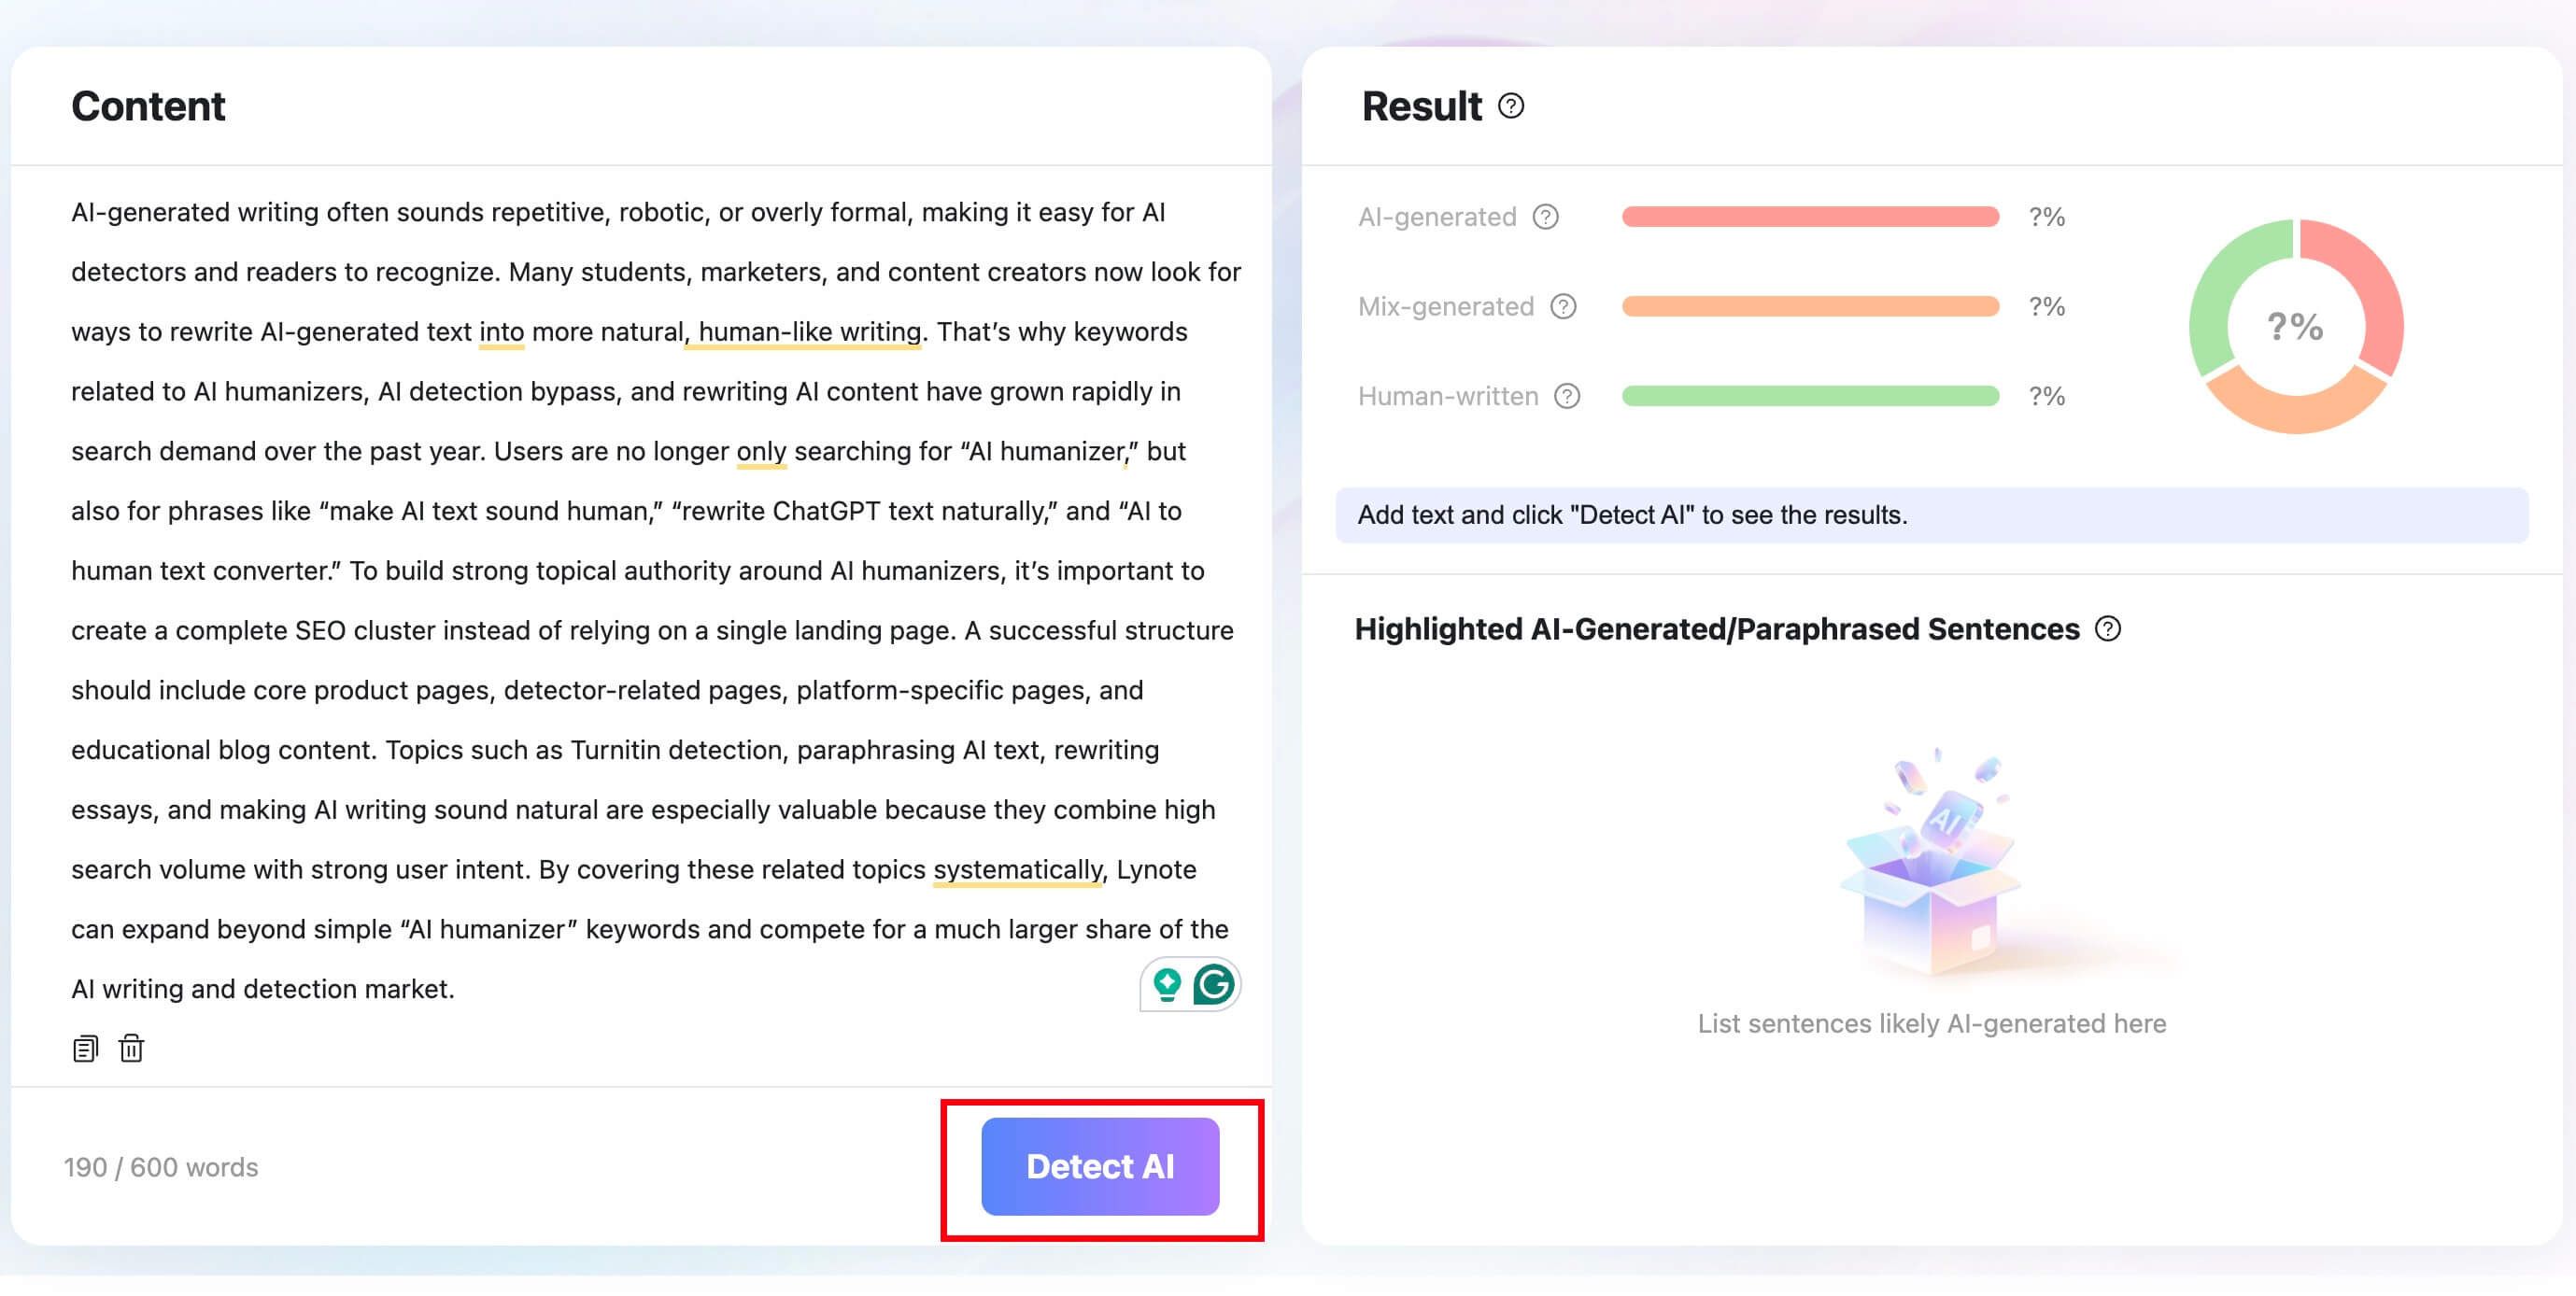
執行掃描。 點擊偵測 AI,讓工具分析提交的文本。
-
審查完整結果。 同時閱讀 AI、混合和人類百分比,然後檢查突出顯示的句子,而不是只對最大的數字做出反應。
-
將訊號與偵測器外部的證據進行比較。 在得出結論之前,查看草稿、版本歷史、引用來源、筆記和作者的解釋。
結果可以告訴您從何處著手。它無法告訴您文件是誰寫的,也無法判斷是否允許使用 AI。

如何解讀高或低的 AI 分數
分數只有在改變您接下來的審查方式時才有用。
| 如果分數很高 | 如果分數很低 |
|---|---|
| 在上下文中閱讀突出顯示的段落。 | 不要將結果視為人類寫作的證據。 |
| 檢查主張、引文、範例和語氣的異常轉變。 | 檢查段落是否太短,無法得出穩定結果。 |
| 將文件與早期草稿或版本歷史進行比較。 | 請記住,偵測器可能會遺漏 AI 文本,模型更新可能會改變性能。 |
| 向作者詢問過程,而不是將分數作為判決。 | 如果作者身份或政策合規性很重要,請使用其他證據。 |
| 對於重大決策,請求第二次人工審查。 | 避免僅憑一次掃描就宣布文件「經證實為人類寫作」。 |
對於審查自己作品的作者來說,高分並不是隨意替換或故意添加錯誤的指示。更好的回應是驗證每個主張,用具體證據替換通用填充詞,並確保最終論點反映您自己的理解。
對於教育工作者和編輯來說,偵測器應該是審查的開始,而不是結束。過程證據通常比最終草稿附帶的機率更能說明問題。
誤報問題仍然重要
高已知 AI 偵測率和誤報可能同時存在。一個偵測器可能在某個基準測試中捕捉到幾乎所有 Astra 樣本,但仍然難以處理特定類型的人類寫作。
史丹佛大學的研究人員先前發現,廣泛使用的 GPT 偵測器經常錯誤地將非英語母語作者的寫作歸類為 AI 生成。一項最近的 2026 年研究檢查了 135,389 對經過專業英語編輯前後的人類手稿。在 13 個偵測器中,報告的誤報率涵蓋了所有可能的範圍,並且相同的編輯更改將不同的偵測器推向了相反的方向。
這並不意味著每個偵測器都毫無用處。這意味著風格可能成為一個混淆變量:正式的措辭、一致的語法、有限的詞彙或專業編輯都可能影響分數,即使作者身份沒有改變。
Turnitin 自己的指導方針也反映了這種不確定性。它將其 AI 報告描述為一個數據點,並表示它不旨在單獨提供明確的答案。
這也是教育之外的明智建議。成績、工作、出版決定或指控不應僅憑一個不透明的百分比來判斷。
關於 GPT-6 Astra AI 偵測的常見問題
Turnitin 能偵測到 GPT-6 Astra 嗎?
當寫作符合其系統與 AI 相關聯的模式時,Turnitin 可能會標記由較新語言模型生成的文本。然而,本文審查的公開 Astra 專用 Turnitin 基準測試並未確立偵測率,且 Turnitin 表示其報告不應單獨用作明確答案。
AI 偵測器能具體識別 GPT-6 Astra 嗎?
不能。目前的偵測器結果通常估計文本看起來是 AI 生成、混合還是類似人類寫作。它們無法可靠地將 Astra 識別為確切的模型,也無法揭示提示和編輯歷史。
編輯 GPT-6 Astra 文本會改變其分數嗎?
會。有意義的人工編輯會改變措辭、結構、證據和語氣,這可能會改變偵測器的模式估計。方向是不可預測的,編輯應該旨在提高準確性和作者質量,而不是操縱分數。
偵測器需要多少文本?
要求因工具而異。在一項 Astra 實驗中,相同段落的偵測率從 25 個字時的 40 篇中的 9 篇上升到 50 個字時的 40 篇中的 29 篇,以及 100 個字時的全部 40 篇。該結果屬於一個偵測器,但它顯示了為什麼完整的段落比單個句子提供更多資訊。
最高可能的 AI 分數能證明 Astra 寫了這段文本嗎?
不能。這是偵測器在其自身模型和尺度下的最強分類。它不能證明使用了哪個 AI 模型、誰使用了它,或者一個人是否實質性地編輯了文件。
人類寫作會被標記為 GPT-6 內容嗎?
人類寫作可能會收到類似 AI 的分數,特別是當偵測器對風格而不是來源做出反應時。非英語母語寫作、高度標準化的學術散文和專業編輯過的文本尤其需要謹慎,因為研究已記錄了不一致的誤報。
低分能證明是人類寫的文本嗎?
不能。低分意味著偵測器沒有找到足夠的與 AI 相關的證據來超過其閾值。短段落、不尋常的文體和編輯過的 AI 輸出都可能降低偵測信心。
最終判決
GPT-6 Astra 在目前可用的最強公開測試中是可偵測的。Originality.ai 標記了 1,000 個已知 Astra 輸出中的 999 個,Pangram 將 986 個符合條件的輸出中的 982 個完全歸類為 AI,並且五個獨立的偵測器對一篇未經編輯的 Astra 論文達成了一致。
這些結果支持一個狹隘的結論:目前的偵測器通常可以識別未經編輯的長篇 Astra 散文。它們並未顯示每個偵測器都同樣可靠,短篇或編輯過的文本會以相同方式表現,或者分數能證明作者身份。
將 AI 偵測用作初步篩選。給予工具足夠的文本,閱讀突出顯示的段落,然後檢查分類器無法看到的證據:草稿、來源、上下文、寫作歷史以及作品背後的人。