

是的。由 GPT-5.6 生成的純粹、未經編輯的文本,通常可以被目前的商業 AI 偵測器偵測到。涵蓋 GPT-5.6 Sol、Terra 和 Luna 的早期供應商研究報告指出,其辨識率很高,在多種測試配置中,結果甚至超過 96%。
這個答案需要一個重要的限定條件。AI 偵測器可以識別類似機器生成寫作的模式,但通常無法證明 GPT-5.6 生成了特定文件、識別使用它的人,或重建最終文本中包含了多少人類工作。
這種差異很重要。「這段文字看起來是 AI 生成的」是一種機率分類;「GPT-5.6 寫了這段文字」則是一種來源聲明。現有證據對第一個結論的支持遠強於第二個。
快速解答:GPT-5.6 可被偵測嗎?
當輸入內容足夠長、主要由 AI 生成,並且接近模型的原始輸出時,GPT-5.6 內容是可被偵測的。 Originality.ai 和 Pangram 都在 2026 年 7 月模型系列普遍可用後不久,發布了針對 GPT-5.6 的評估報告。
然而,這些測試並未為所有 GPT-5.6 輔助文件建立通用的偵測率。實際寫作可能結合模型輸出與人類規劃、原創報導、引文、修訂、引用、翻譯和協作編輯。
| 問題 | 實際答案 |
|---|---|
| AI 偵測器能識別純粹的 GPT-5.6 輸出嗎? | 通常可以 |
| Sol、Terra 和 Luna 都經過公開測試了嗎? | 是的,在供應商發布的研究中 |
| 偵測器能將 GPT-5.6 識別為確切來源嗎? | 通常不能 |
| 高 AI 分數能證明不當行為嗎? | 不能 |
| 編輯過或混合的文本會產生不同的分數嗎? | 會 |
| 人類寫作會收到誤報嗎? | 會 |
因此,最站得住腳的結論是有條件的:在許多測試條件下,GPT-5.6 可以被偵測為類似 AI 的文本,但偵測並不等同於確切的歸屬。
GPT-5.6 的意義:Sol、Terra 和 Luna
OpenAI 於 2026 年 7 月 9 日全面推出 GPT-5.6 系列。與單一模型名稱和輸出配置的發布不同,GPT-5.6 分為三個能力層級:Sol、Terra 和 Luna。
Sol 是用於嚴謹推理和專業工作的旗艦模型。Terra 定位為日常任務的平衡模型,而 Luna 則優先考慮速度和較低的成本。
| GPT-5.6 模型 | OpenAI 定位 | 典型寫作情境 | 為何對偵測很重要 |
|---|---|---|---|
| Sol | 旗艦能力 | 複雜分析、研究、結構化專業寫作 | 更長的推理和更強的指令遵循可能會改變輸出風格 |
| Terra | 平衡的日常模型 | 電子郵件、文章、報告、一般知識工作 | 廣泛使用會產生多樣化的提示和文件類型組合 |
| Luna | 快速、具成本效益的模型 | 大量草稿和例行內容 | 較短或更標準化的輸出可能會產生不同的訊號 |
不應自動假設這些層級具有相同的寫作指紋。它們在冗長程度、句子組織、推理深度以及遵循所要求風格的緊密程度上可能有所不同。
然而,目前的公開結果表明,這三個層級之間的主要區別不足以使其中任何一個廣泛地無法被偵測。在兩項早期供應商評估中,所有三個層級都產生了高比例的 AI 分類。
目前 GPT-5.6 偵測測試的發現
兩項公開測試提供了最清晰的早期證據。它們很有用,因為兩者都涵蓋了 Sol、Terra 和 Luna,但應將其視為供應商報告的評估,而非獨立認證。
Originality.ai 的 GPT-5.6 結果
Originality.ai 使用其四種偵測配置:Lite、Turbo、Academic 和 AI Allowance 評估了 GPT-5.6 的輸出。該公司報告稱,Lite、Turbo 和 Academic 在測試前尚未接受 GPT-5.6 數據的訓練。
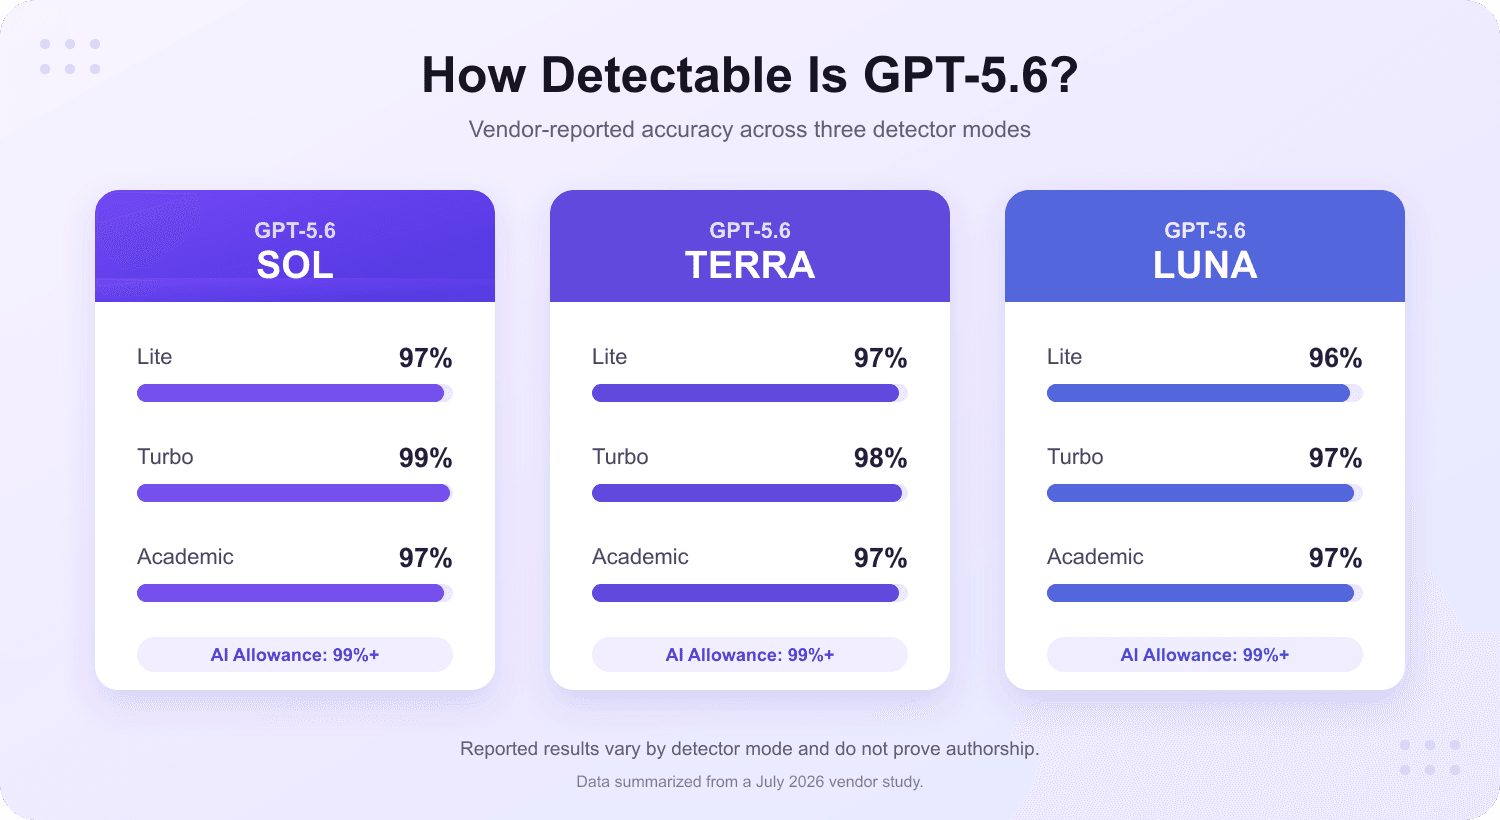
其發布的結果顯示,Sol、Terra 和 Luna 在 Lite、Turbo 和 Academic 配置下的準確度均介於 96% 至 99% 之間。當使用預設的 15% 容許設定時,AI Allowance 在所有三個層級的報告準確度均超過 99%。
| Originality.ai 配置 | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna |
|---|---|---|---|
| Lite | 97% | 97% | 96% |
| Turbo | 99% | 98% | 97% |
| Academic | 97% | 97% | 97% |
| AI Allowance,預設設定 | 99%+ | 99%+ | 99%+ |
Originality.ai 描述了一個由 5,000 份人類撰寫的樣本組成的數據集,涵蓋健康、新聞、金融、科技、藝術和娛樂領域。它使用 GPT-5.6 從與該材料相關的提示中生成補全內容,涵蓋部落格、評論、說明性文章和對話式寫作。
廣泛性很有用,但這篇公開文章並未提供從頭到尾重現該研究所需的所有細節。例如,讀者無法僅從標題表格中推導出每個層級和內容類型的完整混淆矩陣。
Pangram 的 GPT-5.6 結果
Pangram 發布了一項獨立評估,使用了 3,423 個 GPT-5.6 回應。它從每個模型層級收集了 1,141 個回應,並表示其偵測器尚未接受 Sol、Terra 或 Luna 的訓練。
Pangram 將 3,423 個回應中的 3,408 個歸類為完全由 AI 生成,這相當於測試集的 99.56%。其每個模型的完全 AI 分類率為 Sol 99.47%、Terra 99.74% 和 Luna 99.47%。
| Pangram 結果 | GPT-5.6 Sol | GPT-5.6 Terra | GPT-5.6 Luna |
|---|---|---|---|
| 樣本數 | 1,141 | 1,141 | 1,141 |
| 完全分類為 AI | 1,135 | 1,138 | 1,135 |
| 完全 AI 率 | 99.47% | 99.74% | 99.47% |
這些提示要求模型從頭開始生成電子郵件、論文和故事等材料。這是測試偵測器是否能識別直接模型輸出的合理方式,儘管它並不能重現所有真實的寫作工作流程。
兩項研究支持的結論
這些研究使用了不同的數據集和不同的偵測系統,但它們指向相同的方向。新生成、未經編輯的 GPT-5.6 文本通常保留足夠的機器相關模式,足以被歸類為 AI。
| 研究 | 測試材料 | 主要報告結果 | 支持的結論 |
|---|---|---|---|
| Originality.ai | 跨多個領域和格式的 GPT-5.6 補全內容 | 96-99% 或更高,取決於模型和偵測器模式 | 其偵測器可泛化至純粹的 GPT-5.6 輸出 |
| Pangram | 3,423 個生成的回應,平均分佈於各層級 | 總體 99.56% 被分類為完全 AI | 其偵測器可識別該數據集中大多數直接的 GPT-5.6 回應 |
這兩項研究都沒有顯示每個偵測器都表現得同樣好。它們也沒有顯示相同的比率適用於短篇摘錄、協作文件、翻譯段落、大量修訂的草稿,或僅包含有限 AI 輔助的文本。
為何高偵測率無法解決問題
像 99% 這樣的結果聽起來很確定,但它回答的問題比許多讀者想像的要狹窄。它描述的是在特定數據集、特定閾值和測試程序下的表現。
個別文件在沒有這些受控條件的情況下出現。其作者歷史、編輯過程、類型、長度以及 AI 生成語言的比例都可能未知。
測試著重於純粹的模型輸出
目前兩項 GPT-5.6 研究主要評估直接從提示生成的文本。這是衡量偵測器是否識別新模型的最清晰設定,但這並非人們使用 GPT-5.6 的唯一方式。
研究人員可能會使用 Sol 來組織問題,然後獨立撰寫報告。行銷人員可能會使用 Terra 撰寫初稿,然後用訪談、產品事實和原創範例替換其中一半內容。團隊可能會使用 Luna 在一份由多人撰寫的文件中提供句子替代方案。
這些文件不等同於直接從 ChatGPT 或 API 複製的回應。將所有這些文件簡單地稱為「GPT-5.6 文本」會掩蓋作者身份和編輯控制方面的顯著差異。
偵測器自有研究需要仔細閱讀
Originality.ai 和 Pangram 都測試了他們自己的偵測器。這並不表示結果毫無用處;偵測器開發人員通常擁有快速評估新模型所需的基礎設施和緊迫性。
這確實意味著這些數字應準確地描述為供應商報告的結果。更強大的獨立證據將會重現多個偵測器的數據集、閾值和評分程序,同時測量 AI 樣本和真正的人類控制樣本。
誤報性能尤其重要。一個幾乎能捕捉所有 AI 樣本的偵測器,如果它同時錯誤地標記了相當一部分人類寫作,仍然會造成嚴重問題。
準確性不等於標記正確的機率
假設一項測試報告在包含等量人類和 AI 樣本的平衡數據集上達到 97% 的準確度。這個數字並不意味著獲得高分的文檔有 97% 的機率是由 GPT-5.6 撰寫的。
該機率取決於偵測器的誤報率和漏報率、其閾值、文件類型以及在審查人群中 AI 生成文本的普遍程度。這就是基本率問題:基準準確性和個別指控的可靠性不可互換。
對於低風險的內容分類,誤報可能只會觸發另一次審查。但在教育、招聘、出版或合規領域,同樣的誤報可能會帶來更大的後果,因此需要更強的佐證。
偵測器能判斷文本是否由 GPT-5.6 專門撰寫嗎?
大多數公開的 AI 偵測器旨在區分與人類和機器寫作相關的模式。它們通常不是從文本中恢復模型 ID 的鑑識工具。
高分可能與 GPT-5.6 一致,但也可能與另一個 OpenAI 模型、Claude、Gemini、較小的語言模型或公式化的人類散文一致。模型共享訓練影響、常見的指令遵循模式以及對精煉結構的相似傾向。
這產生了三種不同層次的推論:
- 類似 AI 的模式偵測: 該段落類似於偵測器與機器生成相關聯的材料。
- 模型家族懷疑: 該段落可能來自現代語言模型。
- 確切來源: GPT-5.6 Sol、Terra 或 Luna 在特定會話中生成了該段落。
目前的消費者偵測器可以為第一層提供證據。它們可能支持第二層的謹慎假設,但很少能確立第三層。
確切來源需要文本本身以外的證據,例如平台日誌、API 記錄、文件歷史、帳戶活動或可靠的加密來源系統。單憑語言分數無法包含該監管鏈。
哪些因素會改變 GPT-5.6 的偵測結果?
偵測器的行為並非對每個樣本都固定不變。當提示、類型、長度、推理設定和人類編輯量改變時,相同的模型可以產生具有不同模式的文本。
| 因素 | 對分數穩定性的可能影響 | 負責任的解釋 |
|---|---|---|
| 文本長度 | 非常短的段落提供的訊號較少 | 避免從幾句話中得出強烈結論 |
| 類型 | 技術、法律、學術和模板化散文可能自然地統一 | 將結果與符合該類型的人類寫作進行比較 |
| 提示限制 | 嚴格的格式或語氣指令可以使輸出更規律 | 將分數視為該輸出的特定結果,而非整個模型 |
| Sol、Terra 或 Luna | 模型層級可能會改變結構和措辭 | 不要假設一個結果代表整個系列 |
| 人類編輯 | 修訂可以引入人類選擇和混合模式 | 當其過程是混合時,將文件描述為混合 |
| 翻譯 | 翻譯系統可以標準化句子模式 | 審查原始語言文本和翻譯歷史 |
| 引文和參考資料 | 嵌入的源語言可能會影響局部亮點 | 在解釋段落之前,將引用的材料分開 |
| 偵測器閾值 | 更敏感的設定會捕捉更多 AI,並可能增加誤報 | 記錄所選模式和閾值 |
| 偵測器更新 | 模型和偵測器會隨時間變化 | 標記掃描日期,避免將其視為永久性 |
文本長度和上下文
偵測器需要足夠的語言來評估可預測性、變異性和結構規律性等模式。一封 40 字的電子郵件和一篇 1,200 字的文章提供的證據量不同。
因此,應格外謹慎對待簡短的結果。將不相關的短段落組合以達到最低字數,也可能扭曲上下文並產生一個無法很好地描述任何一個段落的分數。
人類編輯和混合作者身份
編輯並非將 AI 寫作轉換為人類寫作的二元開關。它創造了一個參與的連續體,從輕微的校對到基於原創研究和判斷的完全重建。
混合文件可能包含具有不同歷史的部分。句子層級的亮點比一個總體百分比更能提供資訊,因為它們有助於審閱者詢問特定段落中發生了什麼。
類型和專業風格
有些人類寫作是刻意標準化的。政策語言、實驗室方法、支援文件、法律條款和公司模板可能會重複慣用短語並保持一致的句子模式。
這可能類似於與模型輸出相關的規律性。審閱者應考慮被標記的特徵是源於作者身份、類型慣例、機構模板還是多種因素的組合。
如何使用 Lynote 檢查 OpenAI 撰寫的文本
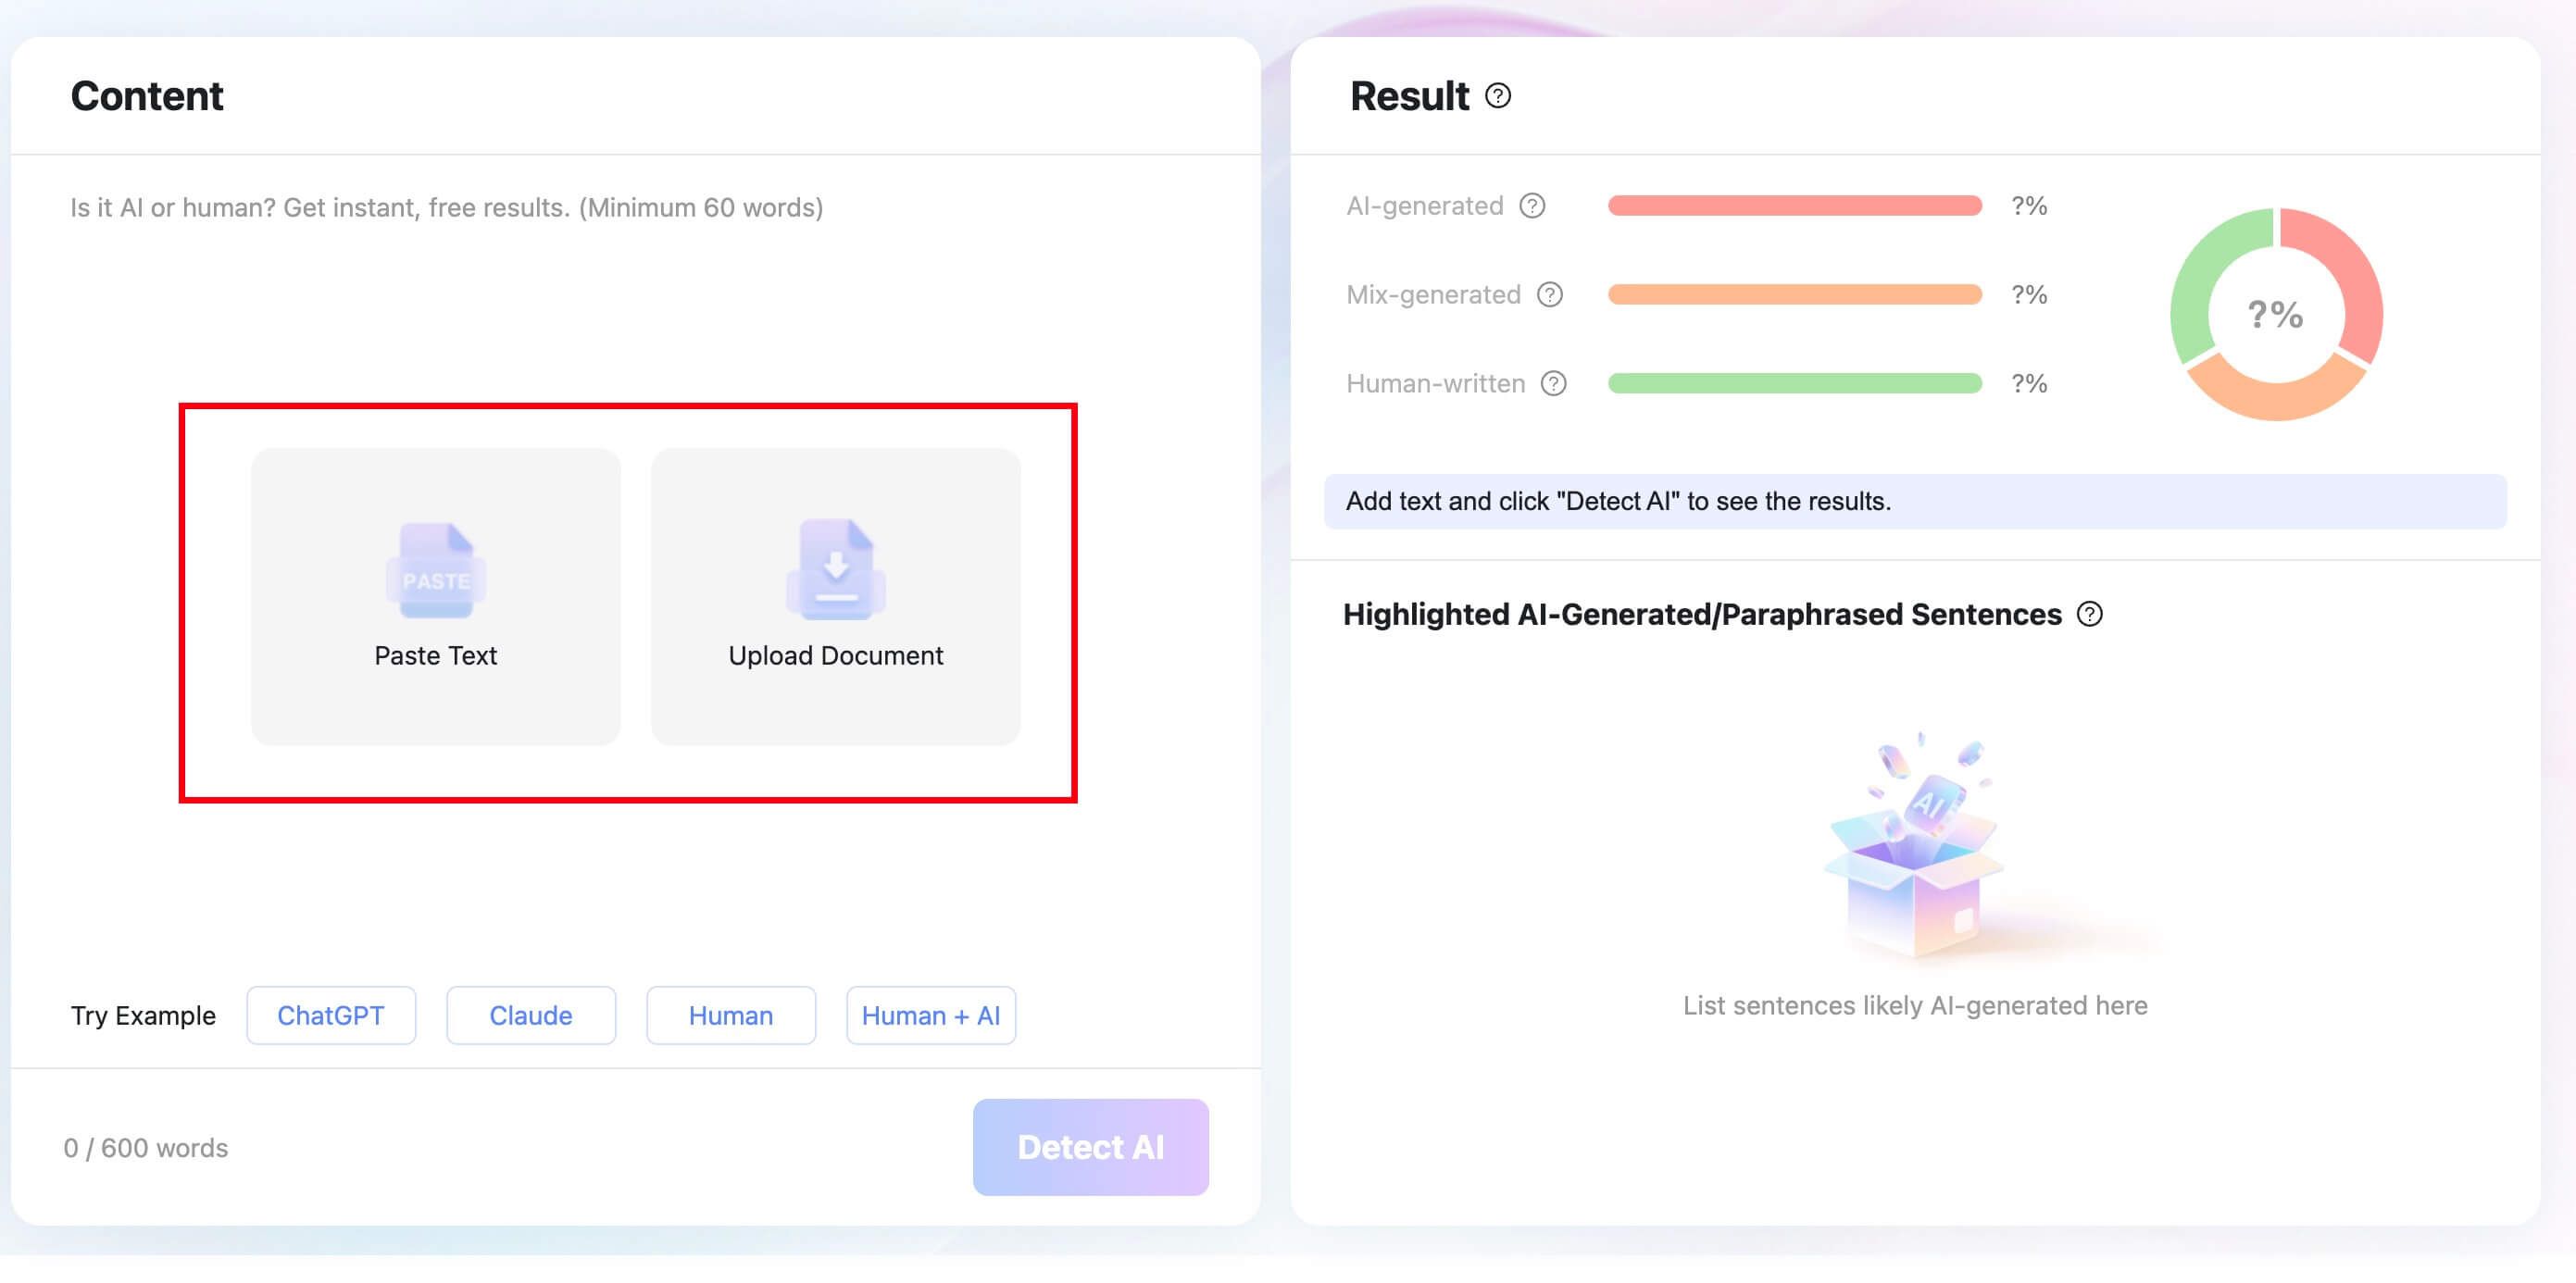
Lynote 的 OpenAI 內容偵測器 可以在您需要審查可能包含 ChatGPT 或 GPT-5.6 輔助的文本時,提供初步訊號。它會報告 AI 生成、混合和人類撰寫的百分比,並標示出值得仔細檢查的句子。
- 將段落貼到 Lynote 或上傳支援的文件。
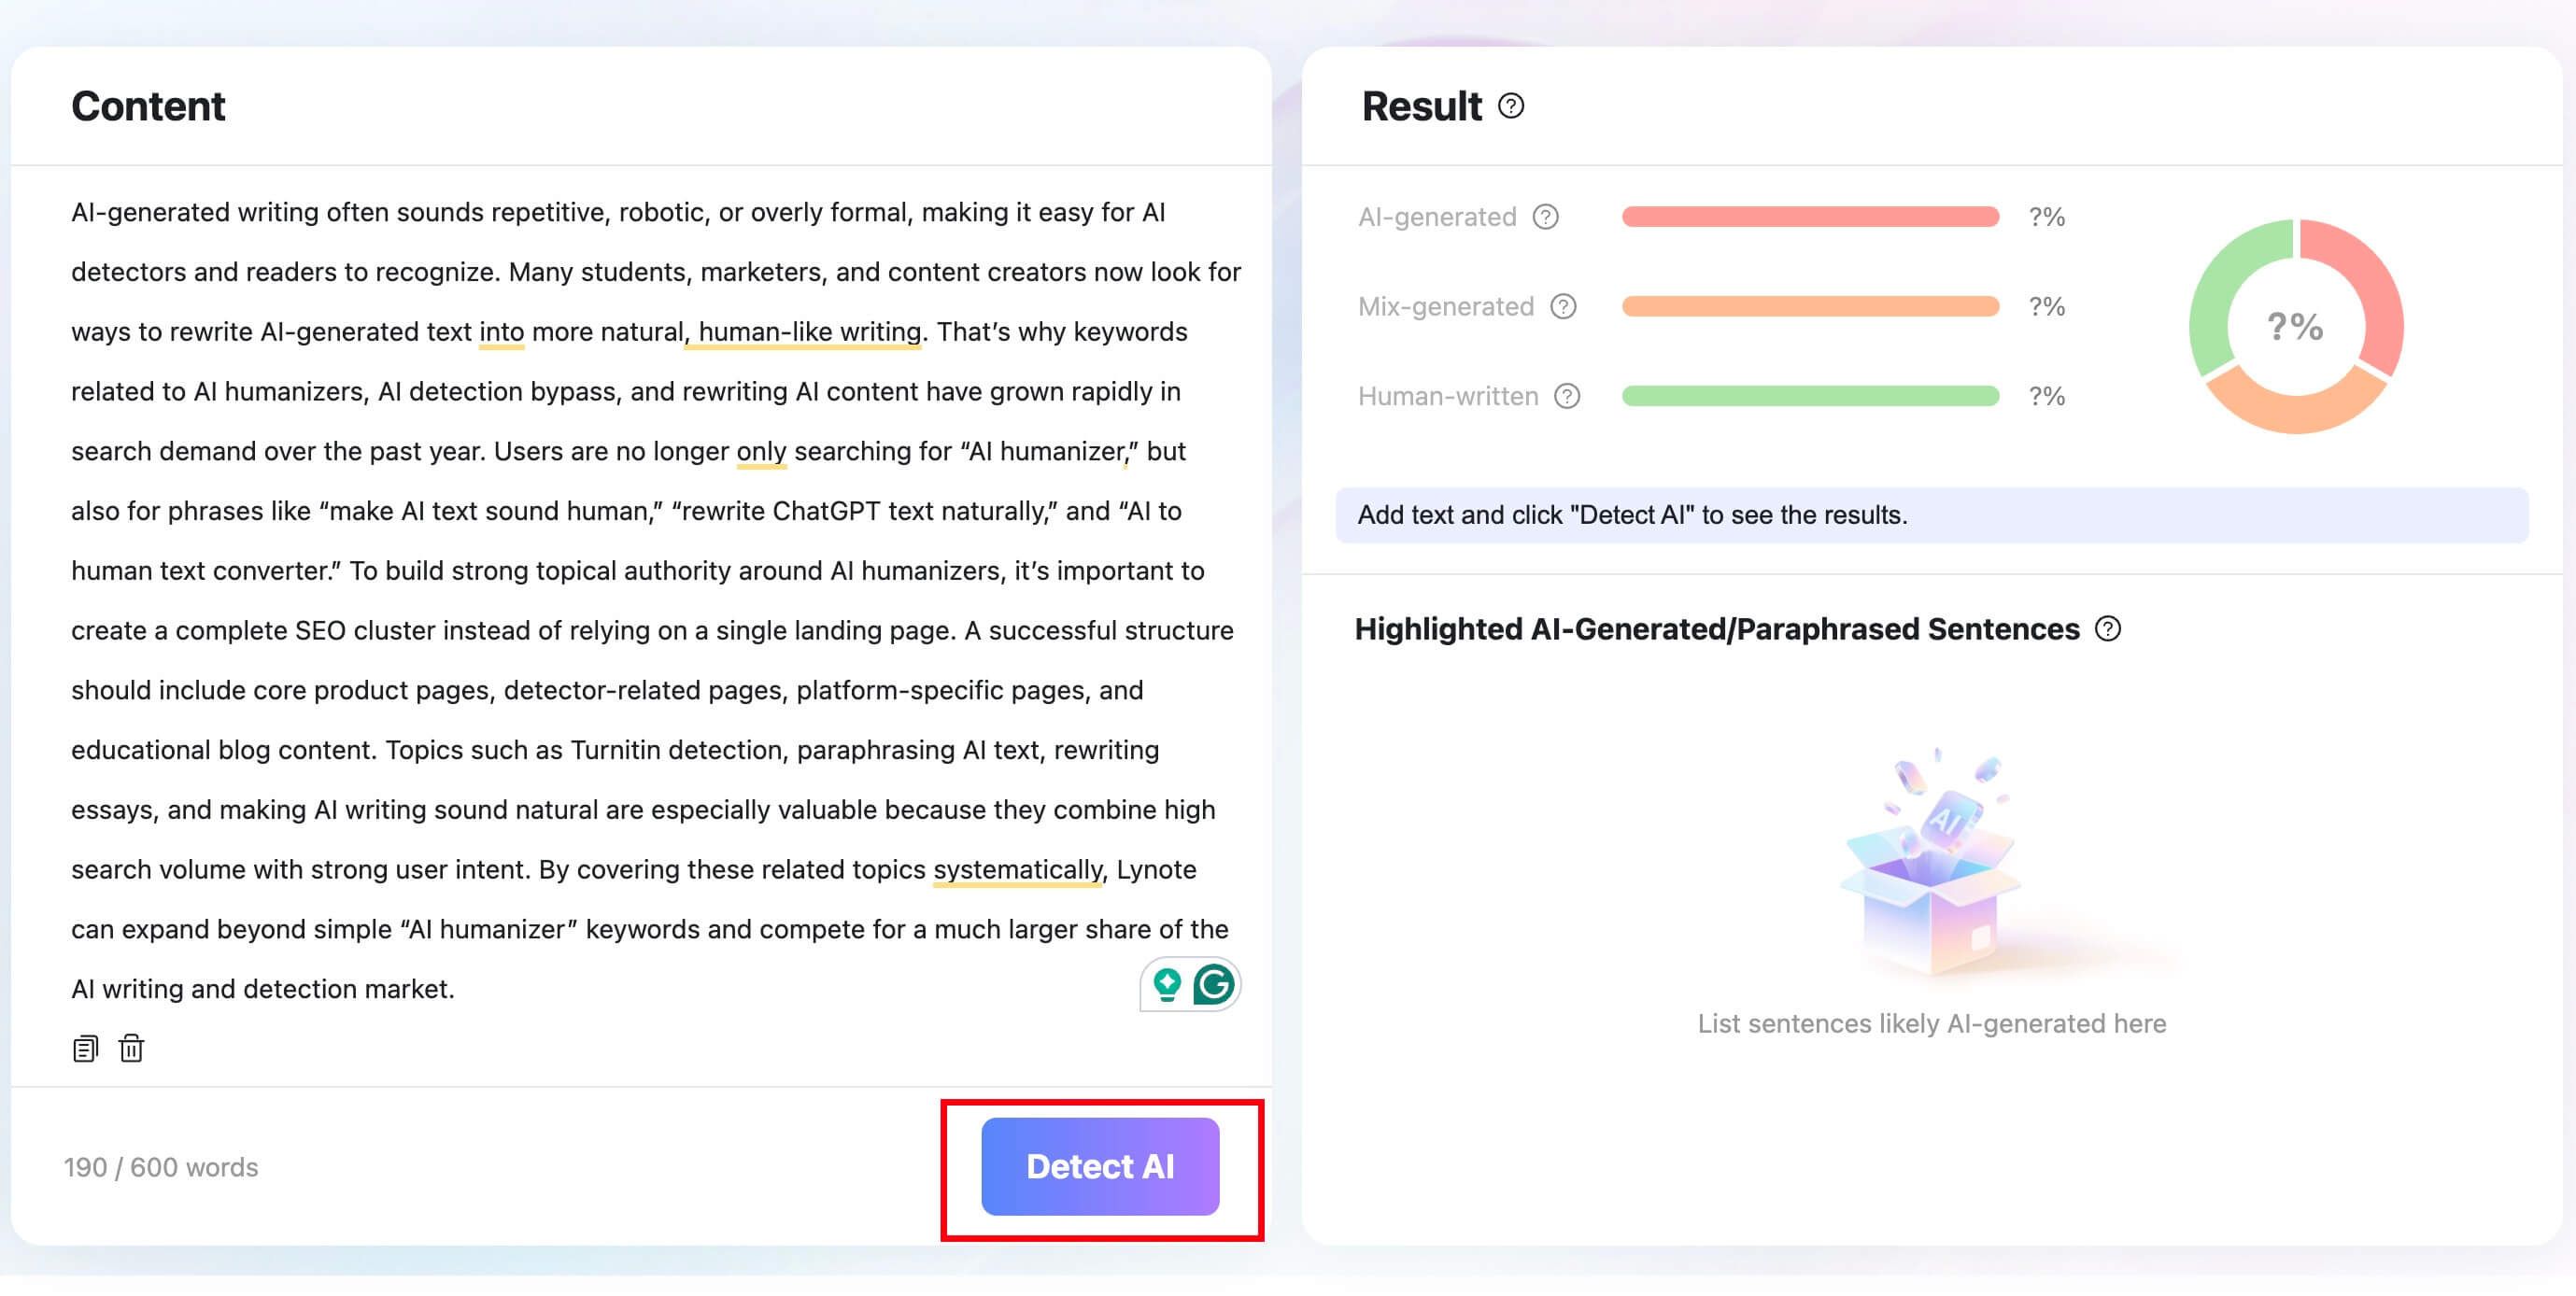
- 點擊 偵測 AI 以分析文本。
- 審查 AI、混合和人類分佈。
- 檢查句子層級的亮點,而不是僅依賴總體分數。
- 將標示的段落與草稿、筆記、引文和版本歷史進行比較。
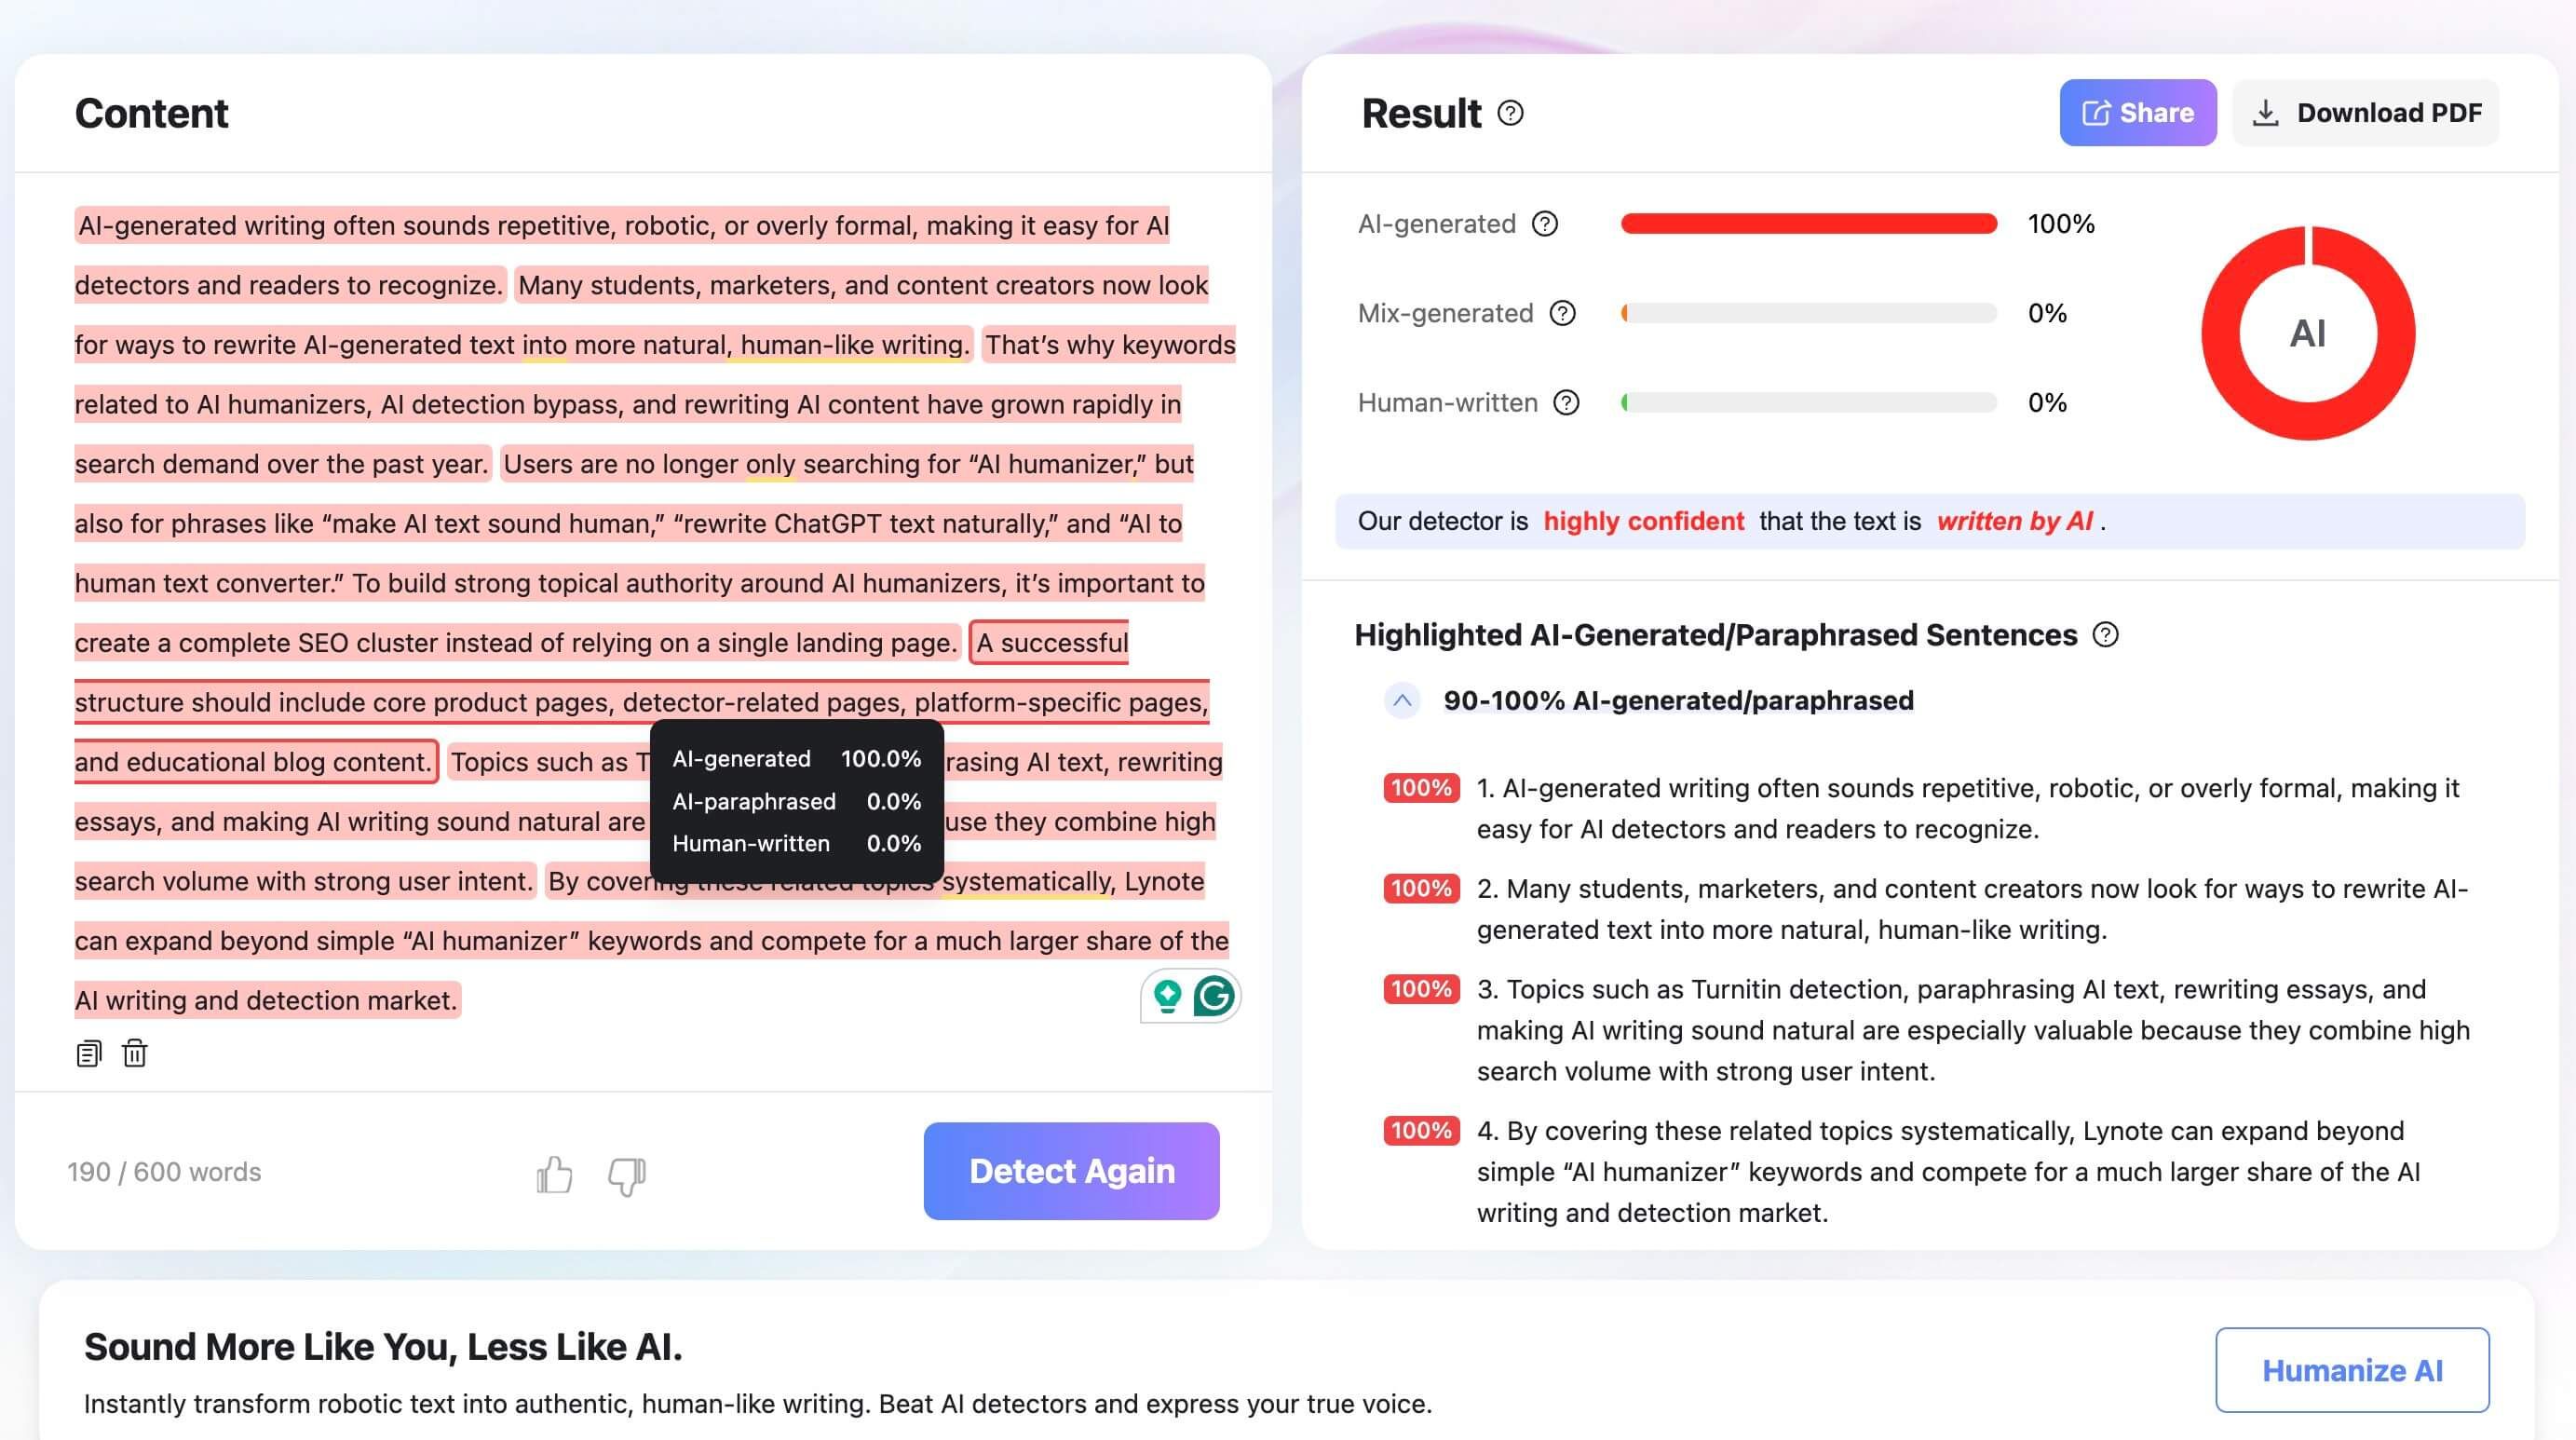
最後一步最為重要。Lynote 可以幫助定位供審查的模式,但其結果不應被視為 GPT-5.6 撰寫該文件的證據。
如果文件包含合法的 AI 輔助,請準確描述該過程。一份始於 GPT-5.6 但經過大量研究、檢查和由人工重寫的草稿,應與未經審查的模型回應區分開來評估,即使兩者都觸發了偵測器。

學生和作家應如何解讀 GPT-5.6 標記
標記的意義取決於正在做出的決定。出版商檢查來稿的責任與調查可能學術不端行為的教師不同。
對於學生
保留您寫作過程的證據:大綱、來源筆記、文件歷史、草稿、引文和回饋。如果機構允許有限的 AI 支援,請保留相關說明並根據適用政策披露您的使用情況。
當人類作品被錯誤標記時,過程證據通常比重複使用額外偵測器掃描相同段落更具說服力。第二個百分比並不能重現文件是如何撰寫的。
對於作家和出版商
AI 分數並非品質分數。GPT-5.6 文本可能事實薄弱或有用,而人類文本可能不準確、衍生或支持不足。
編輯審查應檢視事實來源、原創性、引文、語氣、受眾價值和問責制。核心問題不僅僅是模型是否貢獻了文字,而是負責任的人是否驗證並擁有最終作品。
對於教育工作者和審閱者
將偵測作為分類訊號,而非自動判決。審查作業設計、允許的 AI 政策、版本歷史、來源、寫作過程以及學生解釋作品的能力。
單一偵測器結果不應決定成績或紀律處分。後果越嚴重,獨立證據和人工審查就越重要。
比單一 AI 分數更好的證據清單
當 AI 偵測被納入更廣泛的證據流程中時,它會變得更有用。每種證據類型都回答不同的問題,不應將其延伸超出其所能顯示的範圍。
| 證據 | 能顯示什麼 | 單獨無法證明什麼 |
|---|---|---|
| AI 偵測器結果 | 文本包含與 AI 輸出相關的模式 | 是哪個模型生成的,或誰使用了該模型 |
| 句子亮點 | 哪些段落對分類影響最大 | 每個句子的歷史 |
| 版本歷史 | 文件隨時間的變化 | 是否所有編輯都是在沒有 AI 的情況下完成的 |
| 筆記和大綱 | 規劃、來源選擇和想法發展 | 每個最終短語的確切作者身份 |
| 引文和來源檢查 | 主張是否可追溯並得到負責任的支持 | 散文是否由 AI 生成 |
| 平台或 API 日誌 | 模型被訪問或產生了記錄的輸出 | 該輸出是否在文件中保持不變 |
| 作者討論 | 對推理、證據和選擇的理解 | 完整的技術來源 |
| 人工審查 | 對所有可用證據的上下文判斷 | 在每個案例中都絕對確定 |
公平的審查會詢問證據是否一致。如果偵測器標記與廣泛的草稿歷史、原始筆記、已驗證的來源和可信的解釋相衝突,則應調查該衝突,而不是自動偏向軟體解決。
反之亦然。如果未經編輯的模型回應被呈現為獨立的人類作品,且偵測器結果與缺失的草稿、偽造的引文以及無法解釋論點的情況一致,則該分數可能會有助於形成更全面的證據圖。
關於 GPT-5.6 偵測的常見問題
Turnitin 能偵測 GPT-5.6 嗎?
如果文本包含其當前模型識別的模式,Turnitin 可能會將 GPT-5.6 輸出歸類為 AI 生成。然而,來自其他偵測器的公開 GPT-5.6 特定結果不能被視為 Turnitin 的準確性,且 Turnitin 的輸出不應被用作作者身份的唯一證明。
GPTZero 能偵測 GPT-5.6 嗎?
GPTZero 旨在偵測 AI 生成的寫作,並可能標記 GPT-5.6 內容。其性能可能因文本長度、類型、編輯和模型更新而異,因此分數應被解釋為一個訊號,而非確切的 GPT-5.6 歸屬。
GPT-5.6 Sol 比 Terra 或 Luna 更容易偵測嗎?
目前的供應商研究並未建立一致且有意義的排名。Originality.ai 報告的數據因偵測器模式而略有不同,而 Pangram 報告所有三個層級的完全 AI 分類率均超過 99%。
編輯過的 GPT-5.6 文本仍可被偵測嗎?
是的。編輯並不能保證被歸類為人類寫作,特別是當大部分原始結構和措辭保留下來時。大量的人類貢獻也可能產生混合訊號,這使得文件歷史和上下文審查變得重要。
人類寫作會被錯誤標記為 GPT-5.6 嗎?
人類寫作可能會收到錯誤的 AI 分類,特別是當它簡短、公式化、高度標準化、經過翻譯,或以偵測器訓練數據中代表性不足的風格撰寫時。偵測器通常也無法將誤報明確標記為「GPT-5.6」;它報告的是與 AI 相關的分類。
最高 AI 分數能證明 GPT-5.6 撰寫了該文本嗎?
不能。偵測器顯示的最高分數是其自身評分系統下的置信度或分類輸出。它不能證明確切的模型來源、識別用戶,也不能取代佐證證據。
GPT-5.6 包含隱形文本浮水印嗎?
公開的 GPT-5.6 發布資訊並未表明普通文本輸出包含消費者偵測器可普遍讀取的浮水印。大多數目前的偵測工具分析的是語言和統計模式,而非查詢官方的 OpenAI 來源記錄。
GPT-5.6 在更新後會變得更難偵測嗎?
隨著模型行為和偵測器訓練的變化,對於特定的偵測器來說,它可能會變得更容易或更難偵測。2026 年 7 月的結果應標註日期,不應假設其描述了未來所有 GPT-5.6 的修訂或偵測器版本。
最終判決
GPT-5.6 在實際意義上是可偵測的,因為目前的商業偵測器通常能識別來自 Sol、Terra 和 Luna 的純粹輸出。早期供應商研究報告顯示,在數千個生成樣本中取得了強勁結果,因此最新的 OpenAI 系列並非僅僅因為偵測器在其普遍發布前就已訓練而自動隱形。
仍不確定的是對一份真實文件的解讀。高分不能獨立證明 GPT-5.6 生成了該文本、區分 Sol 與 Terra 或 Luna、識別用戶,或衡量人類作者的貢獻量。
使用偵測來識別值得審查的段落。對於重要的決策,將該訊號與版本歷史、筆記、引文、政策背景、可用的平台證據以及知情的人類判斷結合起來。