

Claude 可被偵測到嗎? 當最終文本看起來像是機器生成時,由 Claude 生成或 Claude 輔助的寫作可能會被 AI 偵測器標記,但大多數偵測器分數無法證明 Claude 是所使用的確切模型。可偵測性關乎訊號,而非完整的作者記錄。
這很重要,因為「可偵測」可以有多種不同的含義。老師注意到風格轉變、偵測器給出高 AI 分數,以及平台擁有帳戶日誌,這些都是不同種類的證據。
快速解答:Claude 可被偵測到嗎?
是的,當 Claude 文本具有 AI 偵測器與生成寫作相關聯的模式時,它就可以被偵測到。這可能包括高度精煉的結構、平衡的措辭、通用的過渡語句,以及沒有顯示太多特定來源推理的主張。
但偵測結果仍然是機率性的。它可能暗示某段文字看起來像 AI 生成,但通常無法確定地說這是 Anthropic 的 Claude 所寫。
人們所說的「可偵測」是什麼意思?
「可偵測」這個詞很容易被誤用。在 AI 寫作討論中,它可以指模式偵測、模型歸因、浮水印、教師審查或獨立的平台證據。
| 偵測途徑 | 檢查內容 | 可能暗示什麼 | 無法證明什麼 |
|---|---|---|---|
| AI 偵測器 | 文本中的寫作模式 | 該段文字可能是 AI 生成的 | 其背後的確切模型 |
| 教師審查 | 風格、草稿、來源和作業符合度 | 該過程可能需要解釋 | 單憑其本身無法提供完整的工具使用歷史 |
| 模型歸因 | 某個模型是否可能產生了文本 | 可能的模型相似性 | 沒有強有力證據的確定性 |
| 浮水印 | 隱藏或統計標記 | 文本可能來自帶有標記的系統 | 並非所有 Claude 輸出都帶有標記 |
| 平台日誌 | 帳戶或文件活動 | 可能使用了某種工具 | 最終寫作過程的樣貌 |
對於大多數學生和作家來說,實際問題更為狹窄:這段文字是否會被標記或質疑?答案是肯定的,特別是如果最終草稿讀起來像通用的 AI 輸出。
AI 偵測器能偵測到 Claude 文本嗎?
AI 偵測器不需要 Claude 標籤就能標記類似 Claude 的寫作。它們尋找可預測性、句子節奏、低特異性以及重複的段落結構等模式。
Claude 可以產生流暢且嚴謹的散文,這對於編輯和腦力激盪很有用。但如果提示要求一篇廣泛的論文,結果也可能聽起來很精煉,而偵測器會將這種精煉與 AI 寫作相關聯。
文本的長度也很重要。非常短的段落較難判斷,而較長的通用草稿則為偵測器提供了更多分析材料。
提示與模型本身一樣重要。像「寫一篇關於...的平衡論文」這樣的提示通常會產生可預測的論文結構:廣泛的開頭、整潔的主題句、權重均勻的論點,以及重申顯而易見結論的結尾。這種結構比「Claude」這個詞本身更容易被偵測到。
相比之下,從真實筆記、狹窄問題和具體證據開始的草稿,較不依賴模型的預設寫作模式。它可能仍然涉及 AI 輔助,但最終文本為審閱者提供了更多人類背景來評估。
偵測器能證明文本來自 Claude 嗎?
通常不能。高 AI 分數不等同於已確認的 Claude 指紋。
Claude、ChatGPT、Gemini 和其他語言模型可以產生相似的學術結構。它們都可以撰寫廣泛的引言、平衡的優缺點段落,以及缺乏作者自身證據的整潔結論。
這種重疊是精確歸因具有風險的原因。一篇負責任的文章應該說「類似 AI 生成」或「可能由 AI 生成」,而不是聲稱 Claude 撰寫了該段文字,除非有文件化的特定工具證據。
Claude 比 ChatGPT 或 Gemini 更難被偵測到嗎?
沒有普遍的答案。可偵測性取決於提示、主題、偵測器、段落長度以及作者修改的程度。
一篇通用的 Claude 論文可能很容易被標記。一個簡短、經過大量修改並包含真實課程證據的段落可能更難分類。對於 ChatGPT、Gemini 和其他模型來說也是如此。
更好的比較不是「哪個模型是隱形的?」,而是「最終作品是否展現了原創推理、來源參與以及作者可以解釋的過程?」
教師能在沒有 AI 偵測器的情況下偵測到 Claude 嗎?
教師不需要軟體就能注意到草稿值得仔細審查。語氣突然轉變、語言異常精煉、引用薄弱或與課堂討論不符,都可能引發疑問。
草稿歷史可能比偵測器分數更重要。如果學生能展示筆記、大綱、來源註釋和早期版本,寫作過程就更容易理解。
教師也可能要求學生解釋論點。如果學生無法解釋主張、來源或結構,那麼問題就比單一偵測器能否指出 Claude 更大。
負責任的 Claude 工作流程,降低審查風險
如果允許使用 Claude,請將其用於有限的輔助:腦力激盪問題、測試大綱、徵求回饋,或找出段落不清楚的地方。然後根據自己的筆記和來源撰寫最終主張。
不要讓 Claude 添加你無法驗證的引用、範例或分析。如果該工具改變了你的論點,請將其視為需要檢查的新材料,而不是可以直接提交的寫作。
保留一份簡單的過程記錄。保存你的大綱、研究筆記、草稿,以及課程或工作場所政策要求的任何披露。
| Claude 用途 | 典型風險 | 為何可能被審查 | 負責任的替代方案 |
|---|---|---|---|
| 腦力激盪問題 | 較低 | 最終文本可能仍是你的 | 保留筆記並自行撰寫答案 |
| 編輯以提高清晰度 | 中等 | 語氣可能變得過於精煉 | 將編輯與你的原始含義進行比較 |
| 生成完整段落 | 較高 | 作者身份和證據變得不明確 | 從來源和課堂筆記重新建構 |
| 創建引用或範例 | 較高 | 來源可能錯誤或無支持 | 手動驗證每個主張 |
| 重寫以使其聽起來像人類 | 較高 | 目標可能與政策衝突 | 遵循披露並誠實修改 |
對於職場寫作,同樣的邏輯以不同的方式適用。如果組織允許且事實已驗證,一份經 Claude 精煉的備忘錄可能沒問題。但如果備忘錄捏造細節、過度自信或刪除必要的警告,那麼風險是專業層面而非學術層面。
使用 Lynote AI 偵測器檢查 Claude 輔助文本
在審查 Claude 輔助寫作時,你可以使用 Lynote AI 偵測器 作為第二個訊號。目標是找出聽起來過於通用或像機器生成的段落,而不是證明是否使用了 Claude。
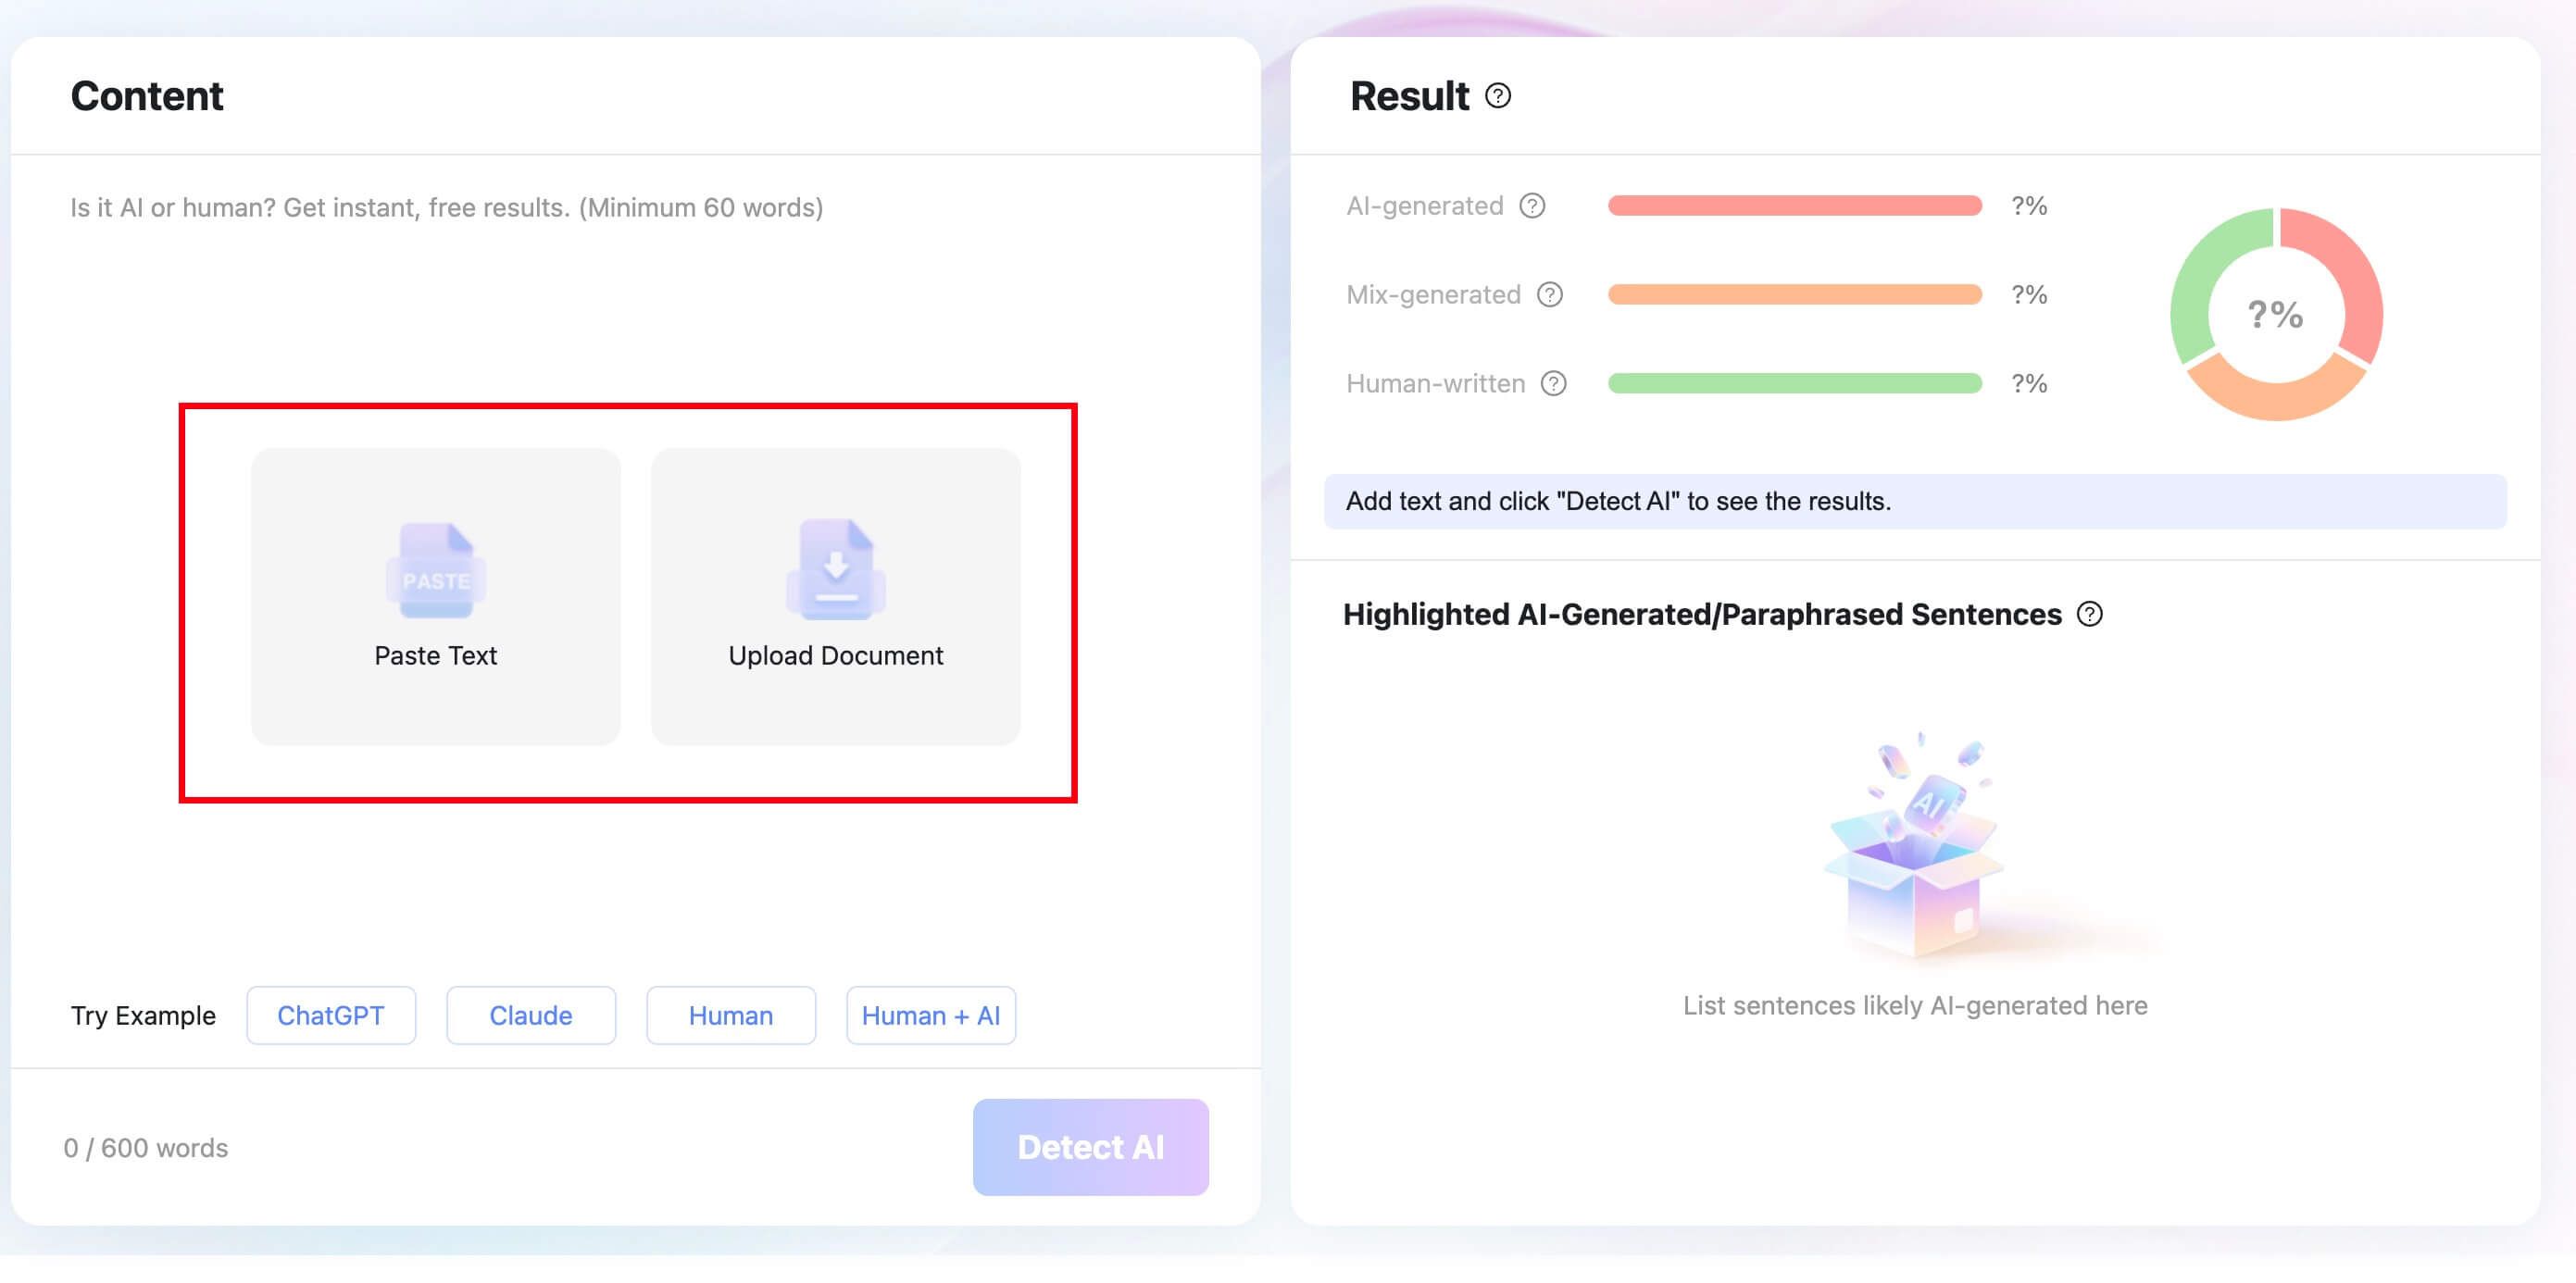
步驟 1. 貼上文本或上傳文件
將你經 Claude 輔助的段落貼入 Lynote AI 偵測器,或上傳支援的 Word、PDF 或 TXT 文件。盡可能檢查最終草稿而非片段。
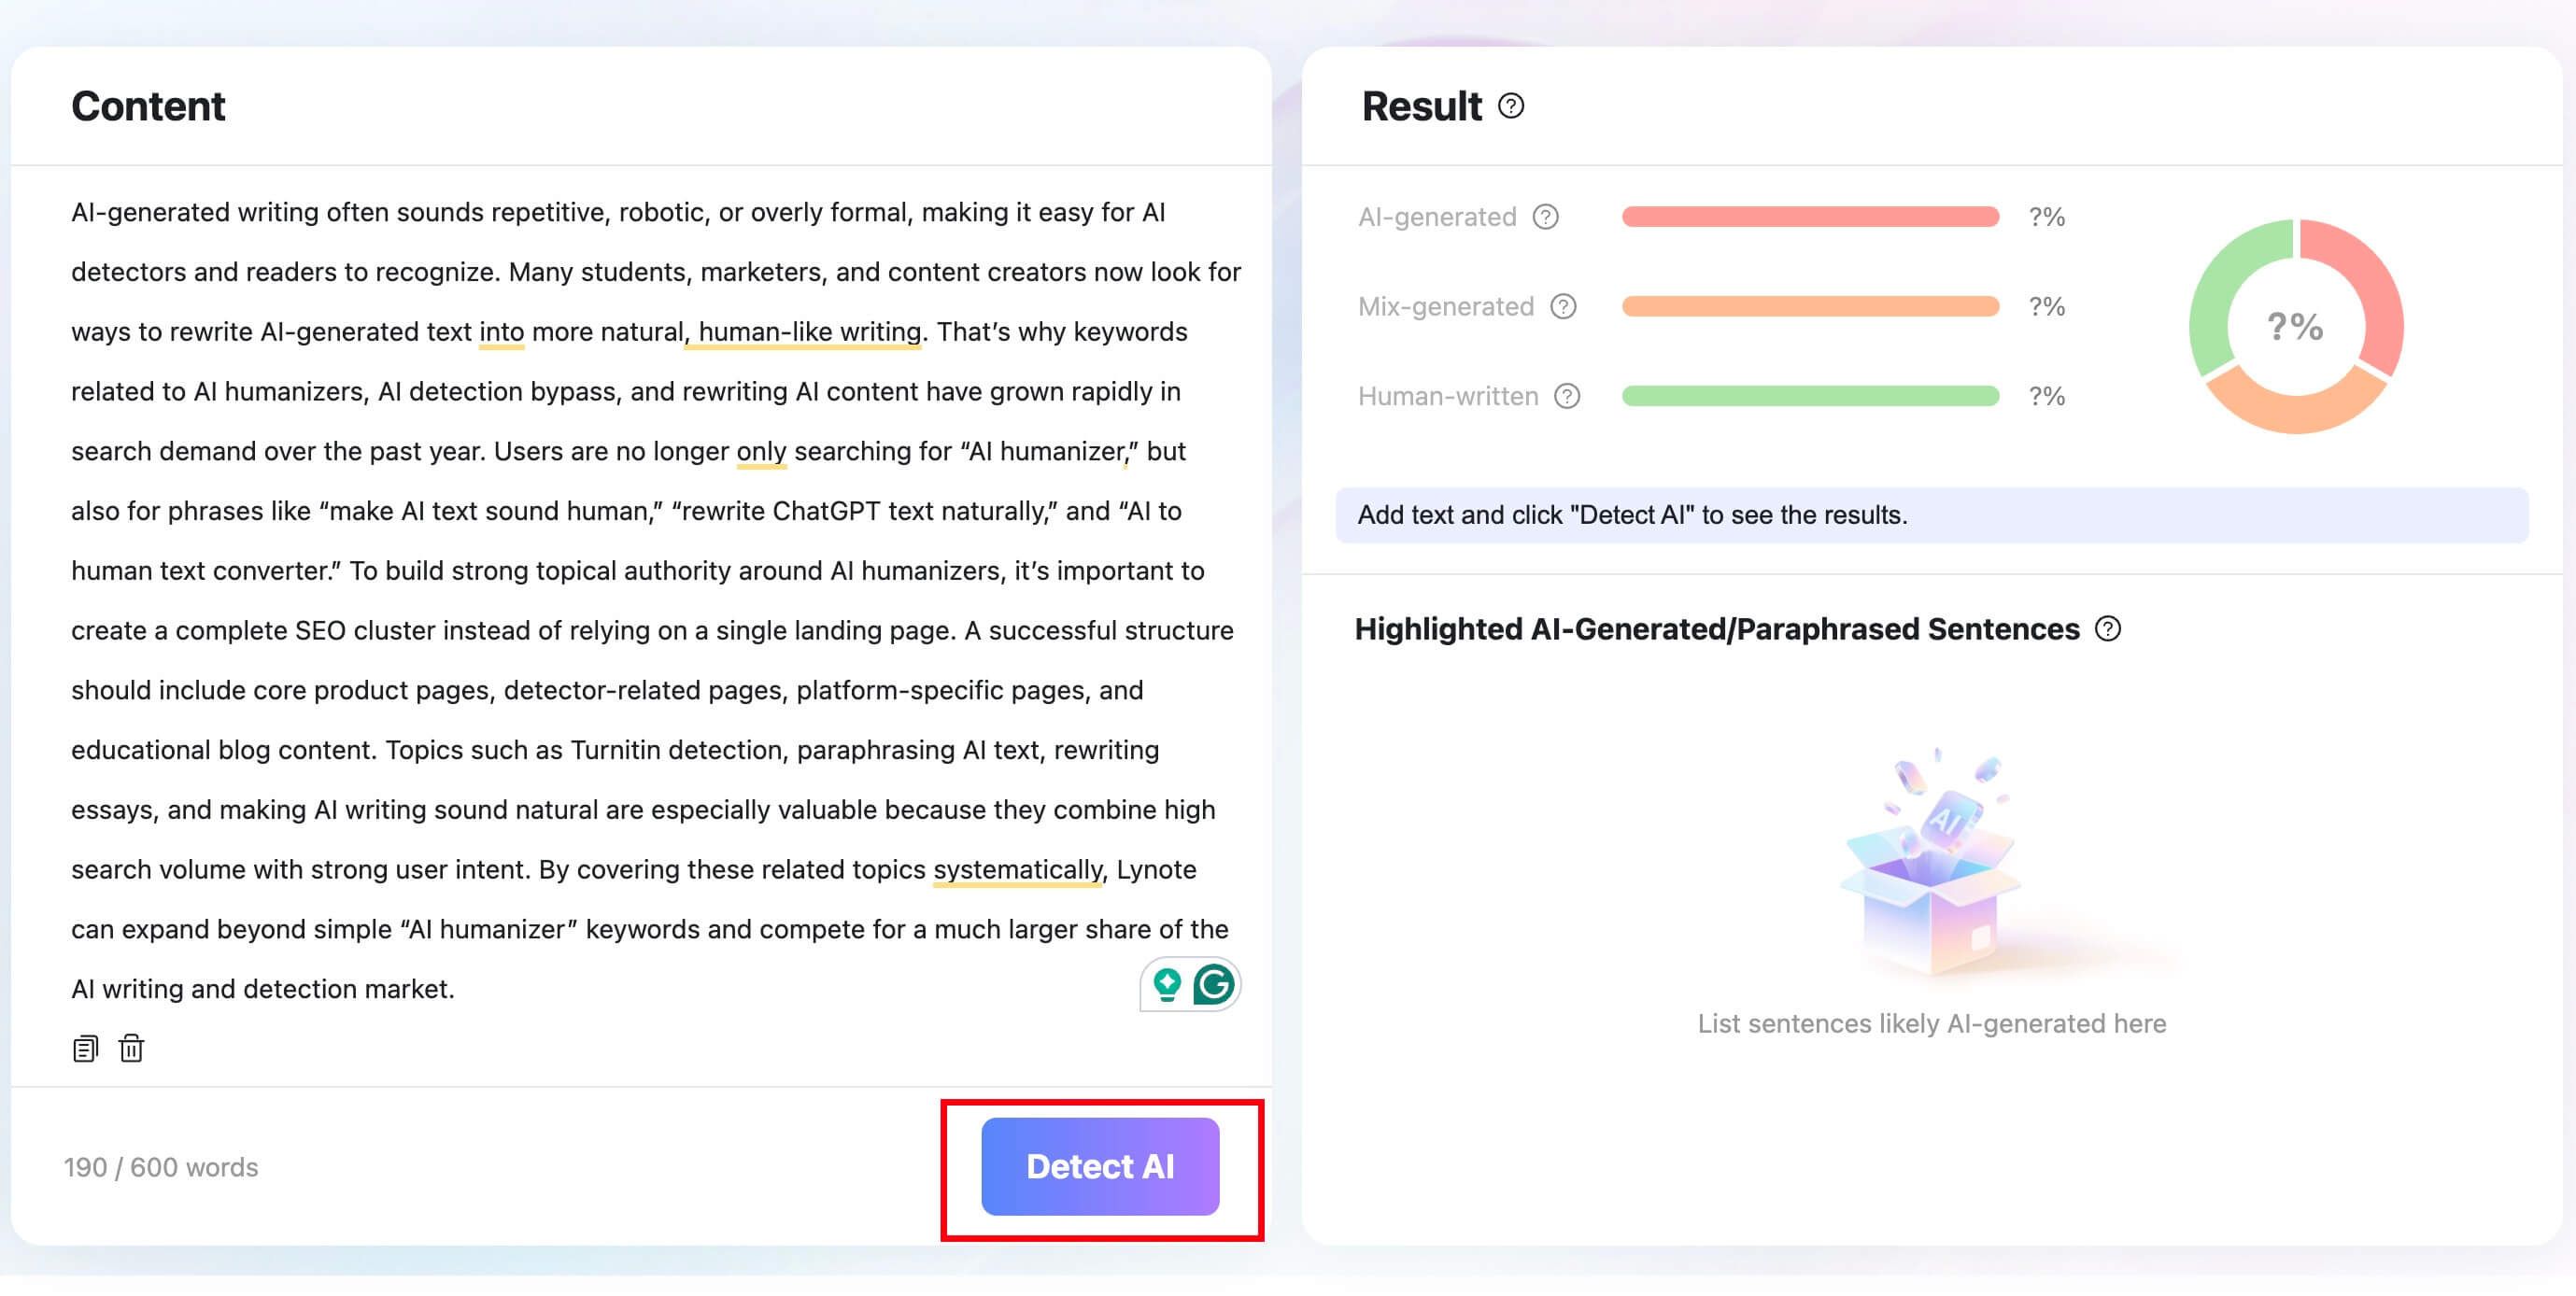
步驟 2. 點擊偵測 AI
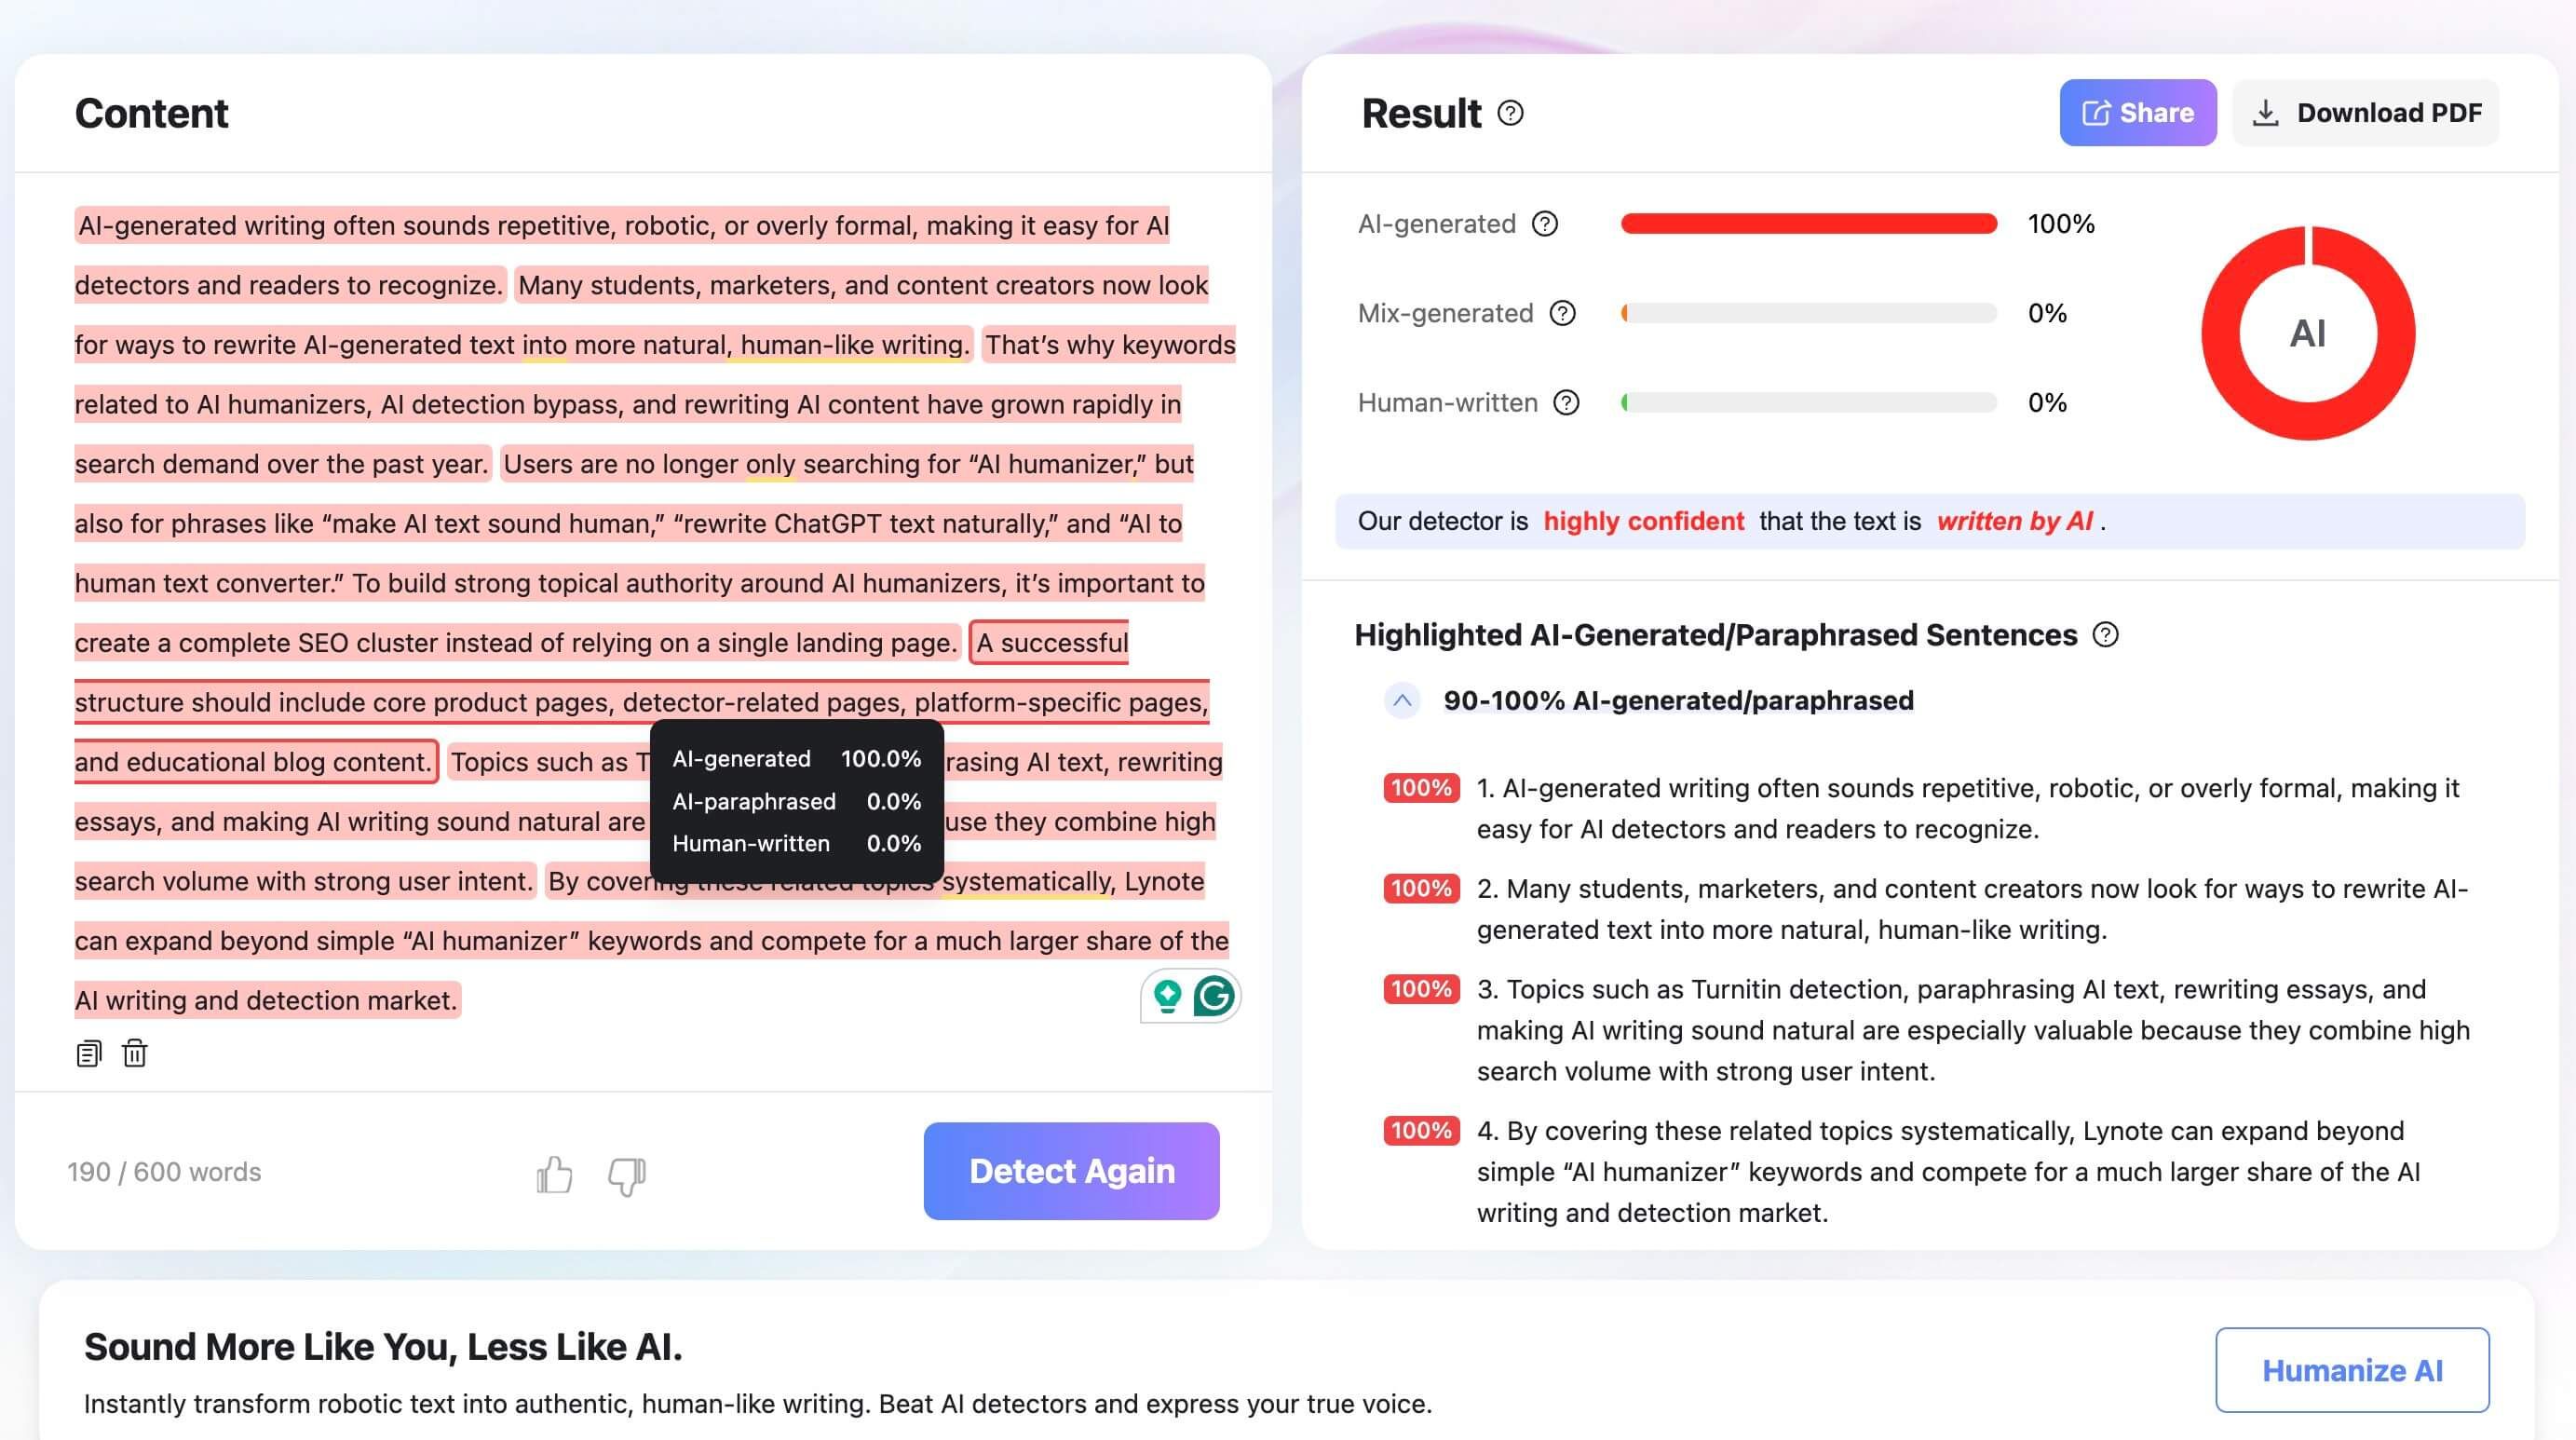
點擊「偵測 AI」以掃描寫作。Lynote 會顯示 AI 生成、混合和人類撰寫的百分比,作為審查輔助。
步驟 3. 審查標示的句子
查看標示的句子,並思考它們需要什麼:更強的證據、更精確的措辭、與你的來源更清晰的連結,或更自然的節奏。然後根據你自己的理解進行修改。

Claude 的可偵測性取決於提示,而不僅僅是模型
許多人問 Claude 是否比 ChatGPT 更容易或更難被偵測到。這個問題可以理解,但它忽略了最大的變數:使用者要求 Claude 做什麼。
如果提示要求 Claude 從一個簡單的指令中產生完整的回答,模型就必須填補結構、範例、過渡語句和語氣。結果可能流暢,但也可能過於廣泛和自成一體,感覺與學生的真實過程脫節。
如果提示要求 Claude 批評大綱、識別不清楚的句子,或建議閱讀來源時要問的問題,那麼最終提交的寫作可能較少依賴生成的散文。這並不能自動使使用被允許,但它改變了偵測器或教師正在評估的內容。
這就是為什麼「Claude 寫的」和「Claude 幫助我思考」是截然不同的情況。偵測器分數通常只看到最終文本。它不知道哪些部分來自腦力激盪、編輯、大綱或直接生成。
為何 Claude 寫作感覺像人類,卻仍可能被標記
Claude 經常產生平靜、自然、組織良好的散文。這可以讓寫作感覺比舊的 AI 輸出更像人類,但這並不能使文本免於被偵測。
一個原因是過度平衡。Claude 可能會呈現問題的兩面,仔細限定主張,並避免強烈且無支持的陳述。這種風格可能很有用,但在作業中,如果論文從未致力於對證據的特定解讀,它也可能感覺很通用。
另一個原因是無摩擦的組織。人類的草稿通常會顯示決策的痕跡:一個令人驚訝的例子、一個縮小主張範圍的句子、一個特定來源的警告,或一個反映作者與主題搏鬥的粗糙過渡。Claude 可以消除這種摩擦,使論文在推理實際完成之前就聽起來完整。
The結果是一個奇怪的問題。寫作可能清晰且令人愉悅,但它可能沒有充分展現學生的智力指紋。偵測器和教師都可以對這種缺失做出反應,即使他們無法證明其背後的確切模型。
Claude 在學校或工作草稿中的特定風險模式
Claude 常用於長篇推理、總結和重寫。當最終輸出取代了作者對來源的參與時,這些優勢可能變成風險。
| Claude 輔助模式 | 為何可能引發疑問 | 更好的 Claude 用法 | | --- | --- | --- | --- | | 根據廣泛提示撰寫完整論文 | 結構可能看起來通用且與課堂材料脫節 | 請求大綱回饋,然後根據筆記撰寫 | | 精煉但具體細節少的段落 | 文本可能聽起來流暢但無支持 | 添加只有你能解釋的證據 | | 對你幾乎未讀的來源進行流暢總結 | 論文可能未顯示真實的來源理解 | 使用 Claude 創建問題,而非最終主張 | | 整個草稿的語氣重寫 | 語氣可能與早期作品不一致 | 應用局部編輯並與你的原稿比較 | | AI 生成的引用或範例 | 無支持的材料可能成為誠信問題 | 手動驗證每個主張 |
對於職場寫作,同樣的邏輯以不同的方式適用。如果組織允許且事實已驗證,一份經 Claude 精煉的備忘錄可能沒問題。但如果備忘錄捏造細節、過度自信或刪除必要的警告,那麼風險是專業層面而非學術層面。
如何讓 Claude 輔助的作品更容易辯護
最好的保護不是試圖讓 Claude 隱形。而是讓最終作品基於一個你可以解釋的過程。
在向 Claude 尋求幫助之前,先從你自己的筆記開始。先寫出凌亂的版本:主張、證據、你不確定的問題,以及你的論點仍然感覺薄弱的地方。然後將 Claude 用於狹窄的任務,例如詢問哪些地方不清楚或段落需要更多支持。
之後,手動修改。從你的實際來源、課程、專案或經驗中添加細節。刪除聽起來正確但與你理解的證據無關的精煉句子。
如果需要披露,請遵循政策。如果不需要披露但你擔心,請保留一份私人過程日誌,顯示你的工作與 AI 輔助之間的界限。
不要過度解讀低 AI 分數
低偵測器分數並不能證明經 Claude 輔助的草稿符合政策。它只意味著一個偵測器沒有強烈地將最終文本歸類為 AI 生成。
這種區別很重要,因為學術和職場審查可能不僅僅涉及文本。教師可能會將論文與過去的寫作進行比較。經理可能會檢查分析是否與可用數據匹配。審閱者可能會詢問主張是如何發展的。
將低分數視為一個安慰訊號,而不是許可證。更重要的問題仍然是最終作品是否準確、被允許,並真正得到你自身理解的支持。
關於 Claude 可偵測性的常見問題
Turnitin 能偵測到 Claude 嗎?
如果類似 Claude 的寫作與 AI 生成的文本相似,Turnitin 可能會將其標記。這與證明 Claude 具體撰寫了該作業不同。
GPTZero 能偵測到 Claude 嗎?
當寫作具有類似 AI 的模式時,GPTZero 和類似的偵測器可能會標記 Claude 文本。結果仍應被視為估計,而非完整的作者判斷。
Claude 會為其寫作添加浮水印嗎?
不要假設普通的 Claude 文本包含公開、普遍可讀的浮水印。浮水印、偵測器分數和教師審查是不同的概念。
教師能在沒有軟體的情況下偵測到 Claude 嗎?
教師可能會注意到風格變化、薄弱的來源參與、缺少草稿,或學生無法解釋的主張。人工審查不等同於模型特定的證明,但它仍然可能引發疑問。
Claude 比 ChatGPT 更難被偵測到嗎?
沒有普遍的答案。可偵測性取決於提示、最終編輯、偵測器、作業,以及草稿中真實的特定來源推理量。
編輯過的 Claude 文本仍可能被標記嗎?
是的。編輯可以改變文本的表面,但通用結構或無支持的主張可能仍然存在。強有力的修改意味著重建論點,而不僅僅是潤飾措辭。
最終結論
Claude 寫作可以被偵測到,但偵測不等同於確切的證明。AI 偵測器估計文本是否看起來是生成的;它們通常無法證明 Claude 是指定的來源。
最安全的方法是遵守政策的使用、透明的過程記錄、清晰的引用,以及反映你自身理解的最終寫作。