

「JustDone AI 偵測器」可作為初步訊號,但單一分數並不能可靠證明文件的作者。其公開的準確度數據描述了不同的測試,而獨立檢查和我自己的即時樣本顯示,誤報率仍然可能很高。
這並不表示 JustDone AI 檢查器毫無用處。這意味著結果必須被解讀為對寫作模式的預測,然後與實際文件、其修訂歷史以及產生該文件的背景進行比較。
本評論將探討 JustDone 測量了什麼、其準確度聲明真正告訴我們什麼、偵測器最可能在哪裡失效,以及如何在不為了滿足機器而重寫真實作品的情況下,回應有爭議的分數。
快速評估:JustDone 是一個好的 AI 偵測器嗎?
JustDone 是一個方便的篩選工具,適用於較長的文章。其公開介面接受貼上文字或上傳文件,會返回一個百分比,並能標示句子以供仔細審查。
它的弱點不在於介面。問題在於,一個精確的百分比看起來比單一預測背後的證據更具決定性。
| 問題 | 我的評估 |
|---|---|
| JustDone 容易使用嗎? | 是的。貼上文字並開始掃描很簡單。 |
| 它對初步檢查有用嗎? | 是的,特別是當文字足夠長以包含有意義的模式時。 |
| 百分比是 AI 寫作的證明嗎? | 不是。該工具無法觀察文件是如何寫成的。 |
| 它會錯誤地標記人類寫作嗎? | 是的。我原始的人類樣本收到了 85% 的 AI 結果。 |
| 它本身適合用於不當行為的判斷嗎? | 不是。重要的判斷需要背景資訊和人工審查。 |
| 誰能獲得最大價值? | 將報告作為進一步檢查提示的作家和編輯。 |
我的總體評估是:有用的訊號,但證據不足。這個區別應該指導評論的每個部分。
JustDone AI 偵測器是什麼?
JustDone 是一個寫作平台,將其 AI 偵測器與更廣泛的寫作、研究、重寫、抄襲、引用和事實查核工具集合在一起。該偵測器可透過公共網路介面使用,而付費存取則以更廣泛的套件而非僅限偵測器的訂閱形式銷售。
目前的偵測器工作流程很簡單:
- 將文字貼到偵測器中,或上傳 PDF、Word 或 TXT 文件。
- 點擊「檢查 AI 內容」。
- 等待分析並審查 AI 內容百分比。
- 檢查完整報告中提供的任何句子級別回饋。
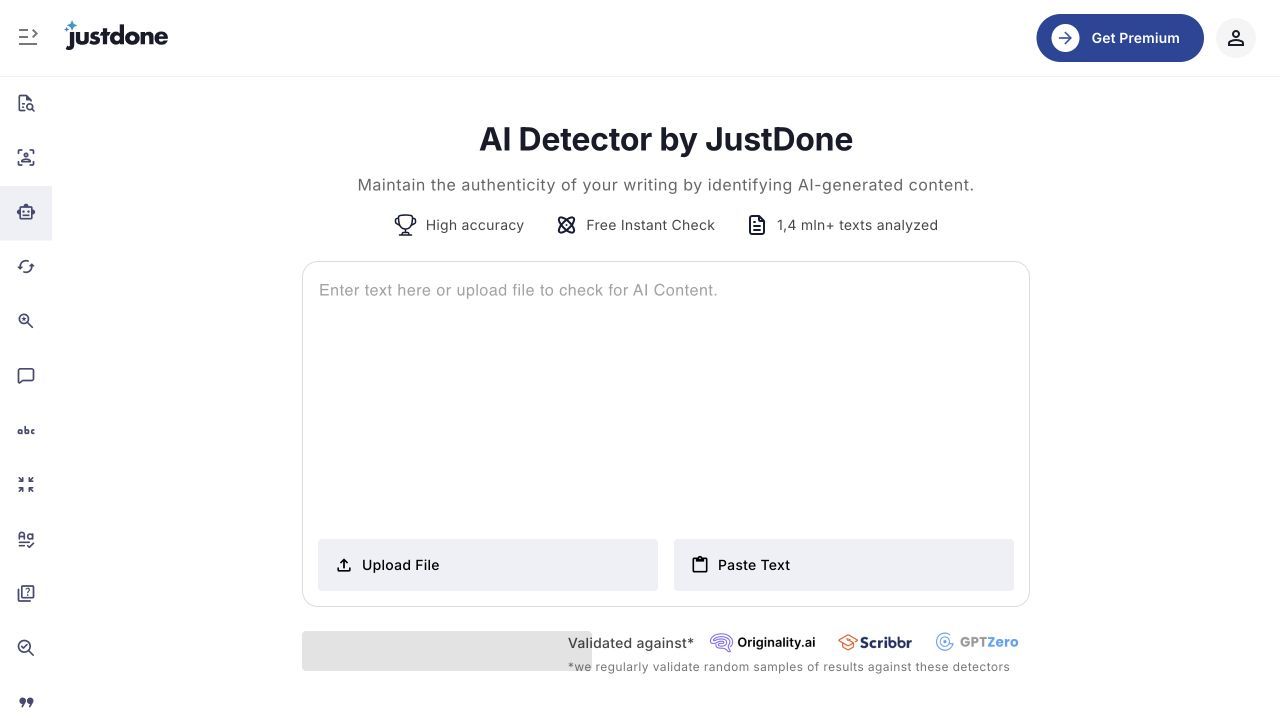
JustDone 目前宣稱一次掃描可檢查多達 15,000 字。這對於論文、報告和文章來說比專為短文字框設計的工具更實用。
輸出結果仍需仔細解讀。例如,「85% AI 內容」的結果並不表示系統觀察到 AI 生成了文件中 85% 的內容。這表示偵測器發現了其模型與 AI 生成寫作相關聯的模式,並將該分類轉換為百分比。
JustDone AI 檢查器聲稱其運作方式
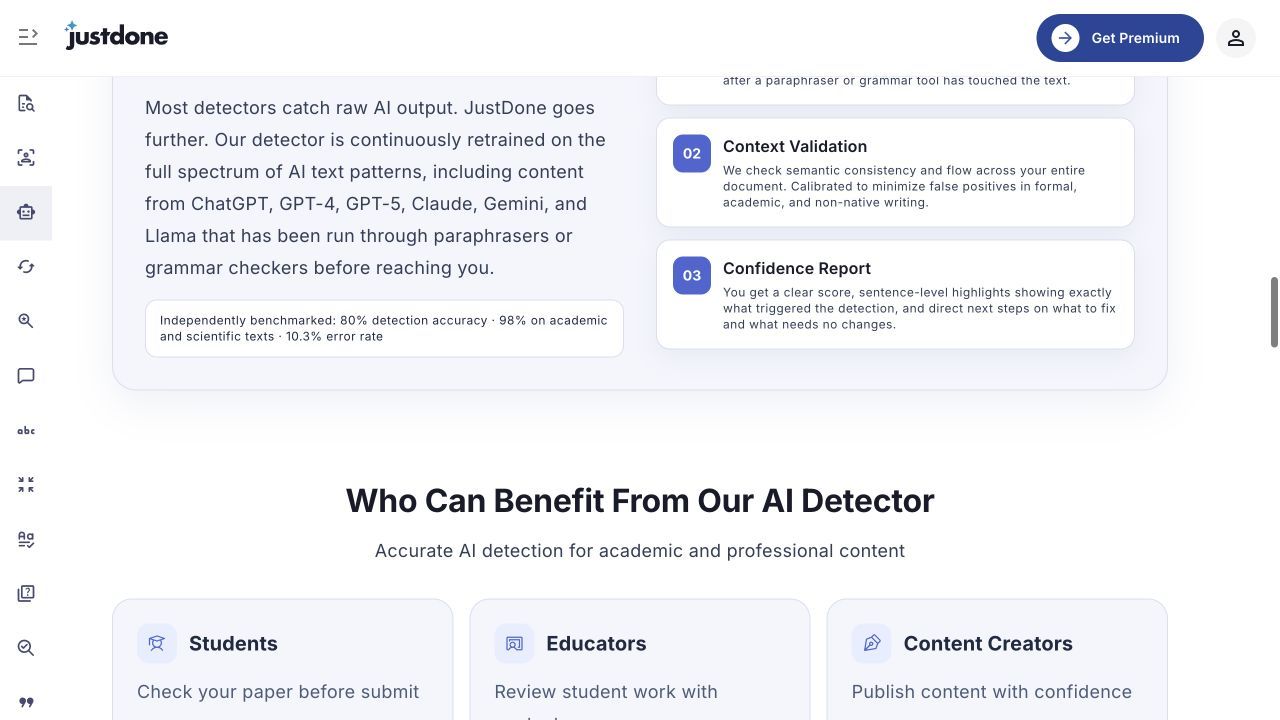
JustDone 描述了三個主要階段:訊號分析、上下文驗證和信心報告。該系統會尋找可預測的詞彙選擇、一致的句子節奏、結構重複、語義一致性以及文件中的流暢度。
這些特徵是 AI 寫作分類器的合理輸入。生成的文字通常偏好統計上可能出現的措辭、平衡的句子結構、有序的過渡以及重複的修辭模式。
然而,這些特徵沒有一個是 AI 獨有的。人類作者可能會因為任務正式、文體受限、作者使用第二語言,或者編輯將草稿潤飾成統一風格而產生規律的散文。
相反的問題也存在。AI 輸出可能是多樣的、零碎的、經過大量編輯的,或者與人類寫作混合。偵測器可能會因此錯過它,因為最終的段落不再類似於模型所依賴的模式。
這就是為什麼 AI 偵測與抄襲比對不同。抄襲檢查器有時可以指向匹配的來源。AI 偵測器通常無法指向生成器日誌或確定是誰按下了按鈕。
它評估的是相似性,而非來源。
JustDone 的準確度聲明解讀
JustDone 目前的產品和基準材料發布了幾個數字。它們乍看之下似乎相容,但它們不一定測量相同的結果。
| 公布數字 | 可能描述的內容 | 讀者仍需了解的內容 |
|---|---|---|
| 80% 偵測準確度 | 在一組純 AI 樣本上的表現 | 模型組合、樣本平衡、閾值和漏報數 |
| 學術和科學文本 98% | 特定領域的基準表現 | 是否包含人類和 AI 樣本以及它們的來源 |
| 10.3% 錯誤率 | 在一個評估協議下的總錯誤 | 單獨的誤報率和漏報率 |
| 67.5% 完全正確分類 | 收到完全正確標籤的樣本 | 人類、AI 和混合樣本的數量和平衡 |
| 22.5% 混合文本部分識別 | 收到部分正確定位的混合文件 | 什麼符合部分學分 |
| 60% 經 AI 編輯的人類草稿被標記 | 對一種混合類別的敏感度 | 即使人類文本也牽涉其中,標記是否算作成功 |
如果資料集、標籤或評分規則不同,這些數字可以並存。例如,當混合段落獲得部分學分時,80% 的 AI 召回率可以與較低的完整文件分類率同時出現。
如果沒有基礎計數,這些數字無法合併成一個簡單的答案。我們需要知道測試了多少人類和 AI 樣本,這些樣本來自哪裡,是哪些生成模型產生的,它們有多長,以及 JustDone 使用了什麼決策閾值。
JustDone 自己的材料中也存在措辭差異。偵測器頁面提到學術和科學文本的 98% 表現,而一篇官方基準文章則報告了在某個特定測試中,科學和新聞子集沒有錯誤。
這並不能證明這兩個數字是假的。這確實意味著這兩個數字不應被重複,就好像它們描述的是相同的基準一樣。
什麼能讓準確度聲明更值得信賴?
一個有用的偵測器基準需要的不僅僅是一個總體百分比。至少,它應該揭示四個基本結果:
- 真陽性 (True positive):AI 文字被歸類為 AI。
- 真陰性 (True negative):人類文字被歸類為人類。
- 假陽性 (False positive):人類文字被歸類為 AI。
- 假陰性 (False negative):AI 文字被歸類為人類。
這會產生一個混淆矩陣。從中,讀者可以評估敏感度、特異度、精確度和誤報率,而不是僅僅依賴單一平均值。
類別平衡也很重要。想像一個包含 90 個 AI 樣本和 10 個人類樣本的基準。一個將所有內容都標記為 AI 的偵測器看起來會有 90% 的準確度,即使它會錯誤地指控每個個人類樣本。
測試集也應該與用於訓練模型或調整其閾值的數據真正分開。否則,基準可能衡量的是熟悉度而非泛化能力。
一個強大的評估應該揭示:
- 文章長度和語言。
- 寫作領域,例如學術、新聞、行銷或個人寫作。
- 用於 AI 樣本的生成器和模型版本。
- 文字是否經過改寫、語法檢查或人工編輯。
- 混合文件是作為二元還是混合評分。
- 偵測器使用的模型和閾值版本。
- 相同文字重複掃描的結果。
最後一項經常被忽視。準確度詢問結果是否正確。可重複性詢問在相同條件下,相同的輸入是否會收到相同的結果。
一個工具平均表現合理,但如果個別分數波動,仍然可能令人沮喪。
我的 JustDone 即時測試
我使用一篇專為本次評論撰寫的 76 字文章,對 JustDone 的公共偵測器進行了即時檢查。該文章描述了錯過火車、幫助鄰居搬箱子、打電話給編輯以及從文章中刪除一個未經查證的引文。
該樣本是刻意具體的。它包含了一個特定的日期、實際行動、一個小的不便,以及一個普通的修訂決定,而不是通用的解釋性散文。
JustDone 在第一次會話中返回了 85% 的 AI 內容。當我後來在一個新的瀏覽器會話中提交完全相同的文字時,它返回了 96% 的 AI 內容。
| 樣本 | 已知來源 | JustDone 結果 | 評估 |
|---|---|---|---|
| 個人火車軼事 | 為本次評論而寫的人類作品 | 85%,然後 96% AI 內容 | 明顯的誤報,會話差異達 11 點 |
這個結果很重要,因為它證明了人類作者身份和高 JustDone 分數可以並存。11 點的差異也顯示了為什麼可重複性值得與平均準確度分開評估。
公共介面在重新載入後沒有立即產生同會話的重新運行。一個新的瀏覽器會話確實產生了第二個結果,所以這不是一個嚴格控制的可重複性實驗。
這兩個觀察到的分數仍然是會話級別變化的有用證據,但它們不足以估計分數變化的頻率。評估產品的用戶應該在自己的帳戶和文件條件下運行更大的受控集。
這個有限的測試支持了一個謹慎的結論:JustDone 在單個人類文章上可能會自信地出錯,即使該文章包含具體的個人細節。
JustDone 最可能出錯的地方
沒有單一類別能保證錯誤。這些是證據較弱或分類變得更困難的條件。
短文本
JustDone 自己的基準指南建議至少 350 個字元以獲得更可靠的結果。簡短的答案、標題、電子郵件或討論貼文可能不包含足夠的風格證據來進行穩定分類。
偵測器仍然返回精確的百分比並不會產生更多證據。它只會產生一個看起來更精確的輸出。
正式或公式化的人類寫作
學術引言、商業摘要、實驗室方法、政策解釋和標準化回應通常使用可預測的詞彙和平衡的句子結構。這些也是偵測器可能與生成散文相關聯的模式。
將英語作為附加語言的作者可能會依賴更安全的結構和重複的過渡。在這種情況下獲得高分需要特別仔細的人工審查。
混合文件
一份文件可能包含人類大綱、AI 腦力激盪、人類重寫、引用材料、公式化標題和手動撰寫的結論。將該歷史簡化為一個二元標籤會遺失重要資訊。
總體百分比也可能隱藏定位錯誤。偵測器可能會識別出正確的總體方向,同時卻標示出錯誤的句子。
經過大量編輯的 AI 文本
人工編輯可以改變節奏、詞彙、範例、結構和論點。一旦這些特徵改變,最終文件可能就不再類似於原始生成器輸出。
這並不會使文本在道德上變得可接受或不可接受。這取決於適用的政策和披露規則,而不是偵測器的成功與否。
多樣化的 AI 輸出
提示可以產生片段、對話、不均勻的句子長度、個人情境或刻意非正式的語言。這些特徵可能會削弱偵測器所依賴的規律性,並產生漏報。
使用 Lynote AI 偵測器獲取結構化的第二意見
當 JustDone 的結果看起來令人驚訝時,第二個偵測器可以顯示該訊號是孤立的還是跨不同模型一致的。Lynote AI 偵測器 為 AI 生成、混合和人類撰寫的內容提供三向結果,以及針對可能是 AI 或改寫的句子進行標示。
它仍應作為審查輔助工具而非最終權威使用。兩個偵測器之間的一致性會強化模式訊號,但它並不能產生直接的作者身份證據。
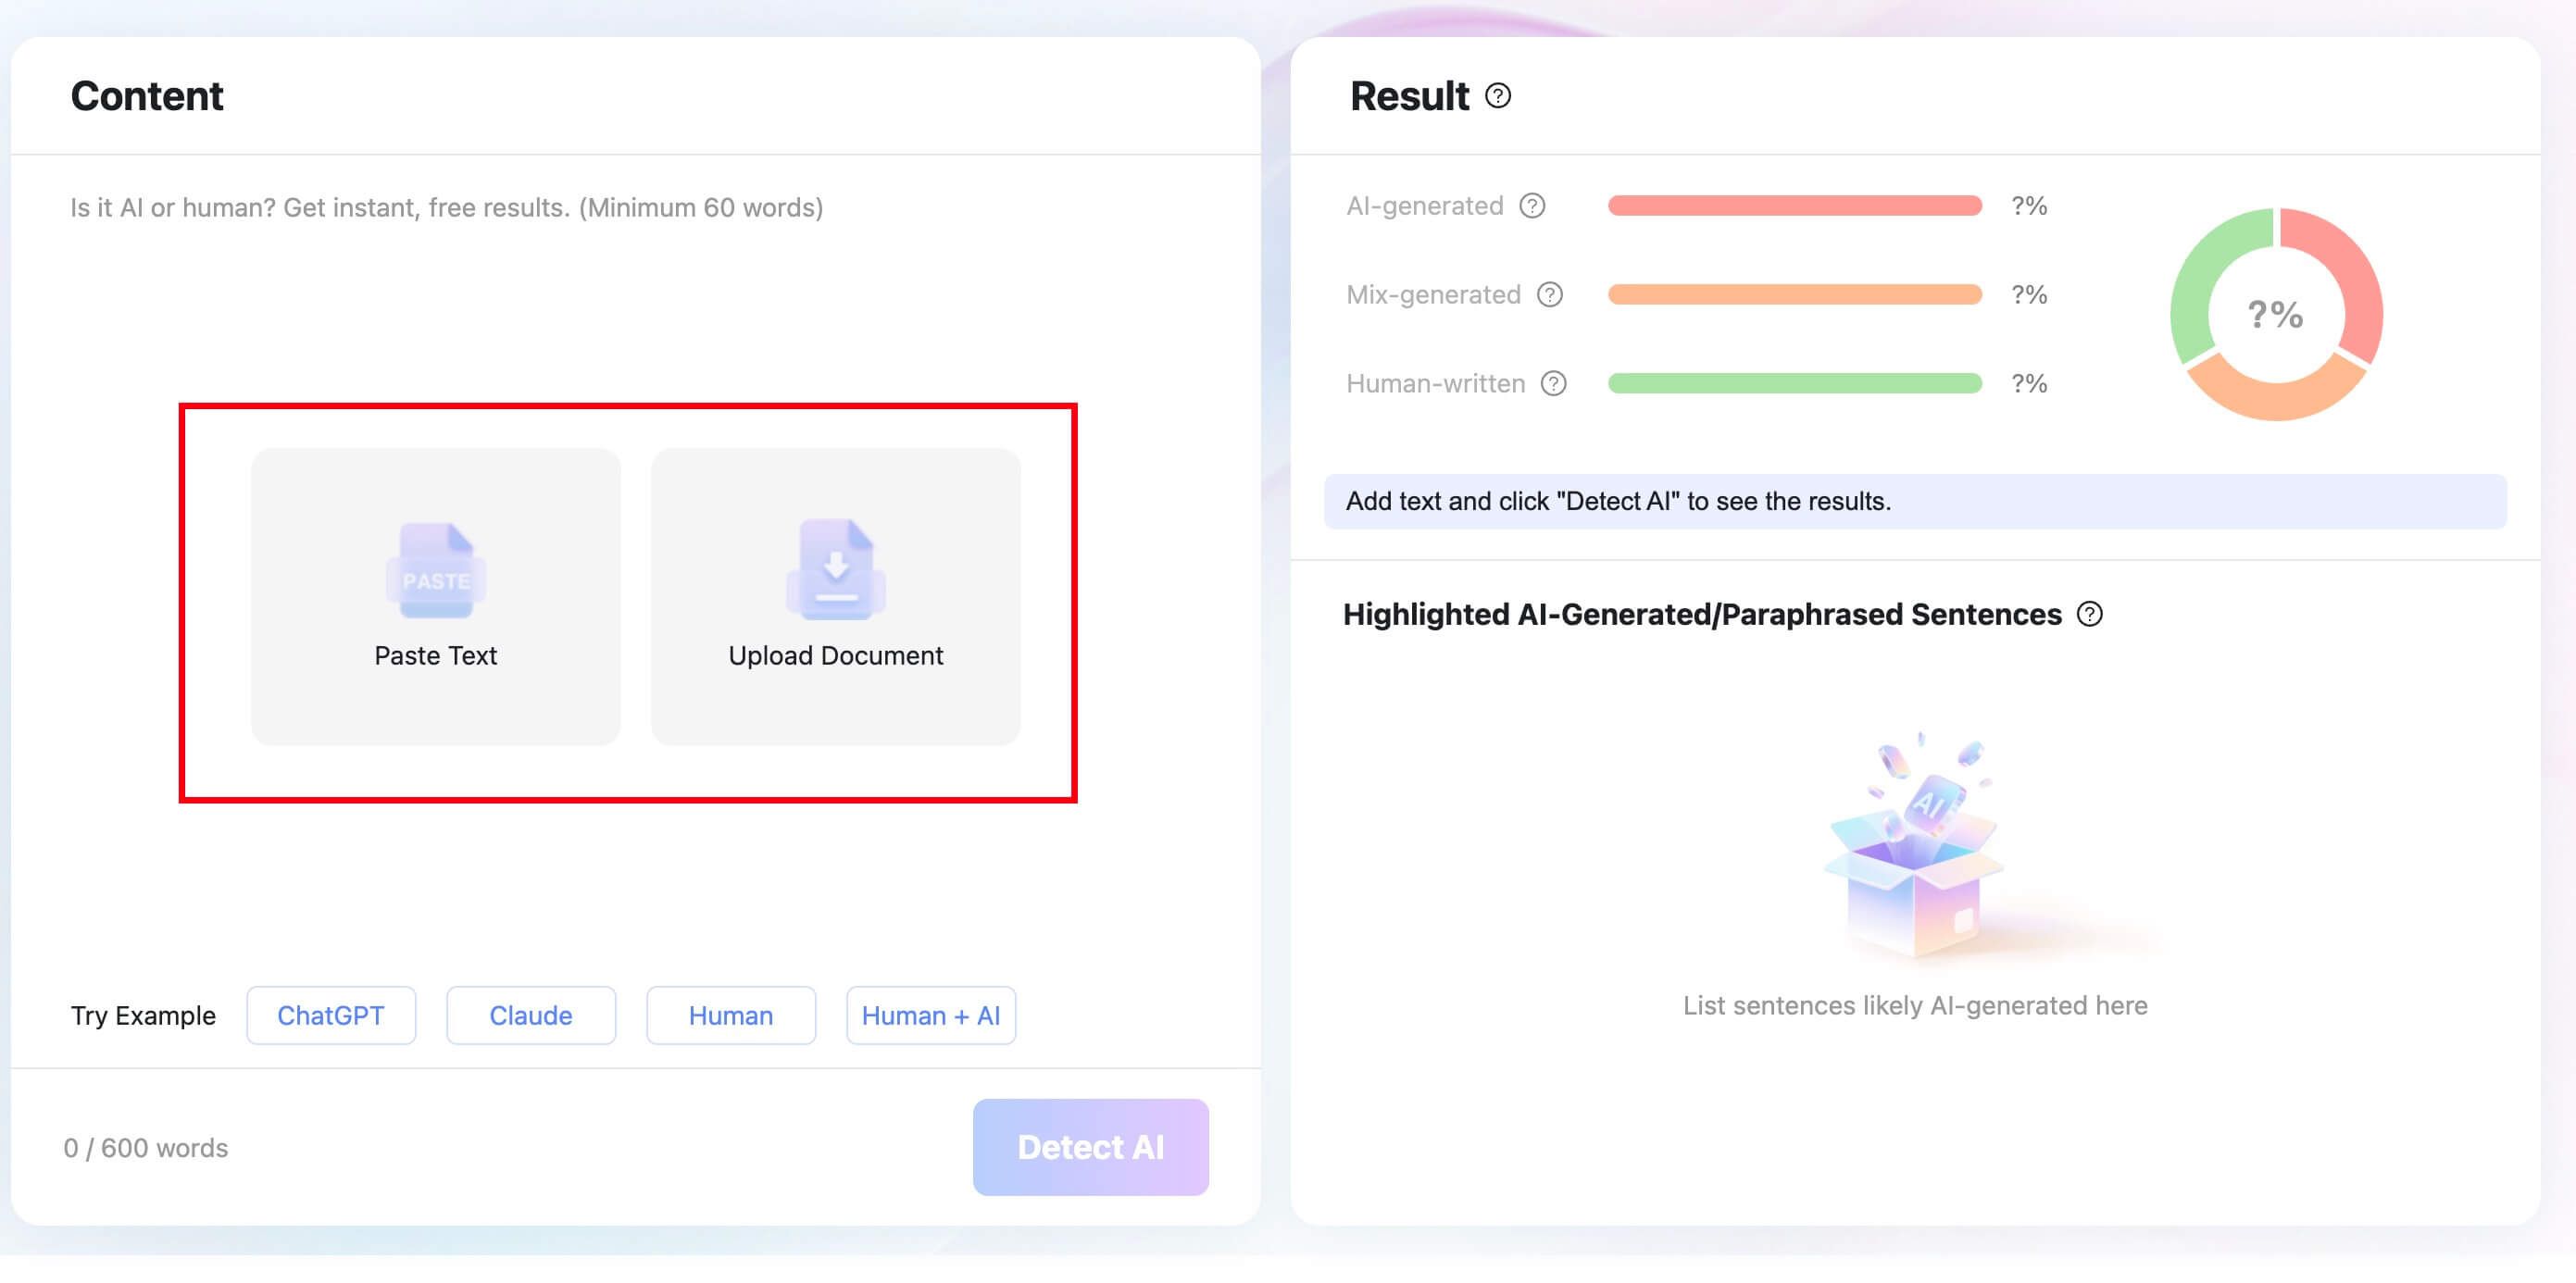
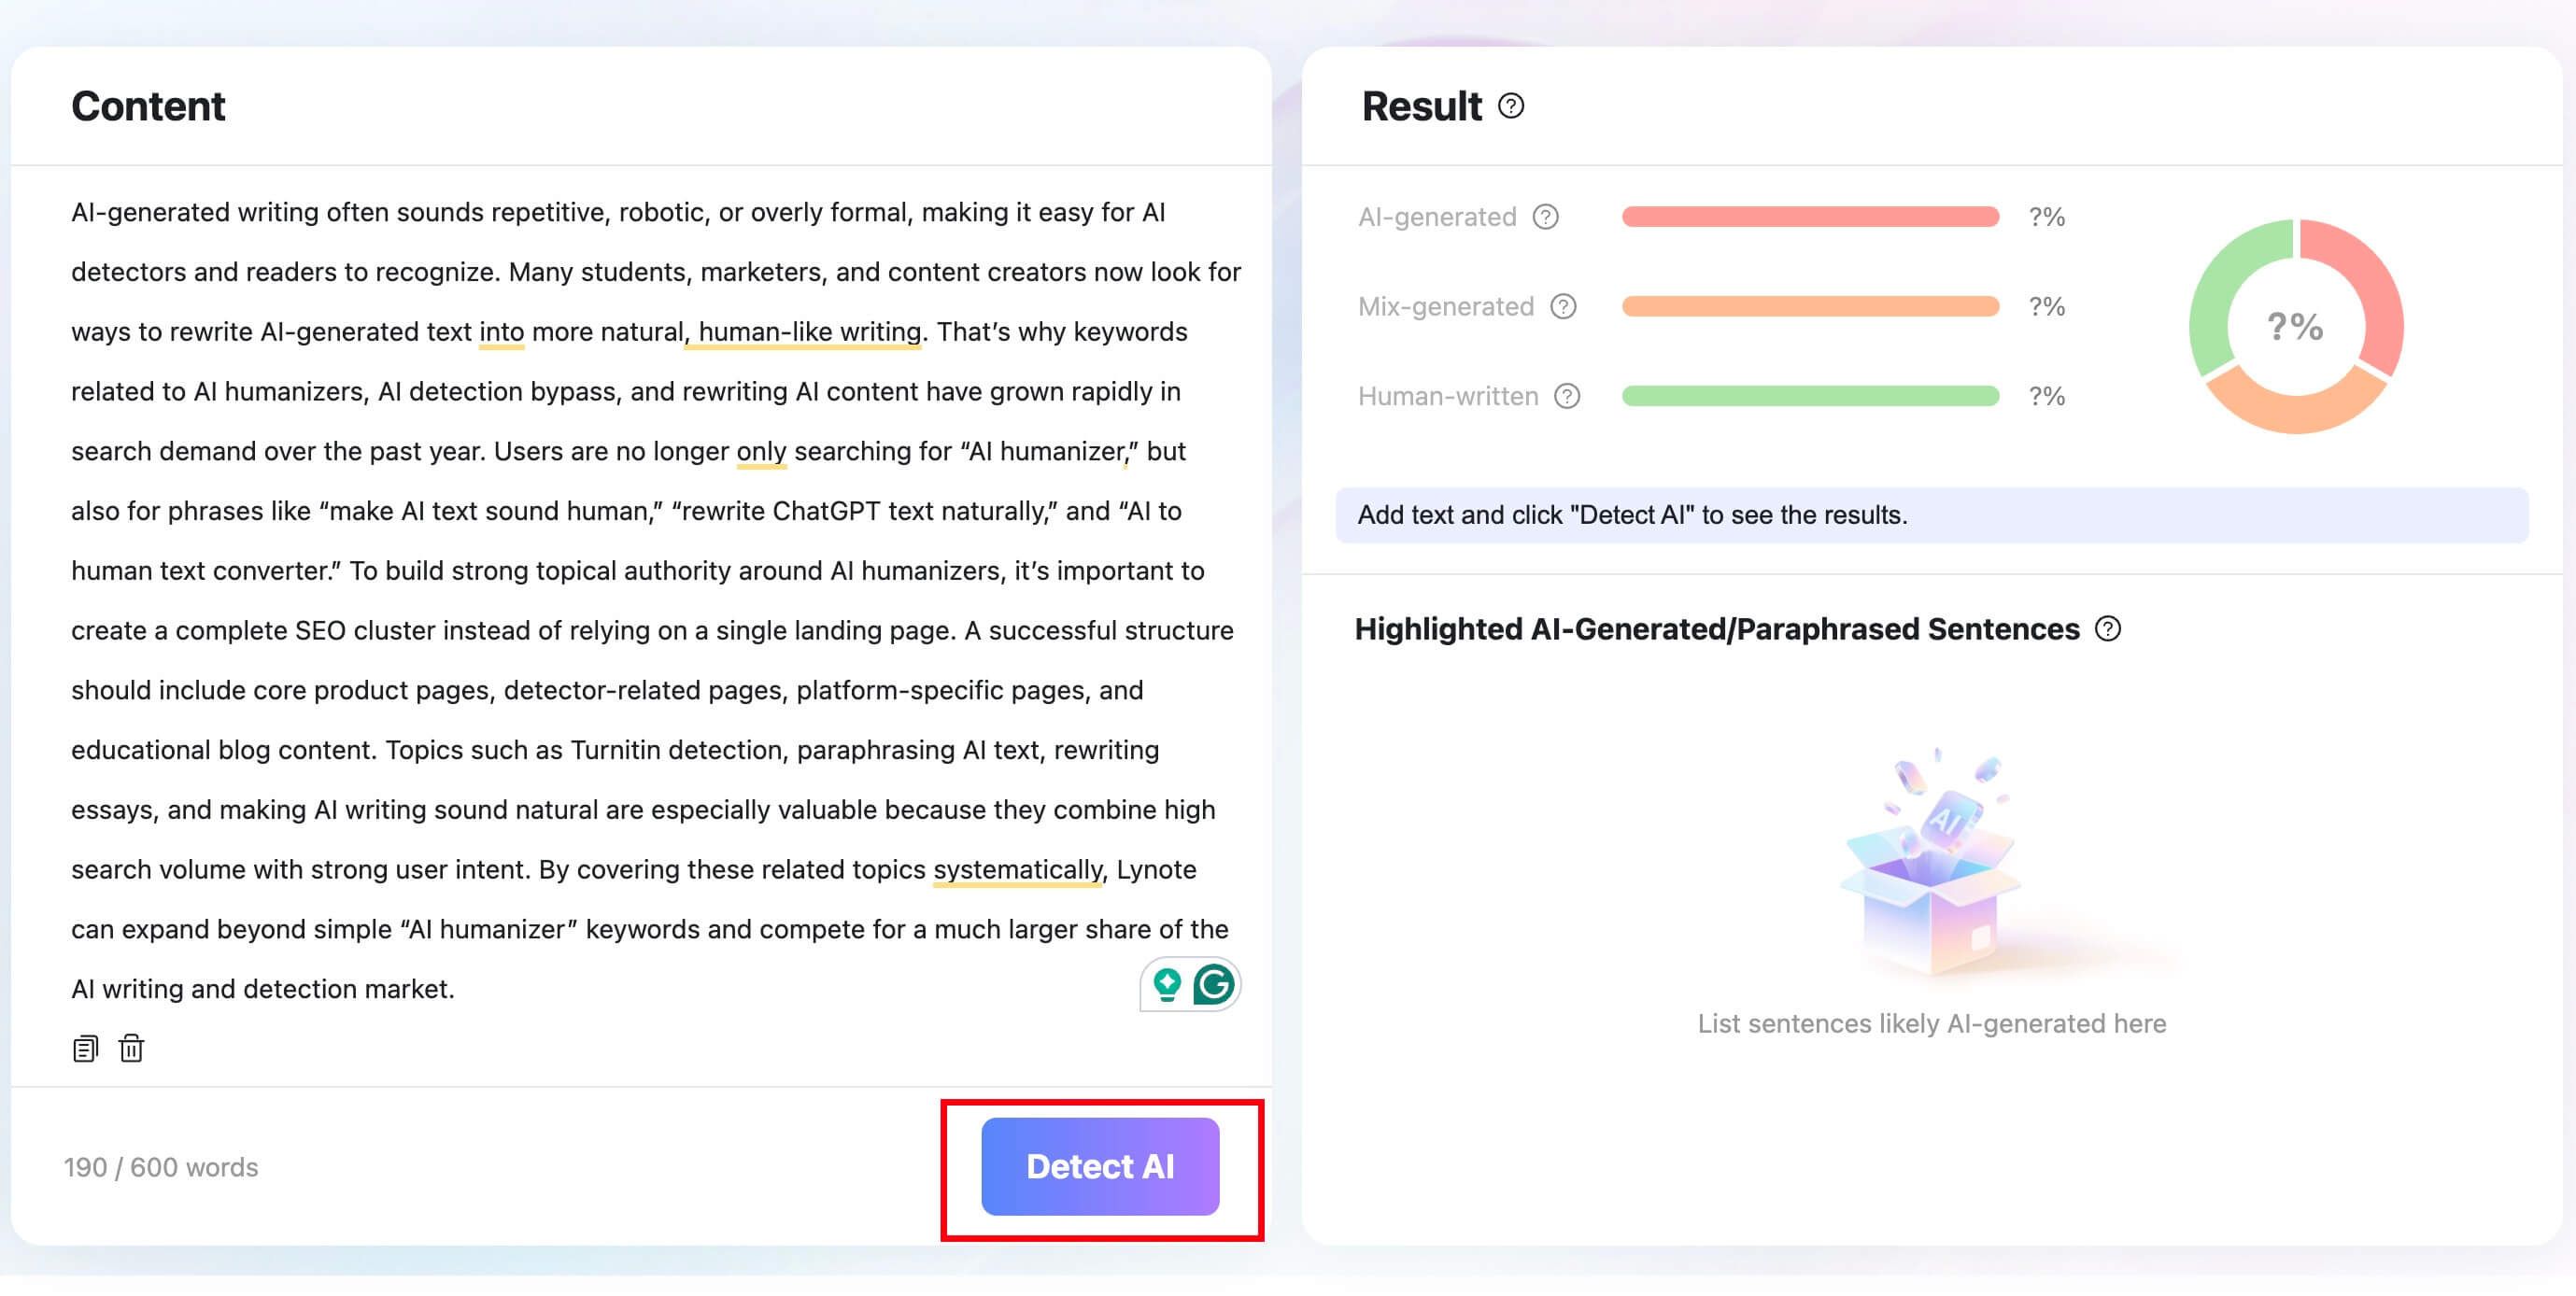
步驟 1:貼上文字或上傳文件
開啟 Lynote AI 偵測器並將文章貼到輸入框中。對於較長的論文或報告,請改為上傳支援的 DOCX、PDF 或 TXT 文件。
使用足夠的連續散文以提供有意義的上下文。避免從標題、項目符號列表或幾個孤立的句子中得出強烈結論。
步驟 2:執行偵測
點擊「偵測 AI」,讓 Lynote 分析文字。保留您掃描的確切版本,以便您可以將其與 JustDone 輸入進行比較,並避免測試之間意外的差異。
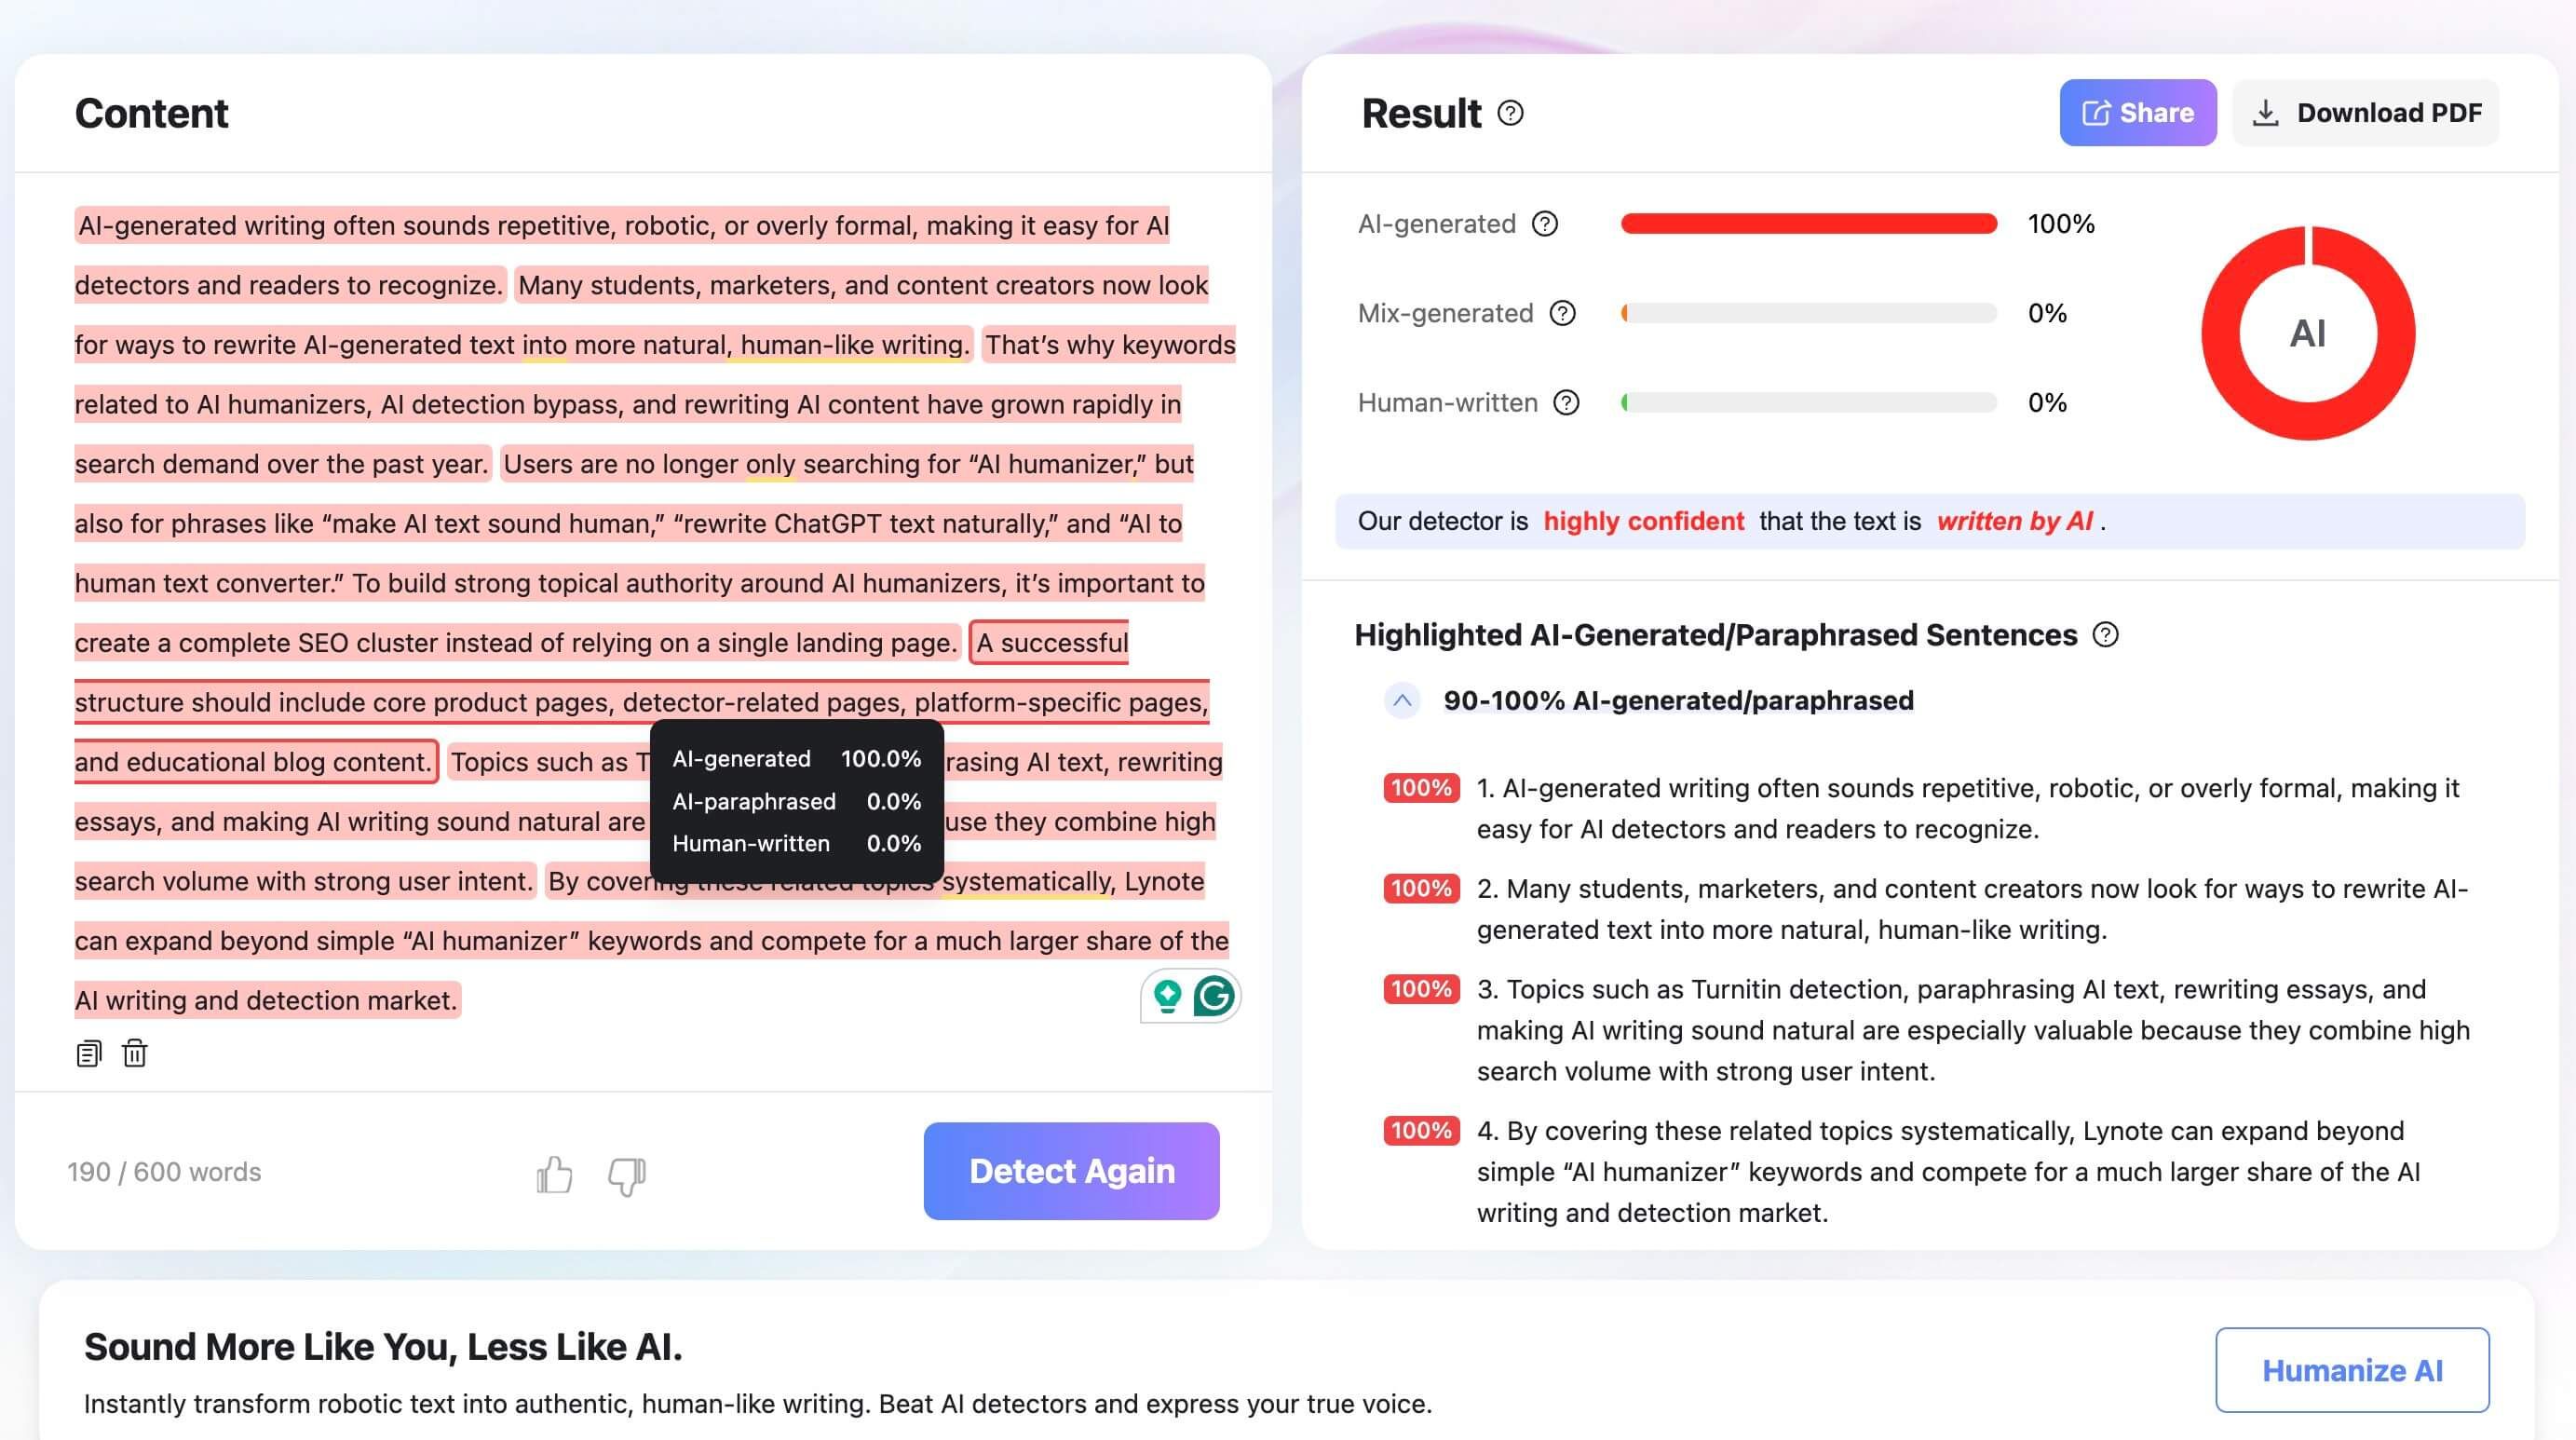
步驟 3:審查分佈和標示的句子
一起檢查 AI 生成、混合和人類撰寫的百分比。然後檢查哪些句子被標記為可能是 AI 或改寫的。
三向劃分對於具有混合編輯歷史的文件特別有用。它提供了比將每個文件強制歸入簡單的全人類或全 AI 類別更細緻的審查介面。
最終判斷仍應包括文件的目的、草稿、來源和修訂歷史。Lynote 是一個第二訊號,而不是決定性的決勝者。

當 JustDone 標記人類寫作時該怎麼辦
高分可能會令人不安,特別是當您自己撰寫該段落時。最可行的回應是保留證據並調查結果,而不是透過重複修改文字直到偵測器批准來損害您的寫作。
- 檢查輸入長度。 將短段落視為薄弱證據,即使百分比看起來很精確。
- 閱讀標示的句子。 詢問該工具是識別出真正的寫作問題,還是僅僅是一種傳統結構。
- 驗證確切的文件版本。 格式變更、遺失部分或貼上的摘錄可能會改變上下文。
- 使用一個獨立的偵測器。 比較方向和句子標示,而不僅僅是標題百分比。
- 保留過程證據。 保留大綱、筆記、草稿、文件歷史、研究材料和引用。
- 檢查相關政策。 允許的腦力激盪、校對、翻譯和生成規則因課程、雇主或客戶而異。
- 請求人工審查。 重要的決定應考慮寫作過程和作者的解釋。
不要假設降低分數就能證明真實性。偵測器分數可能會改變,而底層的作者身份歷史卻保持完全相同。
免費存取、付費方案和 2 美元試用
JustDone 將其偵測器與包含 35 種以上工具的付費套裝一起銷售。這在評估價值時很重要:對於使用更廣泛寫作套件的人來說,訂閱更容易證明其合理性,而不是僅偶爾需要 AI 檢查的人。
在本次評論時,定價頁面顯示促銷月費方案為 19.99 美元,年費方案則顯示為每月 9.99 美元的等值。價格和折扣可能會變動,因此應在購買時確認。
最重要的細節是七天存取優惠。它廣告為 2 美元,目前除非取消,否則每月續訂費用為 39.99 美元。
在開始試用前請閱讀續訂條款,記下帳單日期,如果完整訂閱不符合您的需求,請使用帳戶取消控制項。便宜的試用和便宜的持續方案不是一回事。
獨立測試和用戶報告了什麼
外部證據好壞參半,品質各異。法新社的一項調查報告了對人類撰寫的多語言樣本的誤報,並指出 JustDone 承認沒有任何偵測器能保證完全準確。
JustDone 還告訴法新社,免費偵測器在需求高峰期可能會不那麼精確,因為它可以使用較輕量的模型。當用戶將公共檢查與付費或基於帳戶的結果進行比較時,這一警告尤其相關。
其他小型評論報告了三種重複出現的模式:
- 較長、明顯由 AI 生成的段落比短片段更容易分類。
- 人類寫作可能會獲得高 AI 分數。
- 相同的段落可能會在不同會話或測試中獲得不同的分數。
這些報告不應被歸結為一個普遍的準確度數字。有些是小規模的抽查,有些來自銷售競爭產品的公司,而 Reddit 評論則是軼事。
它們的價值在於識別值得測試的失敗模式。重複的教訓與我的即時結果一致:用戶應該用他們真正了解的代表性文本(包括人類樣本)來驗證 JustDone,而不是僅僅用明顯的聊天機器人輸出進行評估。
JustDone AI 偵測器的優缺點
優點
- 直觀的貼上和檢查工作流程。
- 支援 PDF、Word 和 TXT 上傳。
- 廣告文件長度限制高。
- 在其報告工作流程中提供句子級別的回饋。
- 作為更大寫作和研究工具包的一部分。
- 公開承認 AI 偵測並非完全準確。
缺點
- 官方標題指標需要更多方法論背景。
- 在單個人類文章上,誤報可能很高。
- 短文本和混合文本仍然難以解釋。
- 我的會話中,公共偵測器未能產生明確的重複結果。
- 過於自信的百分比可能會導致過度自信。
- 低成本試用期結束後,除非取消,否則會以更高的月費續訂。
誰應該使用 JustDone?
JustDone 對於想要快速初步掃描並願意檢查實際句子的作家、編輯或內容經理來說是合理的選擇。它還可以幫助團隊識別值得更仔細過程審查的草稿。
它不太適合檢查幾個短句的用戶,因為可用的訊號很弱。對於任何期望獲得關於真實混合作者身份的二元答案的人來說,它也是一個糟糕的選擇。
教師、雇主和客戶不應將其作為指控或懲罰的唯一依據。在這些情況下,誤報的成本太高,而寫作過程證據與作者身份的關聯更直接。
JustDone AI 偵測器常見問題
JustDone AI 偵測器準確嗎?
JustDone 能夠正確識別一些明顯由 AI 生成的文本,特別是在較長的樣本中,但其準確度不足以持續證明作者身份。其官方數據描述了不同的基準,且誤報仍然可能發生。
JustDone 是一個好的 AI 偵測器嗎?
它是一個有用的篩選工具,具有方便的介面和文件支援。但它不適合作為學術、就業或客戶糾紛的唯一決策者。
JustDone 能偵測 ChatGPT、Claude 和 Gemini 嗎?
JustDone 表示其模型經過訓練,能夠識別與 ChatGPT、GPT 模型、Claude、Gemini、Llama、DeepSeek 和其他生成器相關的模式。支援聲明不保證對每個段落都能正確分類。
JustDone 會錯誤地標記人類寫作嗎?
是的。在我的即時檢查中,一篇人類撰寫的個人軼事在不同的瀏覽器會話中分別獲得了 85% 和 96% 的 AI 內容結果。獨立報告也描述了人類文本的誤報。
為什麼 JustDone AI 分數可能會改變?
偵測器模型、閾值、依賴流量的處理、輸入上下文和產品更新都可能影響結果。如果相同的文本發生實質性變化,應將這種不穩定性視為降低對分數信心的原因。
我應該用 JustDone 掃描多少文本?
JustDone 的基準指南建議至少 350 個字元以獲得更可靠的結果。較長的連續散文通常比標題、列表或短段落提供更多風格證據。
JustDone AI 偵測器是免費的嗎?
JustDone 提供公共即時檢查介面,而更完整的報告和更廣泛的套件則與其付費產品相關聯。目前的存取規則和方案限制可能會改變。
JustDone 分數能證明某人使用了 AI 嗎?
不能。該分數評估寫作是否類似於與 AI 輸出相關的模式。它不觀察寫作過程,不識別文本的創建者,也不取代草稿、修訂歷史、政策背景和人工審查。
最終評估:JustDone AI 偵測器有多準確?
JustDone 的準確度足以作為篩選提示使用,但不足以作為作者身份證據。其最強大的實用功能是易於文件輸入和句子級別審查;其核心限制是百分比看起來比底層推斷更確定。
我的即時檢查在不同會話中對同一篇人類撰寫的軼事產生了 85% 和 96% 的 AI 分數。這個有限的測試並不能衡量 JustDone 的整體準確度,但它證明了高分和真實的人類作者身份可以同時發生。
使用 JustDone 來決定在哪裡需要更仔細地查看。對於任何有意義的決定,請將結果與第二個偵測器進行比較,檢查被標記的語言,保留寫作歷史,並讓人評估完整上下文。