
GPT-2 XL (1.5B) Top-K 40 樣本
新民主黨將提名其首位女性總統候選人,這讓亞伯達省紅鹿選區的許多女性選民感到有些失望。新民主黨員 Cheri DiNovo 表示,她對黨不提名女性候選人的決定感到失望。在官方宣布當天,紅鹿居民收到了一系列電子郵件中的第一封,內容關於該黨為何不打算讓女性進入橢圓形辦公室。該黨的通訊副總裁 Rachelle Huppert 表示,這項決定是在去年二月做出的,她預計這將在愛德蒙頓的黨領導會議上獲得批准。
我們利用基於 RoBERTa 的基礎模型,分析詞元(token)的機率分佈,以識別 GPT-2 採樣方法留下的獨特「指紋」。
儘管現代偵測器專注於 GPT-4,但我們的工具專為 15 億參數的 GPT-2 模型進行了優化,能捕捉到一般工具常忽略的細微差別。
我們測量文字的「隨機性」。GPT-2 經常產生低困惑度的序列,我們的系統會將其標記為人類作者在統計上不太可能寫出的內容。
我們的偵測器無需任何先前的上下文。它會評估 GPT-2 在不同溫度和 Top-K/Top-P 採樣設定下的原始輸出。
專為研究人員和開發者設計。您的資料集將保持私密;我們採用加密處理,絕不儲存您提交的字串用於訓練。
可視化每個單詞的可能性。我們的介面會標示出 GPT-2 模型會以高置信度預測的詞元,指示其為 AI 生成。

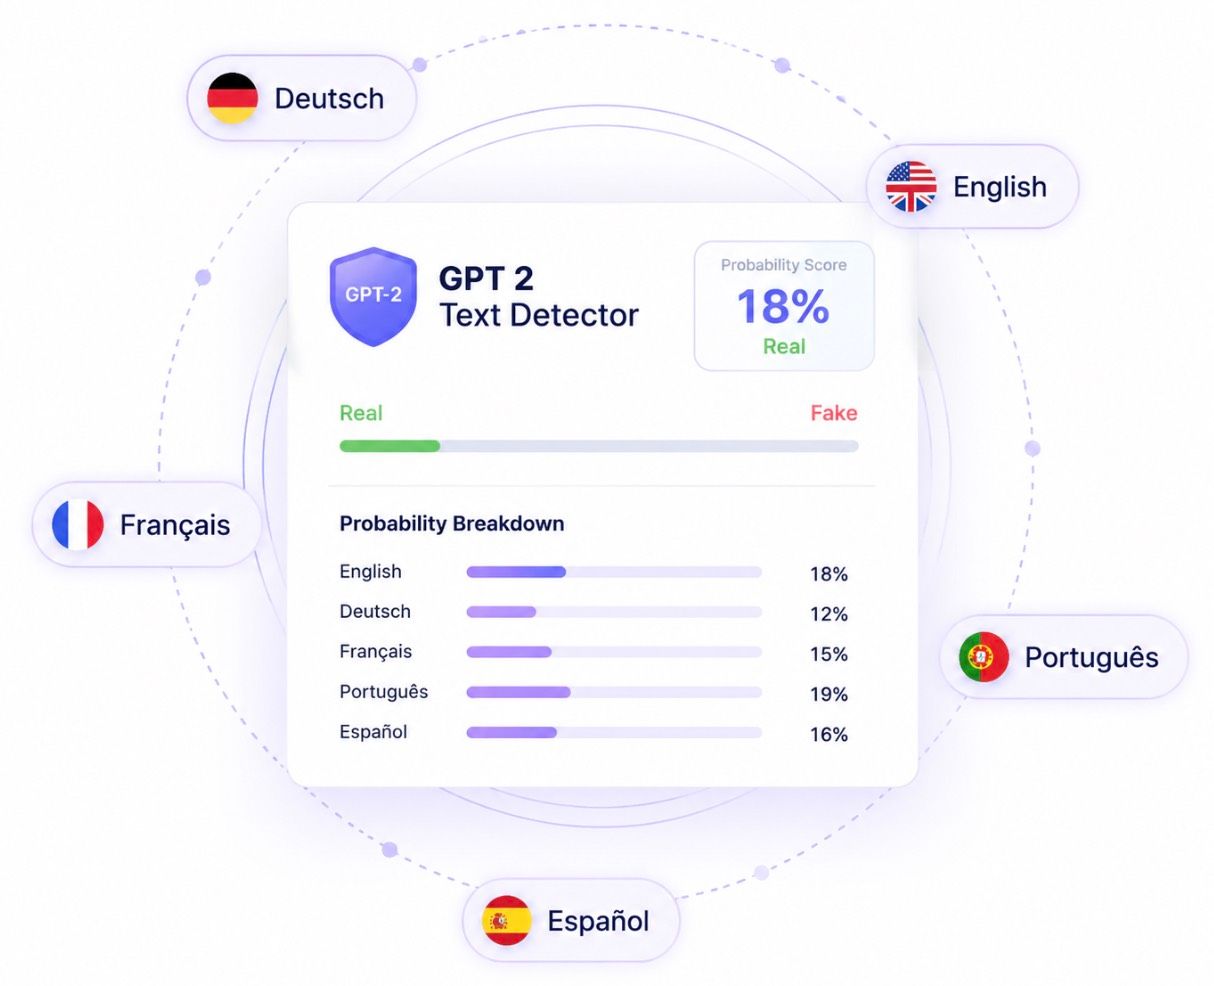
獲取一份綜合報告,顯示「真實與偽造」的機率分數。我們的分析將文本分解成多個片段,精確識別 GPT-2 生成模式最突出的位置。分析多種語言的 AI 生成文本,並接收詳細的機率洞察,幫助您從全球來源偵測 AI 撰寫的內容。

我們使用 Lynote 的 GPT-2 輸出偵測器,測試了來自 OpenAI 的 GPT-2 XL (1.5B) Top-K 40 驗證資料集中的一段文字。整段文字的結果顯示 51.7% 為 AI 生成,48.3% 為人類撰寫,而個別句子的 AI 機率則高達 90.3%。這個真實結果顯示了為何 GPT-2 偵測在結合文件級分數和句子級證據時效果最佳。
新民主黨將提名其首位女性總統候選人,這讓亞伯達省紅鹿選區的許多女性選民感到有些失望。新民主黨員 Cheri DiNovo 表示,她對黨不提名女性候選人的決定感到失望。在官方宣布當天,紅鹿居民收到了一系列電子郵件中的第一封,內容關於該黨為何不打算讓女性進入橢圓形辦公室。該黨的通訊副總裁 Rachelle Huppert 表示,這項決定是在去年二月做出的,她預計這將在愛德蒙頓的黨領導會議上獲得批准。
總體結果:證據混雜。 文件級分數接近,但有幾句話顯示出強烈的 GPT-2 模式。請同時審查總體機率和突出顯示的句子,而不是僅依賴一個數字。
GPT-2 生成的文字聽起來可能很流暢,但仍會留下可測量的統計模式。GPT-2 輸出偵測器會尋找可預測的詞元選擇、低困惑度、重複的句子結構以及寫作節奏的有限變化。當偵測器分析較長的段落而非單一句子時,這些訊號會變得更有用。
可預測的措辭:GPT-2 經常選擇高機率的下一個詞元,產生流暢但統計上規律的句子。
重複的結構:類似的轉場、句子開頭和語法模式可能會在整個段落中出現。
低困惑度:與自然多樣的人類寫作相比,語言模型更容易預測其措辭。
不均勻的突發性:句子長度和複雜度可能會保持一致過久,然後才突然改變。
 步驟 1
貼上原始 GPT-2 輸出
複製您懷疑由 GPT-2 生成的文字,並貼到我們的安全分析欄位。我們支援原始文字和 .txt 檔案進行批次處理。
 步驟 2
執行統計掃描
點擊「分析」以觸發我們基於 RoBERTa 的分類器。系統將根據已知的 GPT-2 輸出模式評估詞元分佈。
 步驟 3
解讀分數
檢視最終百分比。高「偽造」分數表示文字遵循 GPT-2 語言模型可預測的統計路徑。
複製您懷疑由 GPT-2 生成的文字,並貼到我們的安全分析欄位。我們支援原始文字和 .txt 檔案進行批次處理。
點擊「分析」以觸發我們基於 RoBERTa 的分類器。系統將根據已知的 GPT-2 輸出模式評估詞元分佈。
檢視最終百分比。高「偽造」分數表示文字遵循 GPT-2 語言模型可預測的統計路徑。

驗證資料集,並將早期語言模型的「可偵測性」與人類撰寫的對照組進行基準測試。
驗證資料集,並將早期語言模型的「可偵測性」與人類撰寫的對照組進行基準測試。

稽核 2019-2021 年的舊網路檔案和資料集,以識別早期湧入的 GPT-2 生成垃圾郵件和機器人內容。
稽核 2019-2021 年的舊網路檔案和資料集,以識別早期湧入的 GPT-2 生成垃圾郵件和機器人內容。

測試您自己微調的 GPT-2 模型。使用我們的偵測器來查看您的自訂輸出是否與人類散文無法區分。
測試您自己微調的 GPT-2 模型。使用我們的偵測器來查看您的自訂輸出是否與人類散文無法區分。

識別仍利用 GPT-2 進行低成本、高產量文字生成的自動化「假新聞」或社群媒體機器人活動。
識別仍利用 GPT-2 進行低成本、高產量文字生成的自動化「假新聞」或社群媒體機器人活動。
清理您的訓練資料,篩選掉可能導致模型崩潰或資料品質下降的合成 GPT-2 文字。
研究 AI 寫作的演變。在您的研究中,使用我們的工具來區分人類撰寫的文字和早期基於 Transformer 生成的內容。
將量化方法應用於法律或調查案件,以判斷數位文件的來源是否為機器生成。
標記由舊版腳本生成的自動化留言和論壇貼文,這些腳本為了速度仍依賴 GPT-2 架構。
在駁斥之前,快速判斷病毒式傳播的「洩漏」或文件是否實際上是由 GPT-2 實例「虛構」的。
將我們的 API 整合到您的工作流程中,以自動篩選使用者提交的內容,找出低品質的 GPT-2 合成文字。
自然語言處理研究主管

這是我見過最穩健的 RoBERTa 偵測器實作。它以令人難以置信的精確度處理 GPT-2 特有的取樣偽影。
網路安全分析師
我們使用它來審核大量可疑的論壇貼文資料集。它成功識別出數千個由 GPT-2 生成的條目,而這些是其他工具所遺漏的。
資料完整性主管
概率熱圖對我們的審計工作來說是顛覆性的。能夠確切地看到哪些標記(tokens)標示出 GPT-2 的特徵,讓我們的報告更具說服力。
機器學習工程師
快速、輕巧且高度專一。如果您正在處理舊版 AI 文本,您需要一個了解 GPT-2 架構的工具。這就是了。
計算語言學家
15 億參數模型的準確率令人印象深刻。對於任何研究合成媒體歷史和影響的人來說,這都是一個必不可少的工具。
檔案專員
終於,一個不會將所有東西都歸類為「AI」的工具。它專門針對 GPT-2,這正是我們進行歷史網站審計所需要的。
對 GPT-2 識別有技術問題嗎?我們的工程團隊已在下方提供詳細資訊。
雖然它可能會捕捉到一些模式,但這個特定工具是為 GPT-2 優化的。對於較新的模型,我們建議使用我們更新的「通用 AI 偵測器」,該偵測器考慮了 RLHF 調校。
該分數是基於詞語序列是由 GPT-2 模型預測的可能性。99% 的「偽造」分數意味著文本完美符合 GPT-2 的統計輸出。
是的。即使 GPT-2 模型是針對特定數據(例如醫療或法律文本)進行了微調,底層的 Transformer 架構仍然會留下可偵測的統計痕跡。
短句(少於 10 個詞)為統計分析提供較少的數據點,這可能導致較高的變異性。我們建議分析至少 50 個詞的段落以獲得最高準確度。
了解 AI 偵測器如何運作、為什麼會出現誤報,以及如何在做出決定前解讀概率分數。
 GPT-2 117M


