

ใช่ เนื้อหา GPT-6 Astra สามารถตรวจจับได้ในการทดสอบที่เผยแพร่ในปัจจุบัน การศึกษาจากผู้จำหน่ายรายใหญ่สองรายระบุว่าตัวอย่าง AI ที่ไม่ได้รับการแก้ไขและเป็นที่รู้จักมากกว่า 99% ที่พวกเขาให้คะแนน และการเปรียบเทียบขนาดเล็กพบว่าเครื่องมือตรวจจับห้าแบบต่างก็ระบุเรียงความ Astra เดียวกัน นั่นเป็นหลักฐานที่ชัดเจนว่าผลลัพธ์ของ Astra ที่ผ่านการขัดเกลาแล้วไม่ได้กลายเป็นสิ่งที่เครื่องมือตรวจจับ AI มองไม่เห็นโดยอัตโนมัติ
ไม่ใช่หลักฐานว่าเครื่องมือตรวจจับทุกตัวจะจับข้อความ Astra ได้ทุกส่วน ที่สำคัญกว่านั้น คะแนนที่สูงไม่สามารถบอกได้ว่าใครเป็นผู้เขียนเอกสารนั้น โมเดลใดสร้างขึ้น หรือบุคคลนั้นใช้ AI เลยหรือไม่ คำถามที่เป็นประโยชน์ไม่ใช่แค่ "AI ตรวจจับ GPT-6 Astra ได้หรือไม่" แต่เป็นสิ่งที่หลักฐานที่มีอยู่จริงวัดได้ และสิ่งที่ยังไม่ได้รับการแก้ไข
คำตอบด่วน: เนื้อหา GPT-6 Astra สามารถตรวจจับได้หรือไม่?
สำหรับร้อยแก้วภาษาอังกฤษที่ไม่ได้รับการแก้ไขและมีความยาวที่เหมาะสม คำตอบมักจะเป็นใช่ ผลลัพธ์สาธารณะที่แข็งแกร่งที่สุดที่มีอยู่ในเดือนตุลาคม 2026 ชี้ไปในทิศทางเดียวกัน แม้ว่าจะมาจากบริษัทผู้พัฒนาเครื่องมือตรวจจับและใช้ตัวอย่าง เกณฑ์ และกฎการรวมที่แตกต่างกัน
| การทดสอบที่เผยแพร่ | วัสดุ Astra ที่ทดสอบ | ผลลัพธ์ที่รายงาน | สิ่งที่ยืนยัน | สิ่งที่ไม่ได้ยืนยัน |
|---|---|---|---|---|
| Originality.ai | การตอบกลับ Astra ที่รู้จัก 1,000 รายการในห้าหมวดหมู่การเขียน | 999 รายการผ่านเกณฑ์ AI | การตรวจจับตัวอย่าง AI ที่รู้จักนี้สูงมากในการตั้งค่าเครื่องมือตรวจจับหนึ่งรายการ | อัตราการแจ้งเตือนที่ผิดพลาดหรือประสิทธิภาพในการเขียนของมนุษย์ |
| Pangram | การตอบกลับ Astra ที่ให้คะแนน 986 รายการจากพรอมต์ที่กรองแล้ว | 982 AI, 3 ผสม, 1 มนุษย์ | อัตราการจำแนกประเภท AI เต็มรูปแบบสูงมากสำหรับข้อความที่เข้าเกณฑ์ | ประสิทธิภาพต่ำกว่าขั้นต่ำ 50 คำ หรือในการควบคุมของมนุษย์ |
| การเปรียบเทียบเครื่องมือตรวจจับห้าตัว | เรียงความ Astra 300 คำหนึ่งฉบับ | เครื่องมือ 5 ใน 5 ตัวระบุว่ามี AI; สี่ตัวแสดงคะแนน AI สูงสุด | เครื่องมือตรวจจับหลายตัวเห็นด้วยกับเรียงความนั้น | ความแม่นยำทั่วทั้งโมเดลจากตัวอย่างเอกสารเดียว |
| การทดลองความยาวข้อความ | ข้อความ Astra 40 รายการที่แสดงในสี่ความยาว | 9/40 ตรวจพบที่ 25 คำ, 29/40 ที่ 50 คำ, และ 40/40 ที่ 100 และ 200 คำ | ความยาวสามารถเปลี่ยนแปลงผลลัพธ์ของเครื่องมือตรวจจับหนึ่งตัวได้อย่างมาก | ความยาวขั้นต่ำสากลสำหรับเครื่องมือตรวจจับทุกตัว |
ข้อสรุปเชิงปฏิบัติเป็นเรื่องง่าย: บทความ Astra ที่สมบูรณ์มีแนวโน้มที่จะสร้างสัญญาณการตรวจจับที่มีความหมายมากกว่าประโยคที่คัดลอกมาจากบทความนั้น แม้กระนั้น "ถูกระบุ" หมายความว่าการเขียนตรงกับรูปแบบที่เครื่องมือตรวจจับเชื่อมโยงกับ AI ไม่ได้หมายความว่าเครื่องมือดังกล่าวสามารถกู้คืนป้ายกำกับ GPT-6 ที่ซ่อนอยู่ได้
สิ่งที่ GPT-6 Astra เปลี่ยนแปลง – และสิ่งที่ไม่เปลี่ยนแปลง
OpenAI วางตำแหน่ง GPT-6 Astra ให้เป็นโมเดลที่มีความสามารถสูงสุดสำหรับการให้เหตุผล การวิจัย การเขียนโค้ด การใช้งานคอมพิวเตอร์ และการสร้างเอกสารที่ซับซ้อน มันถูกสร้างขึ้นมาเพื่อทำตามคำแนะนำโดยละเอียดและรองรับงานที่ซับซ้อน ซึ่งสามารถสร้างฉบับร่างที่สอดคล้องกันและมีประโยชน์มากกว่าคำตอบของแชทบอททั่วไป
เอกสารของโมเดลเองยังระบุถึงแนวโน้มในการจัดรูปแบบโดยละเอียดและวลีที่ใช้ซ้ำ เว้นแต่ผู้ใช้จะระบุรูปแบบการเขียนที่แตกต่างกัน ข้อสังเกตนั้นช่วยอธิบายว่าทำไมความสามารถที่ได้รับการปรับปรุงและการตรวจจับจึงสามารถอยู่ร่วมกันได้ เอกสารอาจมีความถูกต้อง จัดระเบียบได้ดี และคล่องแคล่ว ในขณะที่ยังคงแสดงความสม่ำเสมอที่ตัวจำแนกทางสถิติสังเกตเห็น
นี่คือจุดที่ผู้คนมักจะเข้าใจผิด ร้อยแก้วที่ดีขึ้นไม่จำเป็นต้องดูเหมือนมนุษย์มากขึ้นสำหรับเครื่องมือตรวจจับ เพราะเครื่องมือตรวจจับไม่ได้ให้คะแนนร้อยแก้วเพื่อความฉลาดหรือประโยชน์ใช้สอย พวกเขากำลังประเมินว่ารูปแบบภาษาของมันคล้ายกับเนื้อหาในข้อมูลการฝึกอบรม AI และมนุษย์ของพวกเขาหรือไม่
การเขียนที่ดูไม่เป็นธรรมชาติก็ไม่ได้หมายความว่า AI เป็นผู้เขียนโดยอัตโนมัติ มนุษย์ก็มีการใช้คำเชื่อมซ้ำๆ ใช้โครงสร้างเรียงความที่เป็นสูตรสำเร็จ และเขียนประโยคทั่วไปเช่นกัน เครื่องมือตรวจจับอ่านรูปแบบ ไม่ใช่วัตถุประสงค์ ผู้เขียน หรือประวัติเบื้องหลังเคอร์เซอร์
สิ่งที่การทดสอบการตรวจจับ GPT-6 Astra ที่เผยแพร่พบ
การศึกษาหลักดูสอดคล้องกันอย่างน่าทึ่ง อย่างไรก็ตาม วิธีการของพวกเขากลับตอบคำถามที่แคบกว่าที่พาดหัวข่าวบางครั้งแนะนำ
Originality.ai: 999 จาก 1,000 การตอบกลับผ่านเกณฑ์
Originality.ai สร้างและสแกนการตอบกลับ Astra ภาษาอังกฤษ 1,000 รายการ: บล็อก 200 รายการ, บทสนทนา 200 รายการ, การตอบกลับเชิงอธิบาย 200 รายการ, การตอบกลับข่าว 200 รายการ และบทวิจารณ์ 200 รายการ โดยนับคะแนนอย่างน้อย 0.50 ในโหมด AI Allowance 15% ว่าถูกตรวจพบ
ตัวอย่างบล็อก, การอธิบาย, ข่าว และบทวิจารณ์ทั้งหมดผ่านเกณฑ์นั้น หมวดหมู่บทสนทนาให้ผลการตรวจจับ 199 รายการจาก 200 รายการ ทำให้ได้ผลรวม 999 รายการจาก 1,000 รายการ ผลลัพธ์เดียวที่ต่ำกว่าเกณฑ์คือการเขียนเชิงสนทนา
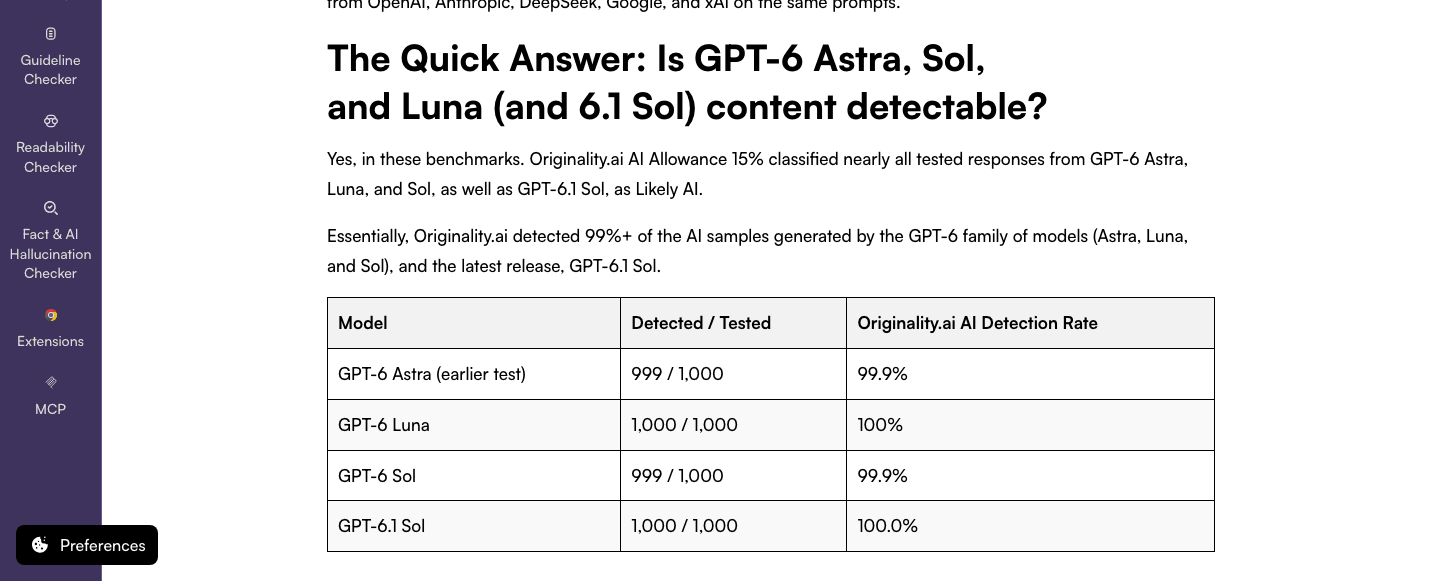
นี่เป็นผลการตรวจจับ AI ที่รู้จักที่แข็งแกร่งสำหรับเครื่องมือตรวจจับและการตั้งค่านั้น ไม่ใช่การศึกษาความแม่นยำเต็มรูปแบบเนื่องจากไม่มีชุดการเขียนของมนุษย์ที่ตรงกัน หากไม่มีข้อมูลเชิงลบจากมนุษย์ การศึกษาไม่สามารถแสดงให้เห็นว่าเครื่องมือตรวจจับเดียวกันอาจระบุบุคคลบ่อยแค่ไหน
Pangram: ผลลัพธ์สี่รายการไม่ถูกจัดประเภทเป็น AI ทั้งหมด
Pangram เริ่มต้นด้วยการตอบกลับ Astra 1,032 รายการจากพรอมต์ Chatbot Arena รอบแรกที่ถูกกรอง ไม่ได้ให้คะแนนการตอบกลับ 46 รายการที่มีน้อยกว่า 50 คำ ทำให้เหลือข้อความที่เข้าเกณฑ์ 986 รายการ
ในจำนวนนั้น 982 รายการถูกจัดประเภทเป็น AI, สามรายการเป็นแบบผสม และหนึ่งรายการเป็นของมนุษย์ ผลลัพธ์ที่ไม่ใช่ AI รวมถึงรูปแบบสั้นๆ หรือสร้างสรรค์ เช่น อีเมล คำอธิบาย และบทกวี รายละเอียดนั้นสำคัญเพราะการพลาดไม่ได้กระจายอย่างสม่ำเสมอในชุดเรียงความยาวที่เหมือนกัน
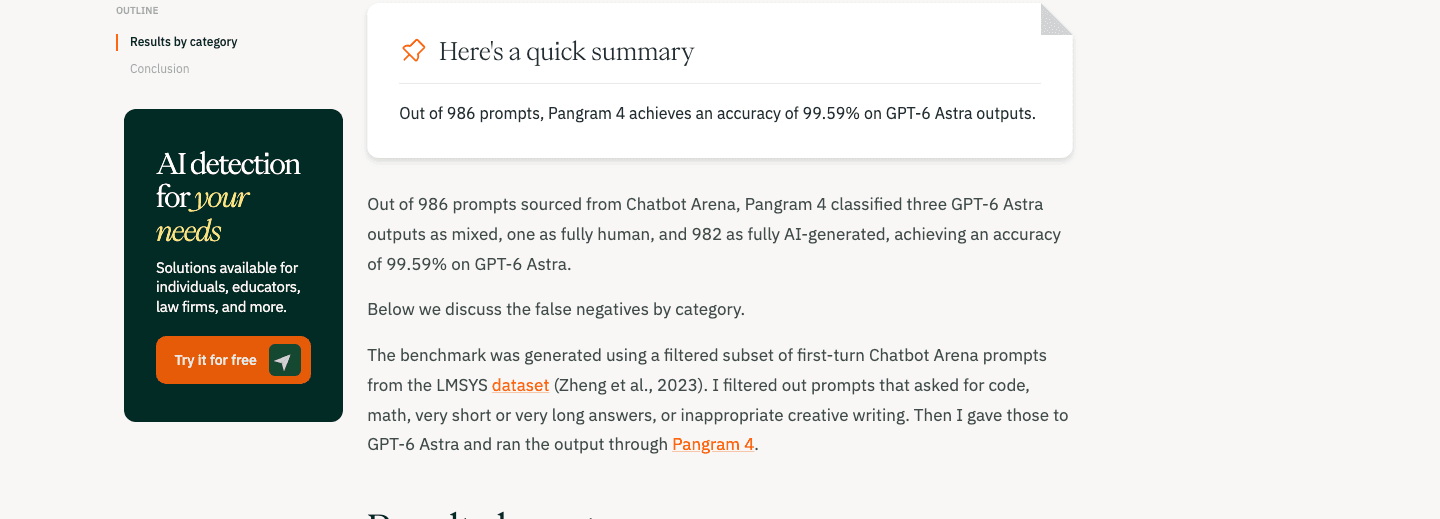
การศึกษานี้สนับสนุนอัตราการตรวจจับที่สูงสำหรับข้อความ Astra ที่ตรงตามข้อกำหนดความยาวของ Pangram ไม่ได้บอกเราว่าคำตอบสั้นๆ ที่ถูกยกเว้นจะได้รับคะแนนเท่าใด และอีกครั้งที่ไม่มีกลุ่มควบคุมของมนุษย์สำหรับการประมาณค่าการแจ้งเตือนที่ผิดพลาด
เครื่องมือตรวจจับห้าตัวเห็นด้วยกับเรียงความ Astra หนึ่งฉบับ
การศึกษาขนาดเล็กกว่าได้นำเรียงความ Astra ขนาด 300 คำหนึ่งฉบับมาสแกนด้วย Phrasly, GPTZero, Pangram, Copyleaks และ QuillBot เครื่องมือทุกตัวระบุว่าเรียงความนั้นมี AI สี่ตัวแสดงคะแนน AI สูงสุดที่แสดง ในขณะที่ QuillBot แสดง 82% AI
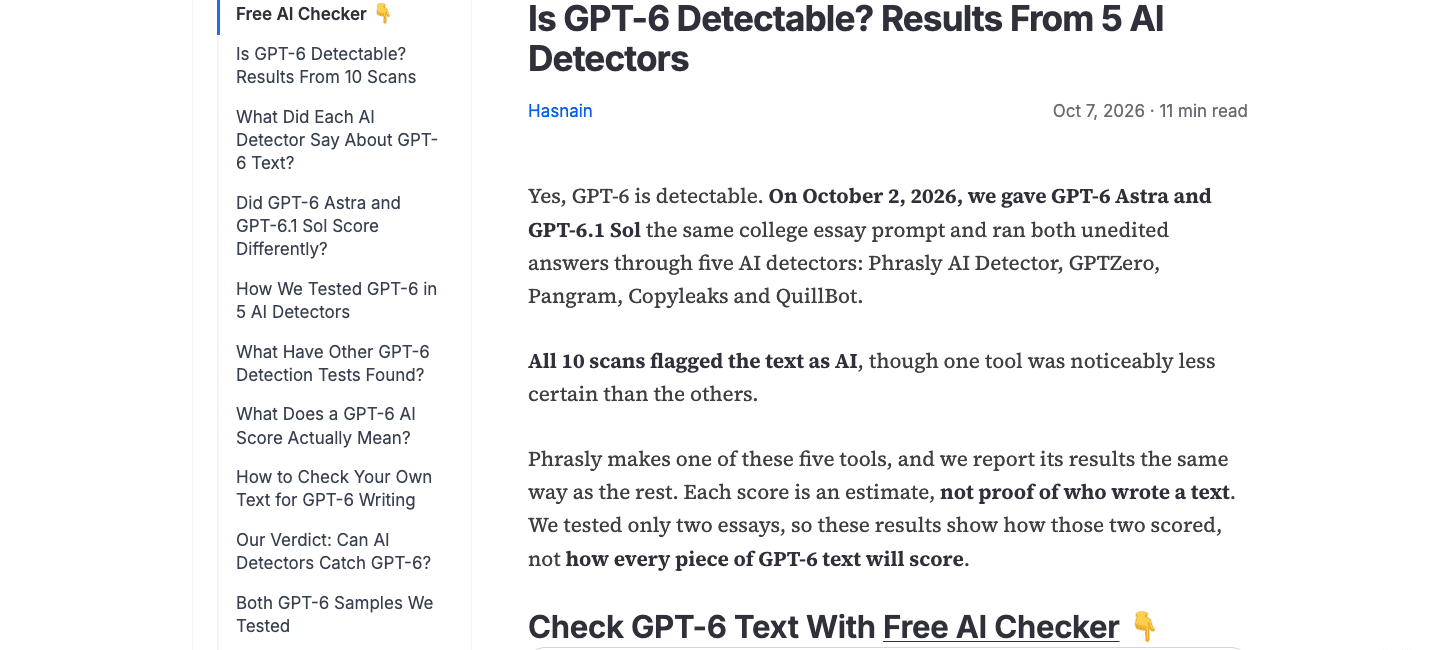
การเปรียบเทียบนั้นมีประโยชน์เพราะมันคงข้อความไว้คงที่ในขณะที่เปลี่ยนเครื่องมือตรวจจับ มันแสดงให้เห็นว่าการเห็นพ้องต้องกันระหว่างเครื่องมือเป็นไปได้ แต่ก็แสดงให้เห็นว่าเปอร์เซ็นต์ของพวกมันไม่สามารถใช้แทนกันได้ คะแนน 82% และคะแนนสูงสุดสามารถนำไปสู่ป้ายกำกับเชิงปฏิบัติเดียวกันได้ ในขณะที่มาจากโมเดลและมาตราส่วนที่แตกต่างกัน
เรียงความหนึ่งฉบับไม่สามารถยืนยันประสิทธิภาพของเครื่องมือตรวจจับห้าตัวในบล็อก อีเมล รายงานทางเทคนิค และฉบับร่างที่แก้ไขแล้วได้ มันเป็นภาพรวมของการทำงานร่วมกันของเครื่องมือ ไม่ใช่การจัดอันดับ
ข้อความเดียวกันตรวจจับได้ยากขึ้นเมื่อถูกย่อให้สั้นลง
ผลลัพธ์ที่เปิดเผยมากที่สุดอาจมาจากการศึกษาที่เล็กที่สุด นักวิจัยนำข้อความ Astra ที่รู้จัก 40 ส่วน และแสดงให้เครื่องมือตรวจจับเดียวกันเห็น 25, 50, 100 หรือ 200 คำแรกของแต่ละส่วน มีเพียงปริมาณข้อความที่มองเห็นได้เท่านั้นที่เปลี่ยนแปลงไป
ที่ 25 คำ ตรวจพบ 9 จาก 40 ส่วน ที่ 50 คำ ตรวจพบ 29 จาก 40 ส่วน ที่ 100 และ 200 คำ ตรวจพบทั้งหมด 40 ส่วน
สิ่งนี้ไม่ได้สร้างกฎ 100 คำที่เป็นสากล แต่มันแสดงให้เห็นว่าทำไมการตรวจสอบประโยคที่แยกออกมาจึงอาจทำให้เกิดความมั่นใจที่ผิดพลาดได้: อาจมีภาษาไม่เพียงพอสำหรับเครื่องมือตรวจจับที่จะหารูปแบบที่เสถียร
การวิเคราะห์ซ้ำของเรา: การตรวจจับ 99.9% ไม่ใช่ความแม่นยำ 99.9% ในโลกแห่งความเป็นจริง
จำนวนที่เผยแพร่ช่วยให้สามารถคำนวณอิสระที่เป็นประโยชน์ได้ ผลลัพธ์ตัวอย่างเป็นการประมาณค่า ดังนั้นเราจึงคำนวณช่วงความเชื่อมั่น Wilson 95% โดยประมาณใหม่ แทนที่จะถือว่าแต่ละเปอร์เซ็นต์เป็นค่าที่แน่นอน
| จำนวนที่เผยแพร่ | อัตราที่สังเกตได้ | ช่วง 95% โดยประมาณ | การตีความอย่างระมัดระวัง |
|---|---|---|---|
| Originality.ai: 999/1,000 | 99.90% | 99.44%-99.98% | อัตราการตรวจจับสูงสำหรับตัวอย่าง Astra ที่รู้จักภายใต้การตั้งค่าที่รายงาน |
| Originality.ai เชิงสนทนา: 199/200 | 99.50% | 97.22%-99.91% | ผลลัพธ์ที่แข็งแกร่ง แต่มีความแม่นยำน้อยกว่าเนื่องจากตัวอย่างหมวดหมู่มีขนาดเล็กกว่า |
| Pangram AI เต็มรูปแบบ: 982/986 | 99.59% | 98.96%-99.84% | อัตราการจำแนกประเภท AI เต็มรูปแบบสูงในบรรดาผลลัพธ์ที่ให้คะแนนที่เข้าเกณฑ์ |
ช่วงเหล่านี้ตอกย้ำข้อสรุปว่าอัตราการตรวจจับ AI ที่รู้จักที่รายงานนั้นสูง แต่ไม่ได้เติมเต็มส่วนที่ขาดหายไปของการทดลอง
ในการวัดประสิทธิภาพของเครื่องมือตรวจจับในโลกแห่งความเป็นจริง เราจำเป็นต้องมีทั้งเอกสาร AI และเอกสารที่มนุษย์เขียน นั่นเป็นวิธีเดียวที่จะดูว่าเครื่องมือสามารถตรวจจับ AI ได้หรือไม่ โดยไม่กล่าวหาผู้คนมากเกินไป
| ตัวชี้วัด | การศึกษาเฉพาะ Astra สามารถคำนวณได้หรือไม่? | ทำไมจึงสำคัญ |
|---|---|---|
| อัตราการตรวจจับข้อความ AI ที่รู้จัก | ใช่ | แสดงให้เห็นว่าเครื่องมือตรวจจับตัวอย่าง AI ที่ได้รับบ่อยแค่ไหน |
| อัตราการแจ้งเตือนที่ผิดพลาดเชิงลบ | ใช่ | แสดงให้เห็นว่าตัวอย่าง AI ที่รู้จักถูกพลาดไปกี่รายการภายใต้กฎการทดสอบ |
| ความจำเพาะ | ไม่ | ต้องใช้ข้อความของมนุษย์เพื่อวัดว่างานของมนุษย์ถูกระบุว่าถูกต้องบ่อยแค่ไหน |
| อัตราการแจ้งเตือนที่ผิดพลาดเชิงบวก | ไม่ | ต้องใช้ข้อความของมนุษย์เพื่อนับว่าผู้คนถูกระบุผิดบ่อยแค่ไหน |
| ความแม่นยำ | ไม่ | ขึ้นอยู่กับทั้งการแจ้งเตือนที่ผิดพลาดเชิงบวกและความถี่ของข้อความ AI ในประชากรที่กำลังตรวจสอบ |
| ความแม่นยำโดยรวม | ไม่ | ต้องใช้ทั้งตัวอย่างเชิงบวกและเชิงลบ รวมถึงความสมดุลของคลาสที่กำหนด |
การเรียก 999 จาก 1,000 ว่า "ความแม่นยำ 99.9%" นั้นแฝงด้วยสมมติฐานว่าความผิดพลาดเดียวที่เป็นไปได้คือการพลาด AI ในห้องเรียน ห้องข่าว หรือขั้นตอนการจ้างงาน การระบุว่ามนุษย์เป็น AI โดยผิดพลาดนั้นเป็นความผิดพลาดที่แตกต่างกันและมักจะมีผลกระทบมากกว่า การทดสอบเฉพาะ Astra ไม่ได้ออกแบบมาเพื่อวัดสิ่งนี้
ทำไมข้อความ GPT-6 Astra เดียวกันจึงได้คะแนนต่างกัน
ผลลัพธ์ของเครื่องมือตรวจจับมีความอ่อนไหวต่อเอกสารที่อยู่ตรงหน้า ชื่อโมเดลเพียงอย่างเดียวไม่สามารถคาดการณ์คะแนนสุดท้ายได้
ความยาวของข้อความเปลี่ยนสัญญาณที่มีอยู่ อีเมล 20 คำและรายงาน 1,000 คำอาจมาจากโมเดลเดียวกัน แต่ให้หลักฐานที่แตกต่างกันมาก คะแนนต่ำในข้อความสั้นๆ ควรได้รับการตีความอย่างระมัดระวังเป็นพิเศษ
ประเภทงานเขียนเปลี่ยนรูปแบบภาษา ในการทดสอบของ Originality.ai การเขียนเชิงสนทนามีข้อผิดพลาดเพียงอย่างเดียว การจำแนกประเภทที่ไม่ใช่ AI เต็มรูปแบบของ Pangram รวมถึงรูปแบบต่างๆ เช่น บทกวี อีเมล และคำอธิบายสั้นๆ เครื่องมือตรวจจับที่ปรับเทียบกับเรียงความอาจทำงานแตกต่างกันในการสนทนาหรือร้อยแก้วเชิงสร้างสรรค์
พรอมต์กำหนดผลลัพธ์ Astra สามารถปฏิบัติตามข้อจำกัดโดยละเอียดเกี่ยวกับน้ำเสียง โครงสร้าง กลุ่มเป้าหมาย และตัวอย่าง ผู้ใช้สองคนที่ใช้โมเดลเดียวกันสามารถได้รับข้อความที่มีจังหวะและความเฉพาะเจาะจงที่แตกต่างกันมาก
เวอร์ชันและเกณฑ์ของเครื่องมือตรวจจับแตกต่างกัน เครื่องมือแต่ละตัวกำหนดป้ายกำกับ ข้อมูลการฝึกอบรม ความยาวขั้นต่ำ และเกณฑ์การตัดสินใจของตนเอง เปอร์เซ็นต์จากบริการหนึ่งไม่ใช่คะแนนที่คุณสามารถเปรียบเทียบแบบจุดต่อจุดกับอีกบริการหนึ่งได้
การแก้ไขของมนุษย์เปลี่ยนข้อความที่กำลังตรวจสอบ การเพิ่มหลักฐานต้นฉบับ การจัดเรียงข้อโต้แย้งใหม่ การแก้ไขข้อเท็จจริง และการเขียนใหม่จากความรู้ส่วนตัวสามารถเปลี่ยนแปลงรูปแบบทางสถิติได้ นั่นไม่ได้ให้สูตรที่เชื่อถือได้สำหรับการหลีกเลี่ยงการตรวจจับ และไม่ได้ลบล้างความจำเป็นในการเปิดเผยการใช้ AI เมื่อนโยบายกำหนดไว้
เครื่องมือตรวจจับสามารถบอกได้หรือไม่ว่า GPT-6 Astra เป็นผู้เขียน?
ไม่ เครื่องมือตรวจจับข้อความทั่วไปไม่สามารถระบุโมเดลที่แน่นอนที่สร้างข้อความนั้นได้ ไม่มีเครื่องมือใดในห้าตัวในการเปรียบเทียบข้ามเครื่องมือตรวจจับที่ระบุชื่อ Astra พวกมันส่งคืนผลลัพธ์ที่เป็น AI, ผสม, มนุษย์ หรือคะแนนความน่าจะเป็น
| คำถาม | เครื่องมือตรวจจับข้อความสามารถตอบได้หรือไม่? |
|---|---|
| ข้อความนี้คล้ายกับรูปแบบที่เกี่ยวข้องกับการเขียนของ AI หรือไม่? | สามารถประมาณการได้ แต่มีความไม่แน่นอน |
| AI มีส่วนเกี่ยวข้องในกระบวนการเขียนหรือไม่? | ไม่น่าเชื่อถือจากข้อความสุดท้ายเพียงอย่างเดียว |
| GPT-6 Astra สร้างข้อความนี้โดยเฉพาะหรือไม่? | ไม่ คะแนนไม่ได้ระบุโมเดลที่แน่นอน |
| ใครเป็นผู้ป้อนพรอมต์หรือแก้ไขผลลัพธ์? | ไม่ ประวัตินั้นอยู่นอกเหนือข้อความ |
| เอกสารนี้ละเมิดนโยบายของโรงเรียนหรือที่ทำงานหรือไม่? | ไม่ สิ่งนั้นต้องอาศัยนโยบาย บริบท และการตัดสินใจของมนุษย์ |
ดังนั้น ถ้อยคำที่สามารถป้องกันได้มากที่สุดคือ "ข้อความถูกระบุว่าคล้าย AI" ไม่ใช่ "เครื่องมือตรวจจับพิสูจน์แล้วว่านี่เขียนโดย GPT-6 Astra"
วิธีตรวจสอบข้อความ GPT-6 Astra ด้วย Lynote
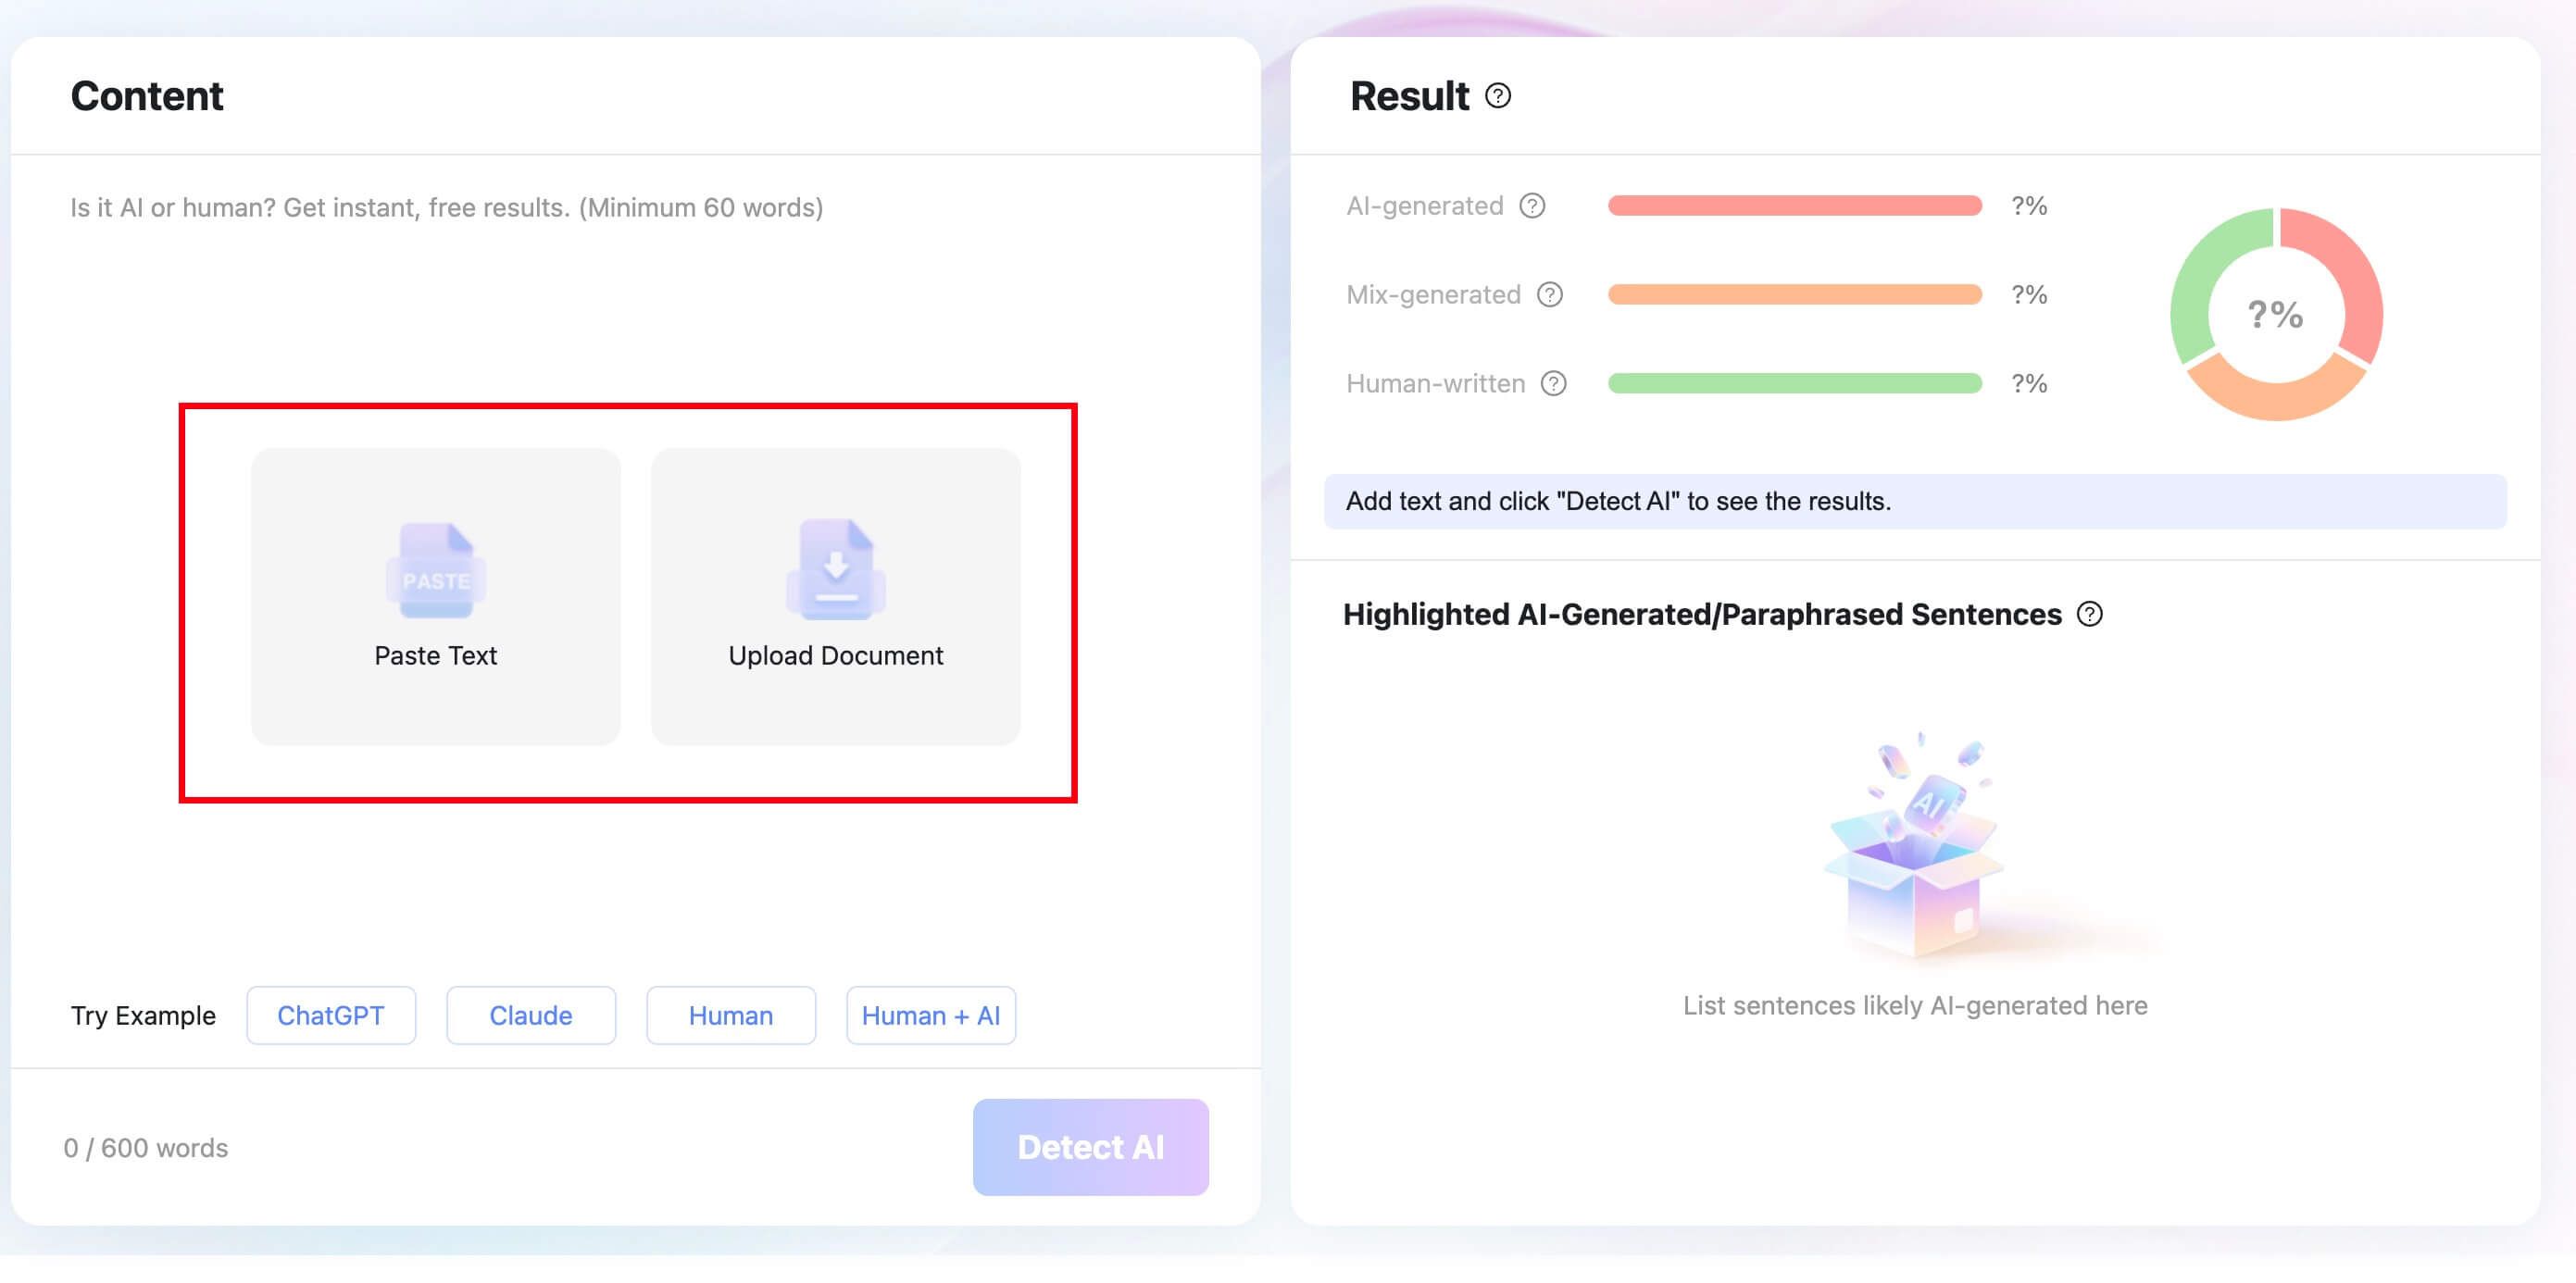
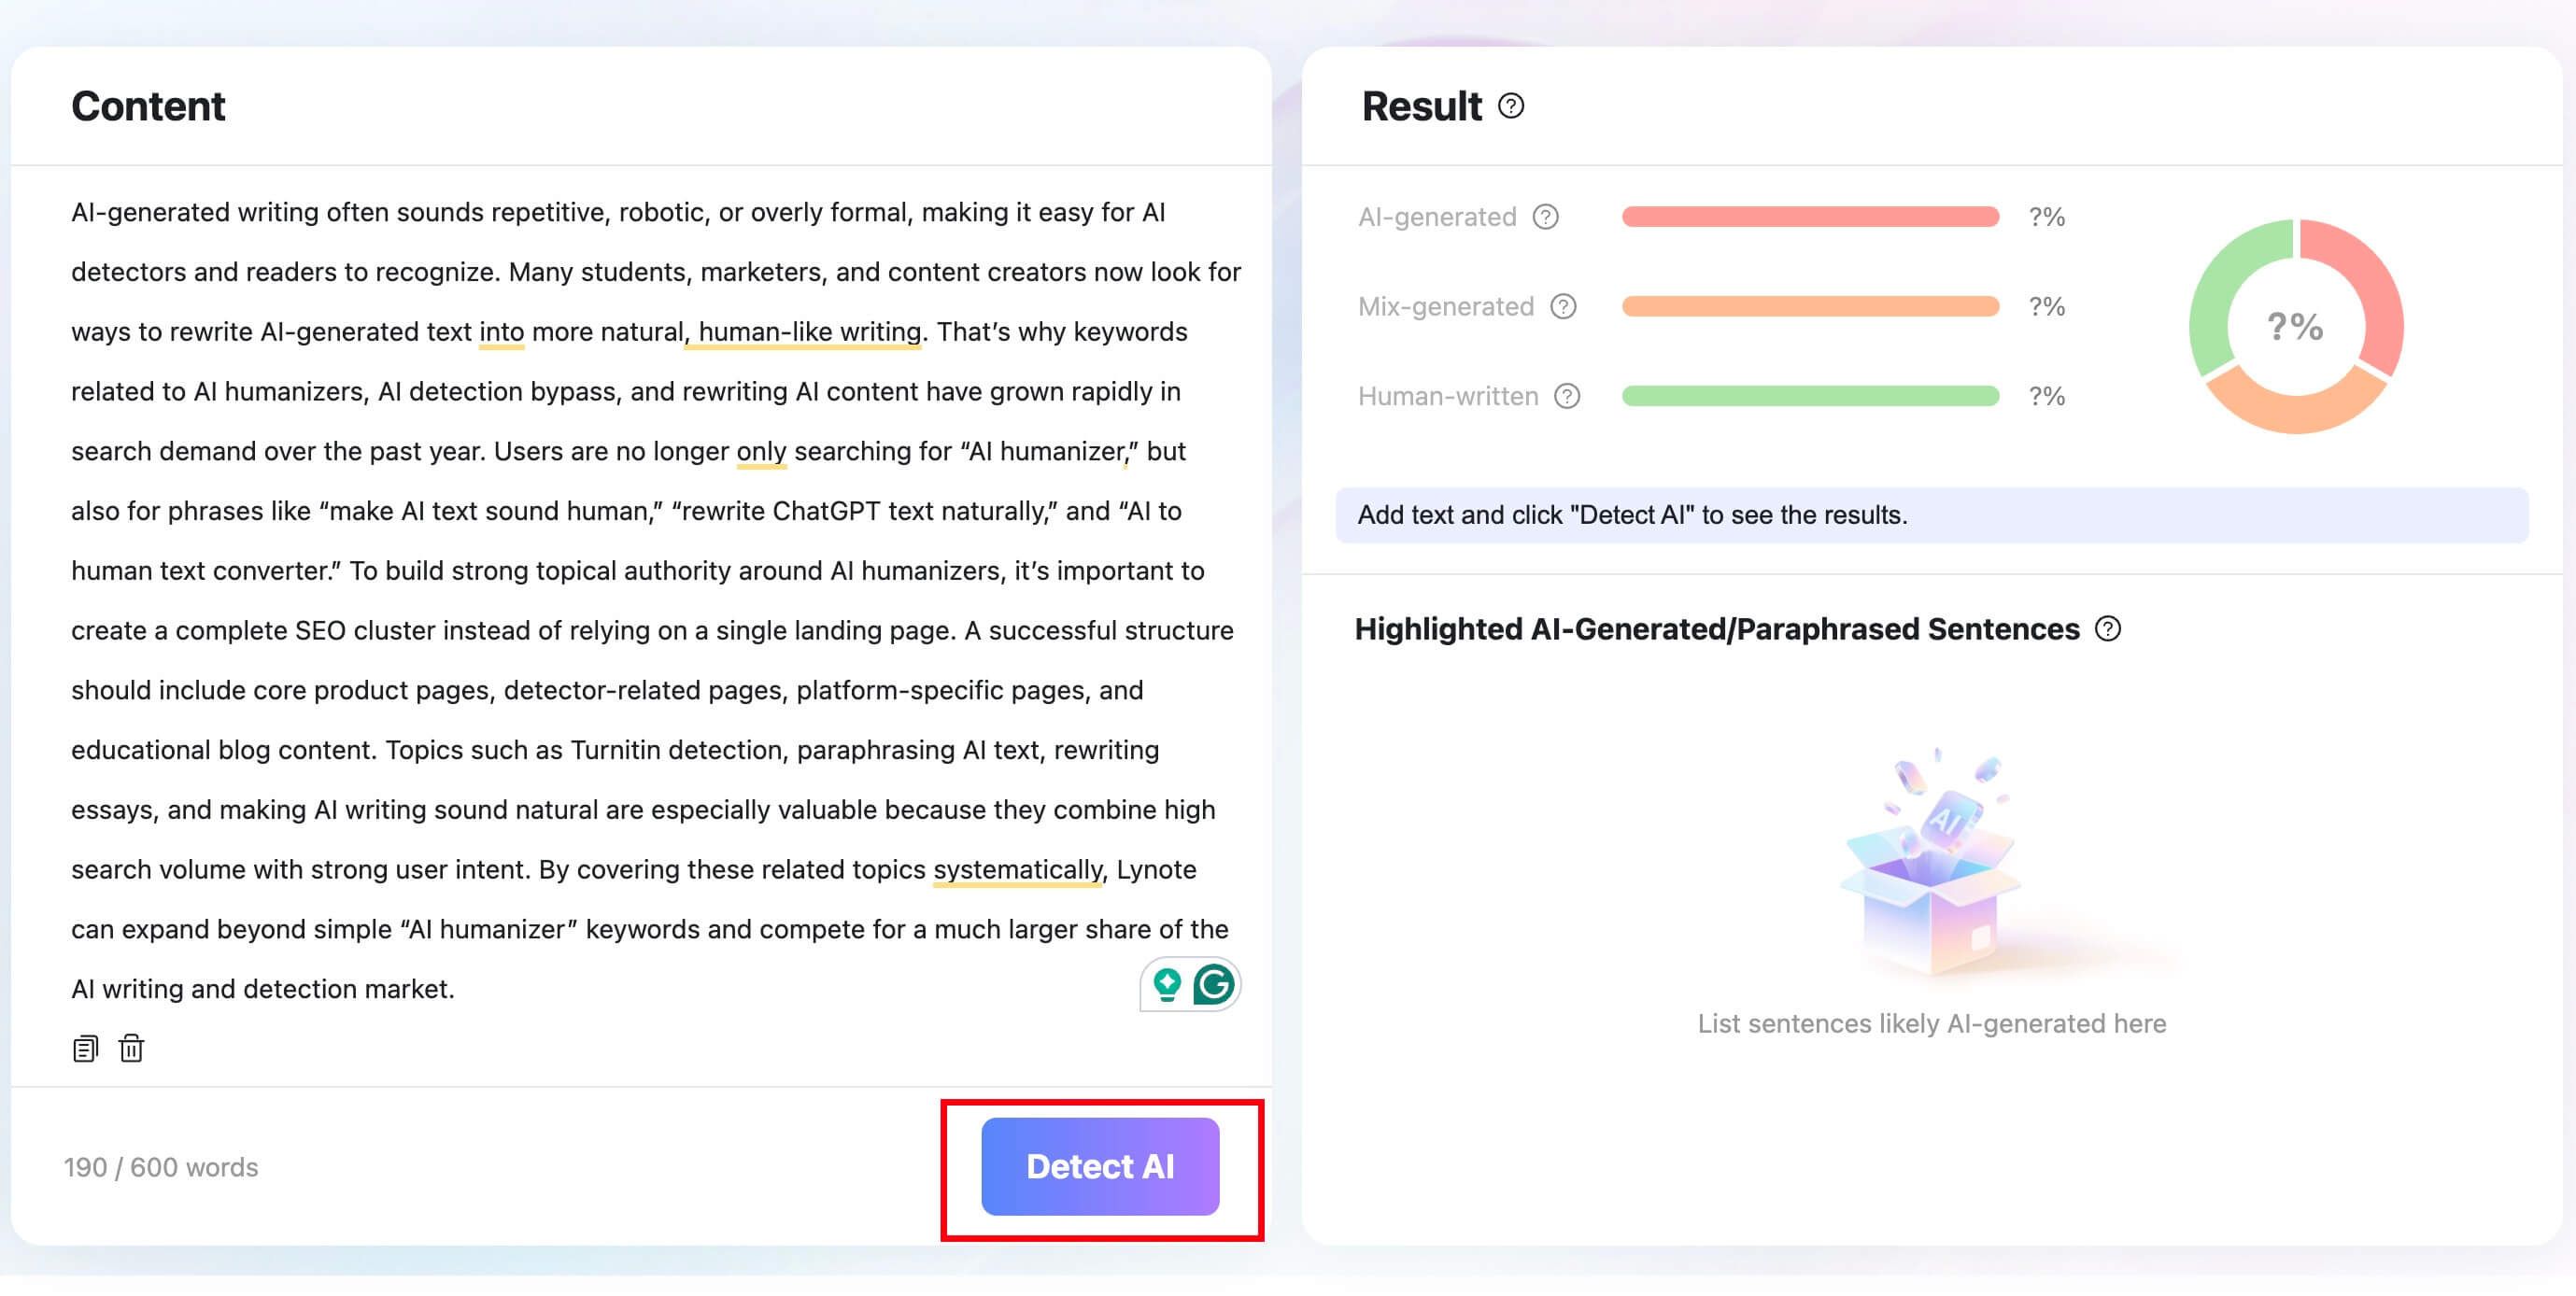
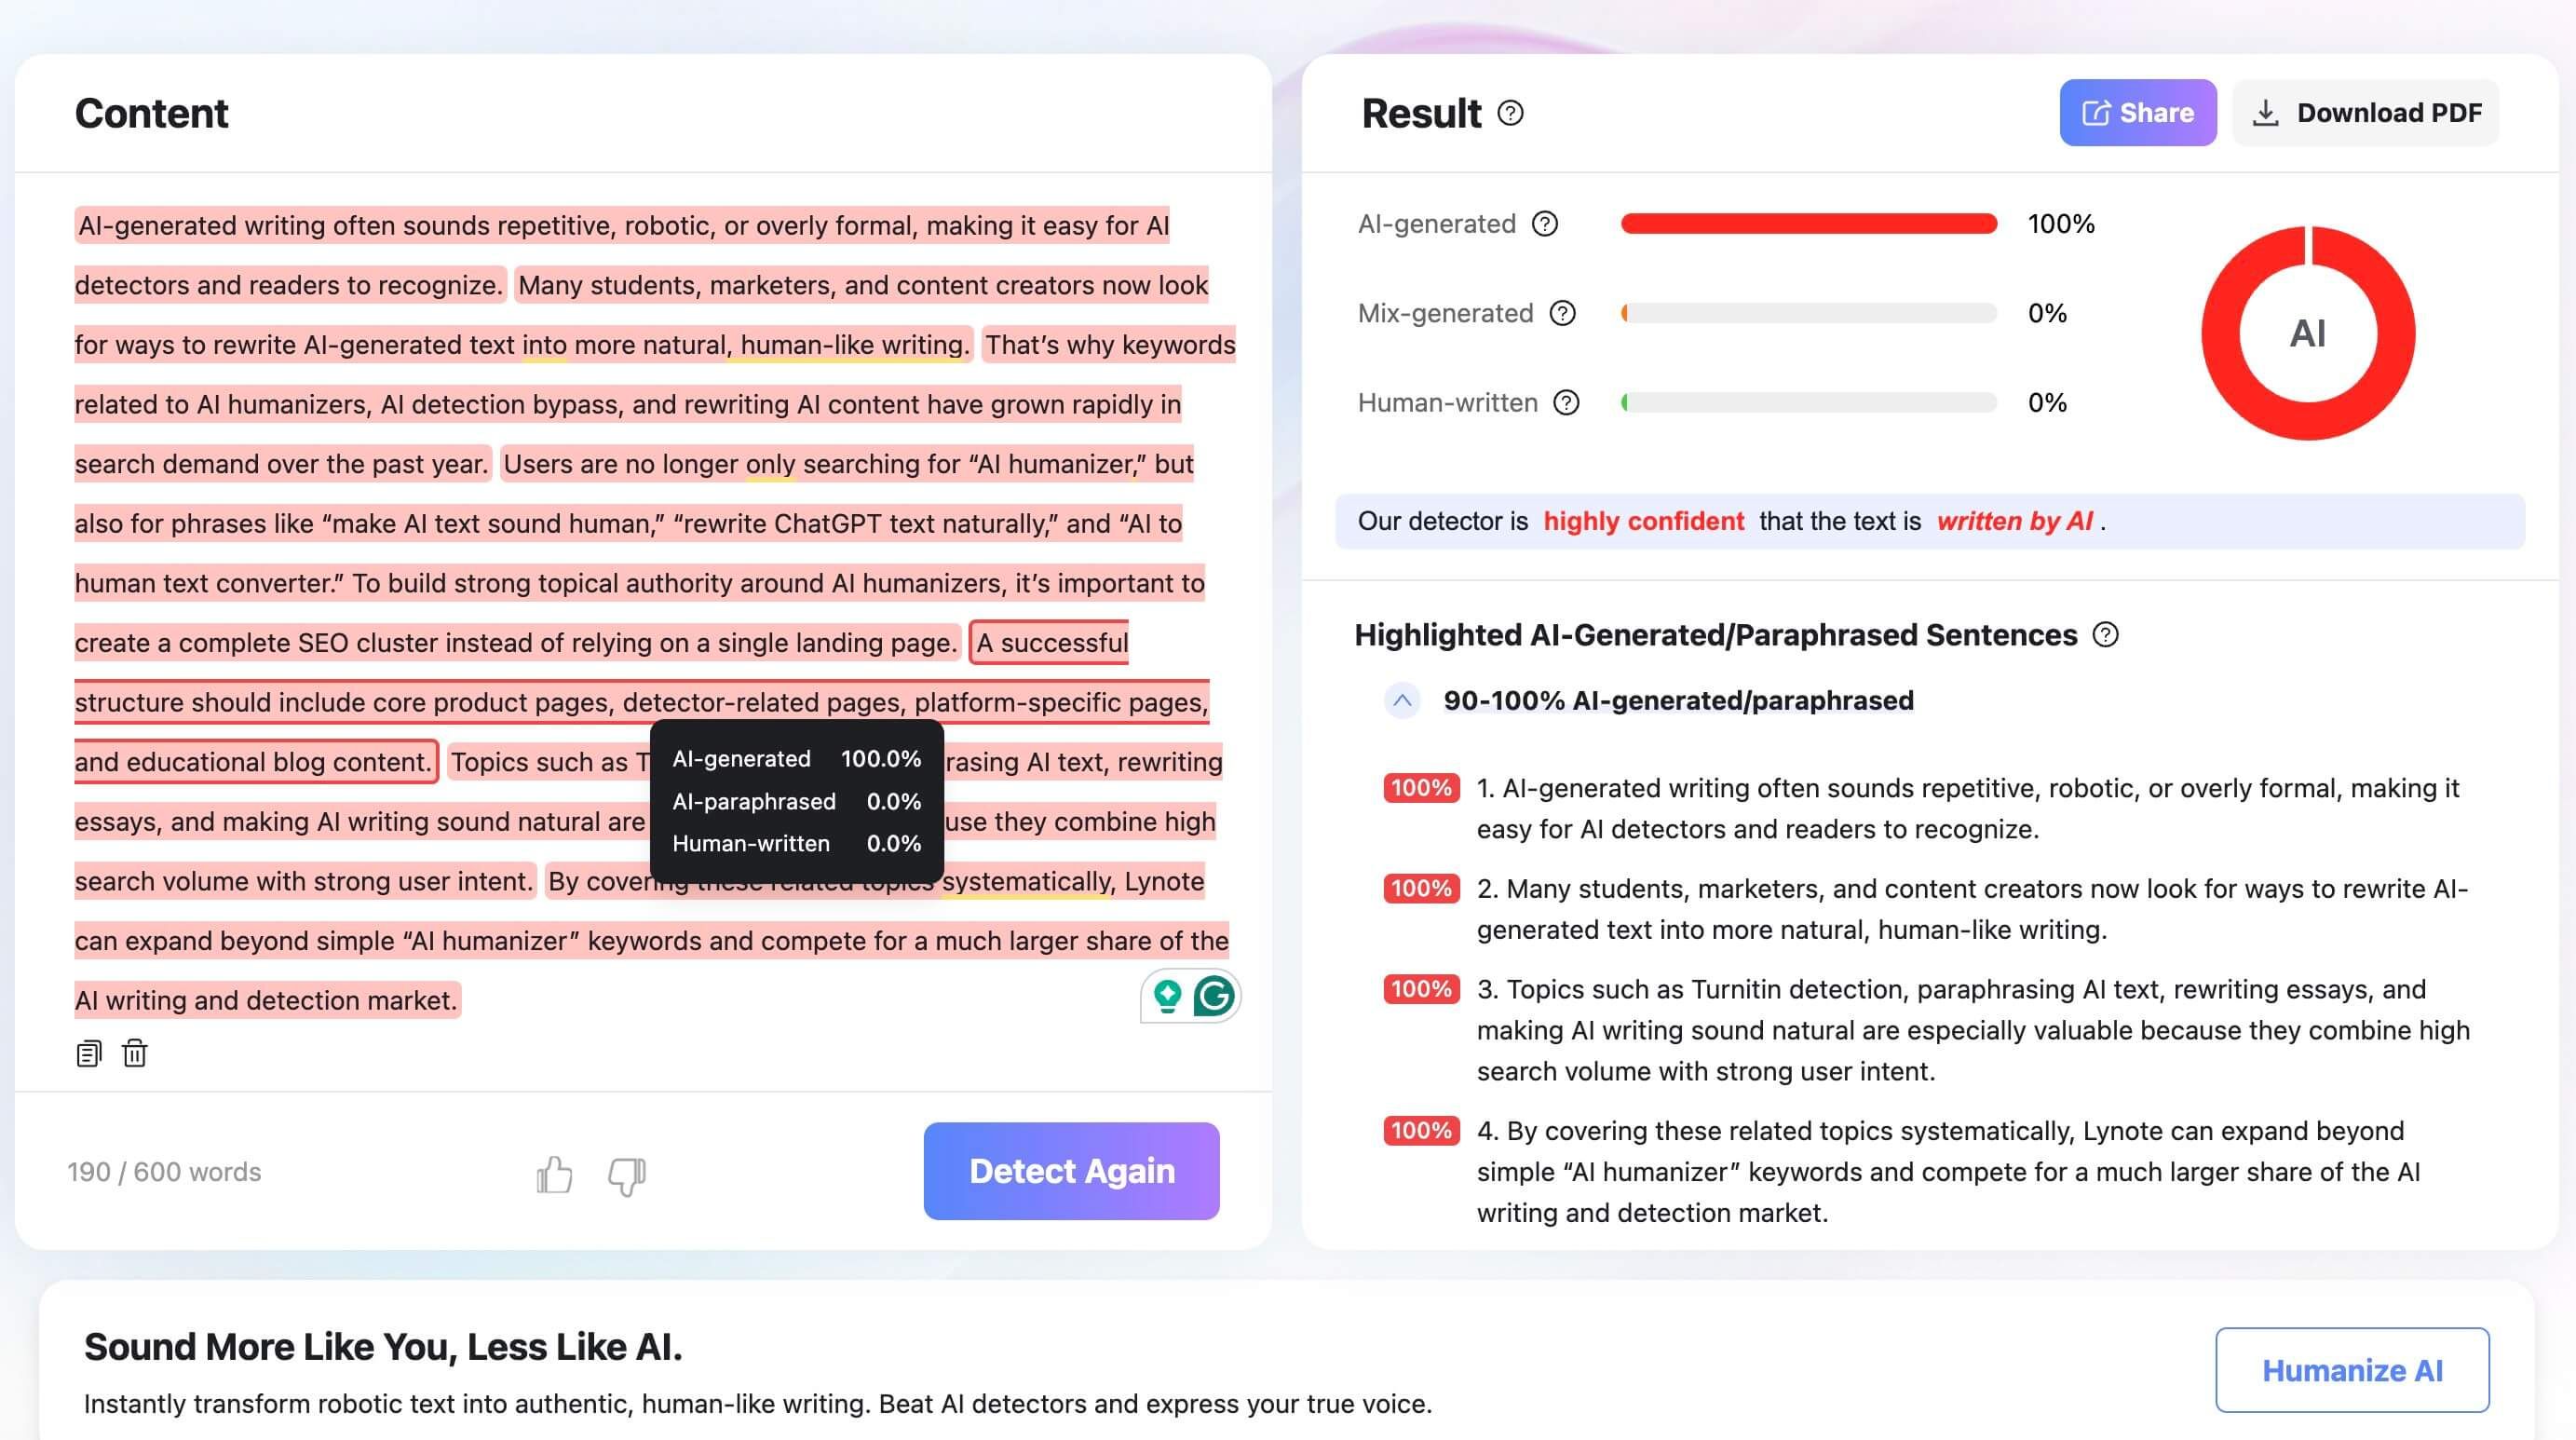
หากคุณต้องการตรวจสอบฉบับร่างที่สมบูรณ์แทนที่จะคาดเดาจากไม่กี่ประโยค Lynote AI Detector มีขั้นตอนการทำงานเบื้องต้นที่เรียบง่าย โดยจะแยกผลลัพธ์ออกเป็นเปอร์เซ็นต์ที่สร้างโดย AI, แบบผสม และที่มนุษย์เขียน และเน้นประโยคสำหรับการตรวจสอบอย่างละเอียด
-
วางข้อความหรืออัปโหลดเอกสาร ใช้กล่องข้อความสำหรับการตรวจสอบอย่างรวดเร็ว หรืออัปโหลดไฟล์ DOCX, PDF หรือ TXT ที่รองรับ ส่งส่วนที่มีความหมายแทนที่จะเป็นบรรทัดที่แยกออกมาเมื่อเป็นไปได้
-
เรียกใช้การสแกน คลิก Detect AI และให้เครื่องมือวิเคราะห์ข้อความที่ส่งมา
-
ตรวจสอบผลลัพธ์ทั้งหมด อ่านเปอร์เซ็นต์ AI, แบบผสม และมนุษย์ร่วมกัน จากนั้นตรวจสอบประโยคที่เน้นแทนที่จะตอบสนองต่อตัวเลขที่มากที่สุดเท่านั้น
-
เปรียบเทียบสัญญาณกับหลักฐานภายนอกเครื่องมือตรวจจับ ดูฉบับร่าง ประวัติเวอร์ชัน แหล่งที่มาที่อ้างอิง บันทึก และคำอธิบายของผู้เขียนก่อนที่จะสรุปผล
ผลลัพธ์สามารถบอกคุณได้ว่าจะดูที่ไหน ไม่สามารถบอกคุณได้ว่าใครเป็นผู้เขียนเอกสาร หรือว่าการใช้ AI ได้รับอนุญาตหรือไม่

วิธีตีความคะแนน AI ที่สูงหรือต่ำ
คะแนนจะมีประโยชน์ก็ต่อเมื่อมันเปลี่ยนสิ่งที่คุณจะตรวจสอบต่อไป
| หากคะแนนสูง | หากคะแนนต่ำ |
|---|---|
| อ่านข้อความที่เน้นในบริบท | อย่าถือว่าผลลัพธ์เป็นหลักฐานว่าบุคคลเป็นผู้เขียน |
| ตรวจสอบข้ออ้าง การอ้างอิง ตัวอย่าง และการเปลี่ยนแปลงน้ำเสียงที่ผิดปกติ | ตรวจสอบว่าข้อความสั้นเกินไปสำหรับผลลัพธ์ที่เสถียรหรือไม่ |
| เปรียบเทียบเอกสารกับฉบับร่างก่อนหน้าหรือประวัติเวอร์ชัน | โปรดจำไว้ว่าเครื่องมือตรวจจับอาจพลาดข้อความ AI และการอัปเดตโมเดลสามารถเปลี่ยนแปลงประสิทธิภาพได้ |
| ถามผู้เขียนเกี่ยวกับกระบวนการแทนที่จะนำเสนอคะแนนเป็นการตัดสิน | ใช้หลักฐานอื่นหากความเป็นผู้เขียนหรือการปฏิบัติตามนโยบายมีความสำคัญ |
| ขอให้มีการตรวจสอบโดยมนุษย์ครั้งที่สองสำหรับการตัดสินใจที่มีผลกระทบ | หลีกเลี่ยงการประกาศว่าเอกสาร "ได้รับการยืนยันว่าเป็นของมนุษย์" จากการสแกนเพียงครั้งเดียว |
สำหรับนักเขียนที่ตรวจสอบงานของตนเอง คะแนนที่สูงไม่ใช่คำสั่งให้ทำการแทนที่แบบสุ่มหรือเพิ่มข้อผิดพลาดโดยเจตนา การตอบสนองที่ดีกว่าคือการตรวจสอบทุกข้ออ้าง แทนที่คำที่ใช้ทั่วไปด้วยหลักฐานเฉพาะ และตรวจสอบให้แน่ใจว่าข้อโต้แย้งสุดท้ายสะท้อนถึงความเข้าใจของคุณเอง
สำหรับนักการศึกษาและบรรณาธิการ เครื่องมือตรวจจับควรเริ่มต้นการตรวจสอบ ไม่ใช่สิ้นสุด หลักฐานกระบวนการมักจะบอกคุณได้มากกว่าความน่าจะเป็นที่แนบมากับฉบับร่างสุดท้าย
ปัญหาการแจ้งเตือนที่ผิดพลาดเชิงบวกยังคงสำคัญ
อัตราการตรวจจับ AI ที่รู้จักสูงและการแจ้งเตือนที่ผิดพลาดเชิงบวกสามารถเกิดขึ้นพร้อมกันได้ เครื่องมือตรวจจับอาจจับตัวอย่าง Astra เกือบทุกตัวอย่างในการทดสอบหนึ่งครั้ง ในขณะที่ยังคงประสบปัญหาในการตรวจจับการเขียนของมนุษย์บางประเภท
นักวิจัยจากสแตนฟอร์ดเคยพบว่าเครื่องมือตรวจจับ GPT ที่ใช้กันอย่างแพร่หลายมักจะจำแนกการเขียนของนักเขียนที่ไม่ใช่เจ้าของภาษาอังกฤษผิดพลาด การศึกษาล่าสุดในปี 2026 ได้ตรวจสอบต้นฉบับที่มนุษย์เขียน 135,389 คู่ ก่อนและหลังการแก้ไขภาษาอังกฤษโดยมืออาชีพ ในบรรดาเครื่องมือตรวจจับ 13 ตัว อัตราการแจ้งเตือนที่ผิดพลาดเชิงบวกที่รายงานครอบคลุมช่วงที่เป็นไปได้ทั้งหมด และการเปลี่ยนแปลงการแก้ไขเดียวกันก็ผลักดันเครื่องมือตรวจจับที่แตกต่างกันไปในทิศทางตรงกันข้าม
นั่นไม่ได้หมายความว่าเครื่องมือตรวจจับทุกตัวไร้ประโยชน์ มันหมายความว่ารูปแบบสามารถกลายเป็นตัวแปรที่ทำให้สับสนได้: การใช้ถ้อยคำที่เป็นทางการ ไวยากรณ์ที่สอดคล้องกัน คำศัพท์ที่จำกัด หรือการแก้ไขโดยมืออาชีพอาจส่งผลต่อคะแนนแม้ว่าความเป็นผู้เขียนจะไม่ได้เปลี่ยนแปลงก็ตาม
คำแนะนำของ Turnitin เองก็สะท้อนถึงความไม่แน่นอนนี้ โดยอธิบายรายงาน AI ของตนว่าเป็นข้อมูลจุดหนึ่งและระบุว่าไม่ได้มีวัตถุประสงค์เพื่อให้คำตอบที่ชัดเจนโดยลำพัง
นั่นเป็นคำแนะนำที่สมเหตุสมผลนอกเหนือจากการศึกษาด้วยเช่นกัน เกรด งาน การตัดสินใจตีพิมพ์ หรือข้อกล่าวหาไม่ควรขึ้นอยู่กับเปอร์เซ็นต์ที่ไม่ชัดเจนเพียงอย่างเดียว
คำถามที่พบบ่อยเกี่ยวกับการตรวจจับ AI ของ GPT-6 Astra
Turnitin สามารถตรวจจับ GPT-6 Astra ได้หรือไม่?
Turnitin อาจระบุข้อความที่สร้างโดยโมเดลภาษาใหม่ๆ เมื่อการเขียนตรงกับรูปแบบที่ระบบเชื่อมโยงกับ AI อย่างไรก็ตาม ไม่มีเกณฑ์มาตรฐาน Turnitin เฉพาะ Astra ที่เผยแพร่ต่อสาธารณะที่ตรวจสอบสำหรับบทความนี้ที่ระบุอัตราการตรวจจับ และ Turnitin กล่าวว่ารายงานของตนไม่ควรใช้เป็นคำตอบที่ชัดเจนด้วยตัวมันเอง
เครื่องมือตรวจจับ AI สามารถระบุ GPT-6 Astra ได้โดยเฉพาะหรือไม่?
ไม่ ผลลัพธ์ของเครื่องมือตรวจจับในปัจจุบันโดยทั่วไปจะประมาณการว่าข้อความดูเหมือนสร้างโดย AI, แบบผสม หรือคล้ายมนุษย์ พวกมันไม่สามารถระบุ Astra เป็นโมเดลที่แน่นอนได้อย่างน่าเชื่อถือ หรือเปิดเผยประวัติพรอมต์และการแก้ไข
การแก้ไขข้อความ GPT-6 Astra เปลี่ยนคะแนนหรือไม่?
เป็นไปได้ การแก้ไขของมนุษย์ที่มีความหมายจะเปลี่ยนถ้อยคำ โครงสร้าง หลักฐาน และน้ำเสียง ซึ่งอาจเปลี่ยนแปลงการประมาณรูปแบบของเครื่องมือตรวจจับ ทิศทางไม่สามารถคาดเดาได้ และการแก้ไขควรปรับปรุงความถูกต้องและคุณภาพการเขียนมากกว่าที่จะมุ่งเป้าไปที่การบิดเบือนคะแนน
เครื่องมือตรวจจับต้องการข้อความมากแค่ไหน?
ข้อกำหนดแตกต่างกันไปตามเครื่องมือ ในการทดลอง Astra หนึ่งครั้ง การตรวจจับข้อความเดียวกันเพิ่มขึ้นจาก 9 ใน 40 ที่ 25 คำ เป็น 29 ใน 40 ที่ 50 คำ และทั้งหมด 40 ที่ 100 คำ ผลลัพธ์นั้นเป็นของเครื่องมือตรวจจับหนึ่งตัว แต่มันแสดงให้เห็นว่าทำไมข้อความที่สมบูรณ์จึงให้ข้อมูลมากกว่าประโยคเดียว
คะแนน AI สูงสุดที่เป็นไปได้เป็นหลักฐานว่า Astra เป็นผู้เขียนข้อความหรือไม่?
ไม่ มันคือการจำแนกประเภทที่แข็งแกร่งที่สุดของเครื่องมือตรวจจับภายใต้โมเดลและมาตราส่วนของมันเอง ไม่ได้พิสูจน์ว่าใช้โมเดล AI ใด ใครใช้ หรือว่าบุคคลนั้นแก้ไขเอกสารอย่างมีนัยสำคัญหรือไม่
การเขียนของมนุษย์สามารถถูกระบุว่าเป็นเนื้อหา GPT-6 ได้หรือไม่?
การเขียนของมนุษย์สามารถได้รับคะแนนที่คล้าย AI โดยเฉพาะอย่างยิ่งเมื่อเครื่องมือตรวจจับตอบสนองต่อรูปแบบมากกว่าแหล่งกำเนิด การเขียนภาษาอังกฤษที่ไม่ใช่เจ้าของภาษา ร้อยแก้วเชิงวิชาการที่เป็นมาตรฐานสูง และข้อความที่ได้รับการแก้ไขโดยมืออาชีพสมควรได้รับการระมัดระวังเป็นพิเศษ เนื่องจากการวิจัยได้บันทึกการแจ้งเตือนที่ผิดพลาดเชิงบวกที่ไม่สอดคล้องกัน
คะแนนต่ำเป็นหลักฐานว่ามนุษย์เป็นผู้เขียนข้อความหรือไม่?
ไม่ คะแนนต่ำหมายความว่าเครื่องมือตรวจจับไม่พบหลักฐานที่เกี่ยวข้องกับ AI เพียงพอที่จะผ่านเกณฑ์ ข้อความสั้นๆ ประเภทงานเขียนที่ไม่ปกติ และผลลัพธ์ AI ที่ได้รับการแก้ไข ล้วนสามารถลดความมั่นใจในการตรวจจับได้
คำตัดสินสุดท้าย
GPT-6 Astra สามารถตรวจจับได้ในการทดสอบที่เผยแพร่ที่แข็งแกร่งที่สุดที่มีอยู่จนถึงปัจจุบัน Originality.ai ระบุผลลัพธ์ Astra ที่รู้จัก 999 จาก 1,000 รายการ, Pangram จัดประเภทผลลัพธ์ที่เข้าเกณฑ์ 982 จาก 986 รายการว่าเป็น AI ทั้งหมด และเครื่องมือตรวจจับห้าตัวที่แยกกันเห็นด้วยกับเรียงความ Astra ที่ไม่ได้รับการแก้ไขหนึ่งฉบับ
ผลลัพธ์เหล่านั้นสนับสนุนข้อสรุปที่แคบ: เครื่องมือตรวจจับในปัจจุบันมักจะสามารถจดจำร้อยแก้ว Astra ที่ไม่ได้รับการแก้ไขและมีความยาวได้ พวกมันไม่ได้แสดงให้เห็นว่าเครื่องมือตรวจจับทุกตัวมีความน่าเชื่อถือเท่ากัน ว่าข้อความสั้นๆ หรือข้อความที่แก้ไขแล้วจะทำงานในลักษณะเดียวกัน หรือว่าคะแนนพิสูจน์ความเป็นผู้เขียน
ใช้การตรวจจับ AI เป็นการคัดแยก ให้ข้อความแก่เครื่องมือให้เพียงพอ อ่านข้อความที่เน้น และจากนั้นตรวจสอบหลักฐานที่ตัวจำแนกไม่สามารถมองเห็นได้: ฉบับร่าง แหล่งที่มา บริบท ประวัติการเขียน และบุคคลเบื้องหลังงานนั้น
เขียนโดย Danny
ผู้จัดการฝ่ายการตลาดผลิตภัณฑ์
แดนนี่อธิบายว่าฟีเจอร์ของ Lynote เข้ากับเวิร์กโฟลว์จริงได้อย่างไร ตั้งแต่การทำงานประจำวันไปจนถึงกรณีการใช้งานการเขียนที่ใช้ประโยชน์จากผลิตภัณฑ์ ดูบทความทั้งหมด →