

Có, nội dung GPT-6 Astra có thể được phát hiện trong các thử nghiệm đã công bố hiện tại. Hai nghiên cứu lớn từ các nhà cung cấp đã gắn cờ hơn 99% các mẫu AI đã biết, chưa chỉnh sửa mà họ chấm điểm, và một so sánh nhỏ hơn cho thấy năm công cụ phát hiện khác nhau đều gắn cờ cùng một bài luận Astra. Đây là bằng chứng mạnh mẽ cho thấy đầu ra Astra đã được trau chuốt không tự động trở nên vô hình đối với các công cụ phát hiện AI.
Điều này không phải là bằng chứng cho thấy mọi công cụ phát hiện sẽ bắt được mọi đoạn văn Astra. Quan trọng hơn, một điểm số cao không thể cho bạn biết ai đã viết tài liệu, mô hình nào đã tạo ra nó, hay liệu một người có sử dụng AI hay không. Câu hỏi hữu ích không chỉ đơn giản là "AI có thể phát hiện GPT-6 Astra không?" mà là bằng chứng có sẵn thực sự đo lường điều gì, và điều gì vẫn chưa được giải quyết.
Câu trả lời nhanh: Nội dung GPT-6 Astra có thể phát hiện được không?
Đối với văn xuôi tiếng Anh chưa chỉnh sửa có độ dài hợp lý, câu trả lời thường là có. Các kết quả công khai mạnh nhất có sẵn vào tháng 10 năm 2026 đều chỉ ra cùng một hướng, mặc dù chúng đến từ các công ty phát hiện và sử dụng các mẫu, ngưỡng và quy tắc bao gồm khác nhau.
| Thử nghiệm đã công bố | Tài liệu Astra được thử nghiệm | Kết quả báo cáo | Điều nó thiết lập | Điều nó không thiết lập |
|---|---|---|---|---|
| Originality.ai | 1.000 phản hồi Astra đã biết trên năm danh mục viết | 999 vượt ngưỡng AI của nó | Tỷ lệ phát hiện rất cao đối với mẫu AI đã biết này trên một cài đặt công cụ phát hiện | Tỷ lệ dương tính giả hoặc hiệu suất trên văn bản do con người viết |
| Pangram | 986 phản hồi Astra được chấm điểm từ các lời nhắc đã lọc | 982 AI, 3 hỗn hợp, 1 con người | Tỷ lệ phân loại hoàn toàn là AI rất cao đối với các đoạn văn đủ điều kiện | Hiệu suất dưới mức tối thiểu 50 từ hoặc trên các kiểm soát của con người |
| So sánh năm công cụ phát hiện | Một bài luận Astra 300 từ | 5 trên 5 công cụ đã gắn cờ nó; bốn công cụ hiển thị điểm AI tối đa của chúng | Một số công cụ phát hiện đã đồng ý về bài luận cụ thể đó | Độ chính xác trên toàn mô hình từ một mẫu tài liệu |
| Thử nghiệm độ dài đoạn văn | 40 văn bản Astra được hiển thị ở bốn độ dài | 9/40 được phát hiện ở 25 từ, 29/40 ở 50, và 40/40 ở 100 và 200 | Độ dài có thể thay đổi đáng kể kết quả của một công cụ phát hiện | Một độ dài tối thiểu phổ quát cho mọi công cụ phát hiện |
Bài học thực tế rất đơn giản: một bài viết Astra hoàn chỉnh có nhiều khả năng tạo ra tín hiệu phát hiện có ý nghĩa hơn là một câu được sao chép từ đó. Ngay cả khi đó, "bị gắn cờ" có nghĩa là văn bản khớp với các mẫu mà công cụ phát hiện liên kết với AI. Nó không có nghĩa là công cụ đã khôi phục một nhãn GPT-6 ẩn.
GPT-6 Astra thay đổi điều gì – và điều gì không thay đổi
OpenAI định vị GPT-6 Astra là mô hình có khả năng nhất của họ cho các tác vụ đòi hỏi suy luận, nghiên cứu, mã hóa, sử dụng máy tính và tạo tài liệu. Nó được xây dựng để tuân theo các hướng dẫn chi tiết và duy trì công việc phức tạp, có thể tạo ra các bản nháp mạch lạc và hữu ích hơn so với câu trả lời chatbot rập khuôn.
Tài liệu của chính mô hình cũng lưu ý xu hướng định dạng chi tiết và các cụm từ lặp lại trừ khi người dùng chỉ định một phong cách viết khác. Quan sát đó giúp giải thích tại sao khả năng cải thiện và khả năng phát hiện có thể cùng tồn tại. Một tài liệu có thể chính xác, được tổ chức tốt và trôi chảy trong khi vẫn thể hiện các quy luật mà một bộ phân loại thống kê nhận thấy.
Đây là nơi mọi người thường mắc sai lầm. Văn xuôi tốt hơn không nhất thiết phải trông giống con người hơn đối với một công cụ phát hiện, bởi vì các công cụ phát hiện không chấm điểm văn xuôi về trí thông minh hay tính hữu ích. Chúng đang ước tính liệu các mẫu ngôn ngữ của nó có giống với tài liệu trong dữ liệu đào tạo AI và con người của chúng hay không.
Cũng không phải văn bản vụng về tự động được viết bởi AI. Con người cũng lặp lại các chuyển tiếp, sử dụng cấu trúc bài luận công thức và viết các câu chung chung. Một công cụ phát hiện đọc các mẫu, không phải ý định, quyền tác giả hay lịch sử đằng sau con trỏ.
Các thử nghiệm phát hiện GPT-6 Astra đã công bố tìm thấy gì
Các nghiên cứu tiêu đề trông nhất quán đáng kể. Tuy nhiên, các phương pháp của chúng trả lời các câu hỏi hẹp hơn so với những gì tiêu đề đôi khi gợi ý.
Originality.ai: 999 trên 1.000 phản hồi vượt ngưỡng
Originality.ai đã tạo và quét 1.000 phản hồi Astra tiếng Anh: 200 blog, 200 đoạn hội thoại, 200 phản hồi giải thích, 200 phản hồi tin tức và 200 đánh giá. Nó tính điểm ít nhất 0,50 trong chế độ AI Allowance 15% của mình là đã phát hiện.
Tất cả các mẫu blog, giải thích, tin tức và đánh giá đều vượt ngưỡng đó. Danh mục hội thoại trả về 199 phát hiện trên 200, tạo ra tổng cộng 999 trên 1.000. Kết quả duy nhất dưới ngưỡng là văn bản hội thoại.
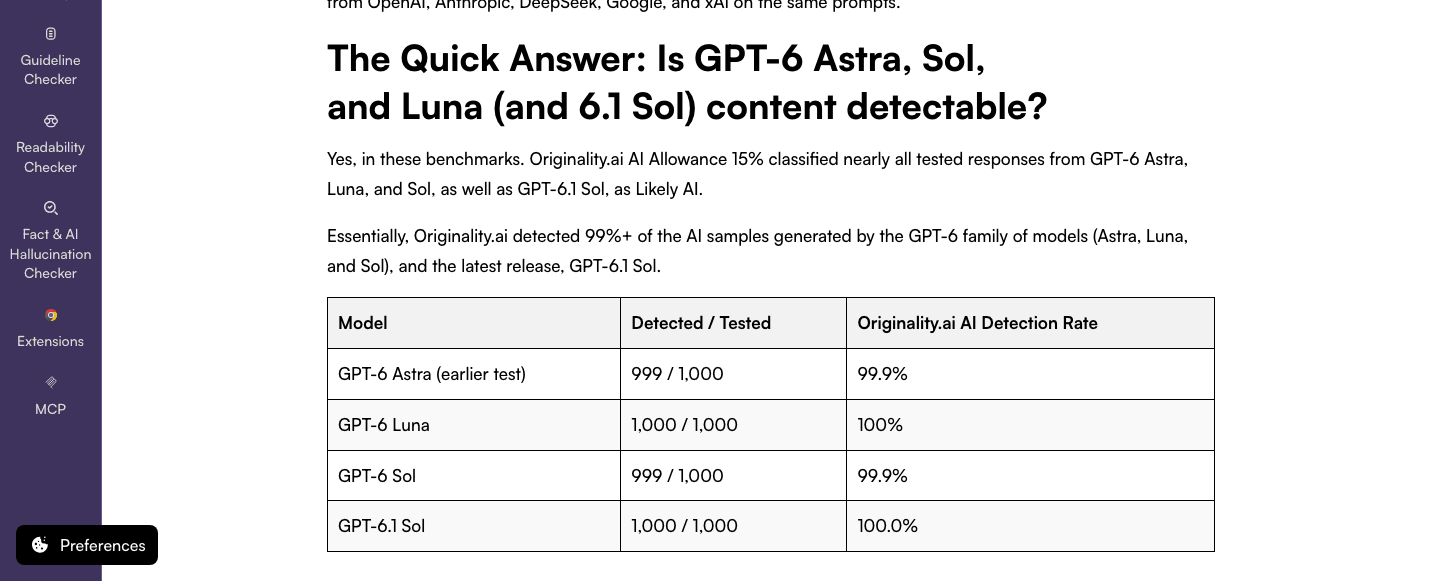
Đây là một kết quả phát hiện AI đã biết mạnh mẽ cho công cụ phát hiện và cài đặt đó. Đây không phải là một nghiên cứu độ chính xác đầy đủ vì không có bộ sưu tập văn bản do con người viết tương ứng. Nếu không có các trường hợp âm tính của con người, nghiên cứu không thể cho thấy tần suất cùng một công cụ phát hiện có thể gắn cờ một người.
Pangram: Bốn đầu ra không được phân loại hoàn toàn là AI
Pangram bắt đầu với 1.032 phản hồi Astra đối với các lời nhắc Chatbot Arena đã lọc ở lượt đầu tiên. Nó không chấm điểm 46 phản hồi có ít hơn 50 từ, để lại 986 đoạn văn đủ điều kiện.
Trong số đó, 982 được phân loại là AI, ba là hỗn hợp và một là con người. Các kết quả không phải AI bao gồm các định dạng ngắn hoặc sáng tạo như email, giải thích và một bài thơ. Chi tiết đó quan trọng vì các trường hợp bỏ sót không được phân bổ đều trên một bộ bài luận dài đồng nhất.
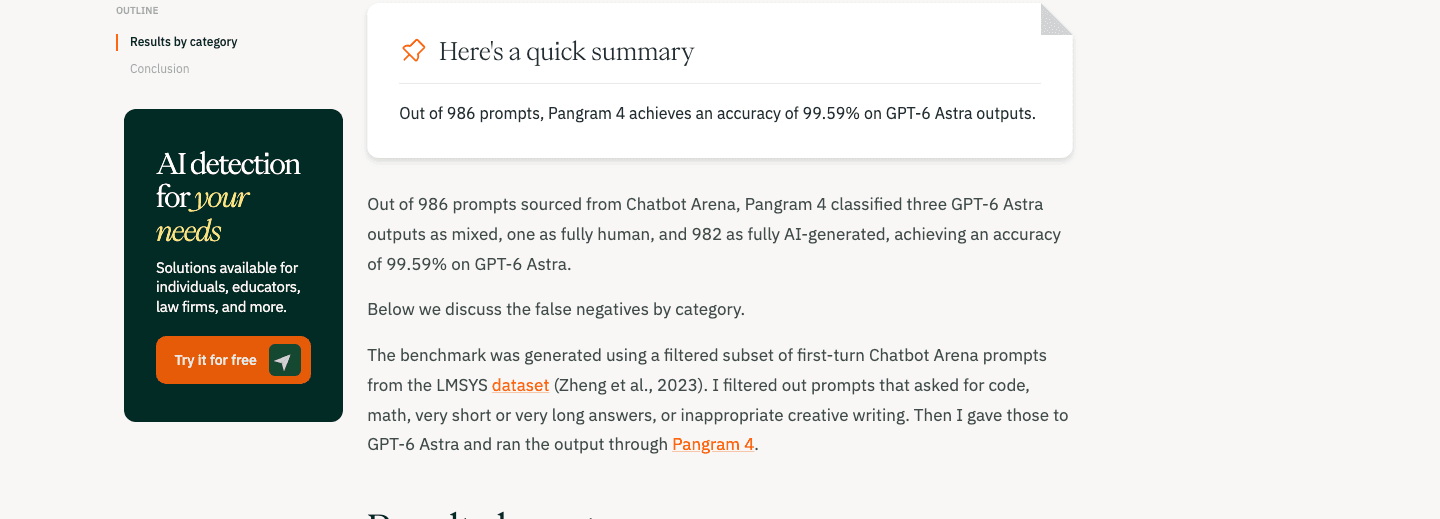
Nghiên cứu hỗ trợ tỷ lệ phát hiện cao đối với văn bản Astra đáp ứng yêu cầu độ dài của Pangram. Nó không cho chúng ta biết các câu trả lời ngắn bị loại trừ sẽ được chấm điểm như thế nào, và nó lại không chứa nhóm kiểm soát của con người để ước tính các trường hợp dương tính giả.
Năm công cụ phát hiện đồng ý về một bài luận Astra
Một nghiên cứu nhỏ hơn đã lấy một bài luận Astra dài 300 từ và quét nó bằng Phrasly, GPTZero, Pangram, Copyleaks và QuillBot. Mọi công cụ đều gắn cờ bài luận. Bốn công cụ trả về điểm AI tối đa được hiển thị của chúng, trong khi QuillBot trả về 82% AI.
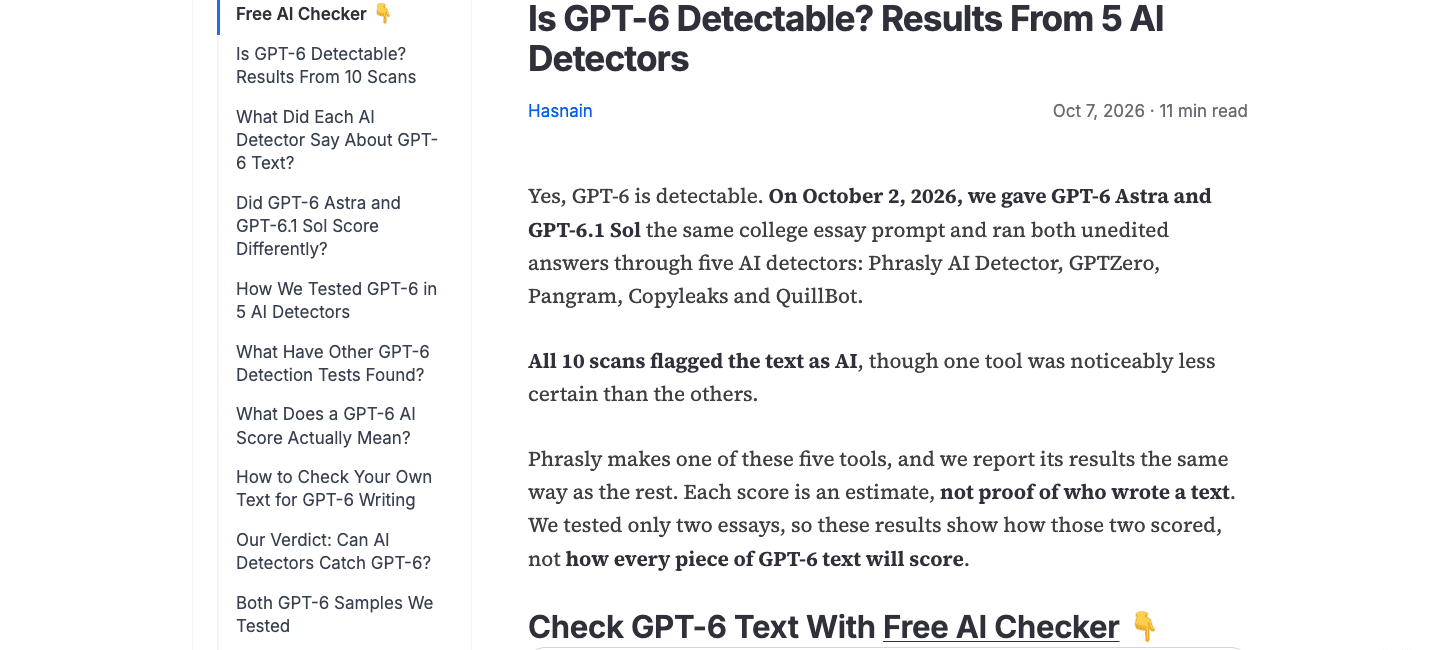
So sánh đó hữu ích vì nó giữ văn bản không đổi trong khi thay đổi công cụ phát hiện. Nó cho thấy rằng sự đồng thuận giữa các công cụ là có thể, nhưng nó cũng cho thấy rằng tỷ lệ phần trăm của chúng không thể hoán đổi cho nhau. Điểm 82% và điểm tối đa có thể dẫn đến cùng một nhãn thực tế trong khi đến từ các mô hình và thang đo khác nhau.
Một bài luận không thể thiết lập hiệu suất của năm công cụ phát hiện trên các blog, email, báo cáo kỹ thuật và bản nháp đã chỉnh sửa. Đó là một ảnh chụp nhanh đa công cụ, không phải là một bảng xếp hạng.
Cùng một văn bản trở nên khó phát hiện hơn khi nó được rút ngắn
Kết quả tiết lộ nhất có thể là nghiên cứu nhỏ nhất. Các nhà nghiên cứu đã lấy 40 đoạn văn Astra đã biết và cho cùng một công cụ phát hiện xem 25, 50, 100 hoặc 200 từ đầu tiên của mỗi đoạn văn. Chỉ có lượng văn bản hiển thị thay đổi.
Ở 25 từ, 9 trên 40 đoạn văn được phát hiện. Ở 50 từ, 29 trên 40 được phát hiện. Ở cả 100 và 200 từ, tất cả 40 đều vượt ngưỡng.
Điều này không thiết lập một quy tắc 100 từ phổ quát. Nó cho thấy tại sao việc kiểm tra một câu riêng lẻ có thể tạo ra sự trấn an sai lầm: có thể không có đủ ngôn ngữ để công cụ phát hiện tìm thấy một mẫu ổn định.
Phân tích lại của chúng tôi: Phát hiện 99,9% không phải là độ chính xác 99,9% trong thế giới thực
Các số liệu đã công bố cho phép một phép tính độc lập hữu ích. Một kết quả mẫu là một ước tính, vì vậy chúng tôi đã tính toán lại khoảng tin cậy Wilson 95% gần đúng thay vì coi mỗi tỷ lệ phần trăm là chính xác.
| Số liệu đã công bố | Tỷ lệ quan sát | Khoảng 95% gần đúng | Giải thích cẩn thận |
|---|---|---|---|
| Originality.ai: 999/1.000 | 99,90% | 99,44%-99,98% | Tỷ lệ phát hiện cao trên các mẫu Astra đã biết theo cài đặt được báo cáo |
| Originality.ai hội thoại: 199/200 | 99,50% | 97,22%-99,91% | Kết quả mạnh mẽ, nhưng kém chính xác hơn vì mẫu danh mục nhỏ hơn |
| Pangram hoàn toàn AI: 982/986 | 99,59% | 98,96%-99,84% | Tỷ lệ phân loại hoàn toàn là AI cao trong số các đầu ra đủ điều kiện được chấm điểm |
Các khoảng này củng cố kết luận rằng tỷ lệ phát hiện AI đã biết được báo cáo là cao. Chúng không lấp đầy một nửa còn thiếu của thí nghiệm.
Để đo lường một công cụ phát hiện trong thế giới thực, chúng ta cần cả tài liệu AI và tài liệu do con người viết. Đó là cách duy nhất để xem liệu một công cụ có bắt được AI mà không buộc tội quá nhiều người hay không.
| Chỉ số | Các nghiên cứu chỉ về Astra có thể tính toán nó không? | Tại sao nó quan trọng | | --- | --- | --- | --- | | Tỷ lệ phát hiện trên văn bản AI đã biết | Có | Cho thấy tần suất công cụ bắt được các mẫu AI đã được cung cấp | | Tỷ lệ âm tính giả | Có | Cho thấy có bao nhiêu mẫu AI đã biết bị bỏ sót theo quy tắc thử nghiệm | | Độ đặc hiệu | Không | Yêu cầu văn bản do con người viết để đo lường tần suất công việc của con người được xóa đúng cách | | Tỷ lệ dương tính giả | Không | Yêu cầu văn bản do con người viết để đếm tần suất mọi người bị gắn cờ sai | | Độ chính xác (Precision) | Không | Phụ thuộc vào cả dương tính giả và mức độ phổ biến của văn bản AI trong quần thể đang được kiểm tra | | Độ chính xác tổng thể | Không | Yêu cầu cả ví dụ tích cực và tiêu cực, cộng với sự cân bằng lớp được xác định |
Việc gọi 999 trên 1.000 là "độ chính xác 99,9%" ngầm giả định rằng sai lầm duy nhất có thể xảy ra là bỏ sót AI. Trong một lớp học, phòng tin tức hoặc quy trình tuyển dụng, việc gắn cờ sai một người là một lỗi khác và thường có hậu quả nghiêm trọng hơn. Các thử nghiệm chỉ về Astra không được thiết kế để đo lường điều đó.
Tại sao cùng một văn bản GPT-6 Astra có thể nhận được các điểm số khác nhau
Kết quả của công cụ phát hiện nhạy cảm với tài liệu trước mặt chúng. Chỉ riêng tên mô hình không thể dự đoán điểm số cuối cùng.
Độ dài đoạn văn thay đổi tín hiệu có sẵn. Một email 20 từ và một báo cáo 1.000 từ có thể đến từ cùng một mô hình nhưng cung cấp lượng bằng chứng rất khác nhau. Điểm thấp trên các đoạn trích ngắn cần được giải thích đặc biệt thận trọng.
Thể loại thay đổi mẫu ngôn ngữ. Trong thử nghiệm của Originality.ai, văn bản hội thoại chứa lỗi duy nhất. Các phân loại không hoàn toàn là AI của Pangram bao gồm các định dạng như thơ, email và giải thích ngắn. Một công cụ phát hiện được hiệu chỉnh trên các bài luận có thể hoạt động khác trên đối thoại hoặc văn xuôi sáng tạo.
Lời nhắc định hình đầu ra. Astra có thể tuân theo các ràng buộc chi tiết về giọng điệu, cấu trúc, đối tượng và ví dụ. Hai người sử dụng cùng một mô hình có thể nhận được văn bản với nhịp điệu và tính đặc thù rất khác nhau.
Các phiên bản và ngưỡng của công cụ phát hiện khác nhau. Mỗi công cụ xác định nhãn, dữ liệu đào tạo, độ dài tối thiểu và ngưỡng quyết định riêng của mình. Một tỷ lệ phần trăm từ dịch vụ này không phải là điểm số bạn có thể so sánh từng điểm với dịch vụ khác.
Chỉnh sửa của con người thay đổi văn bản đang được xem xét. Thêm bằng chứng gốc, sắp xếp lại một lập luận, sửa lỗi thực tế và viết lại từ kiến thức cá nhân có thể làm thay đổi mẫu thống kê. Điều đó không đưa ra một công thức đáng tin cậy để tránh bị phát hiện, và nó không xóa bỏ nhu cầu tiết lộ việc sử dụng AI khi một chính sách yêu cầu.
Một công cụ phát hiện có thể cho biết GPT-6 Astra đã viết nó không?
Không. Một công cụ phát hiện văn bản điển hình không xác định chính xác mô hình đã tạo ra một đoạn văn. Không có công cụ nào trong số năm công cụ trong so sánh đa công cụ phát hiện đặt tên Astra; chúng trả về các biến thể của AI, hỗn hợp, con người hoặc điểm xác suất.
| Câu hỏi | Một công cụ phát hiện văn bản có thể trả lời nó không? | | --- | --- | --- | | Đoạn văn này có giống các mẫu liên quan đến văn bản AI không? | Nó có thể ước tính điều này, với sự không chắc chắn. | | AI có tham gia vào quá trình viết ở đâu đó không? | Không đáng tin cậy chỉ từ văn bản cuối cùng. | | GPT-6 Astra có cụ thể tạo ra đoạn văn này không? | Không. Điểm số không xác định chính xác mô hình. | | Ai đã nhập lời nhắc hoặc chỉnh sửa đầu ra? | Không. Lịch sử đó nằm ngoài văn bản. | | Tài liệu có vi phạm chính sách của trường học hoặc nơi làm việc không? | Không. Điều đó yêu cầu chính sách, ngữ cảnh và phán đoán của con người. |
Do đó, cách diễn đạt hợp lý nhất là "đoạn văn được gắn cờ là giống AI", chứ không phải "công cụ phát hiện đã chứng minh điều này được viết bởi GPT-6 Astra."
Cách kiểm tra văn bản GPT-6 Astra bằng Lynote
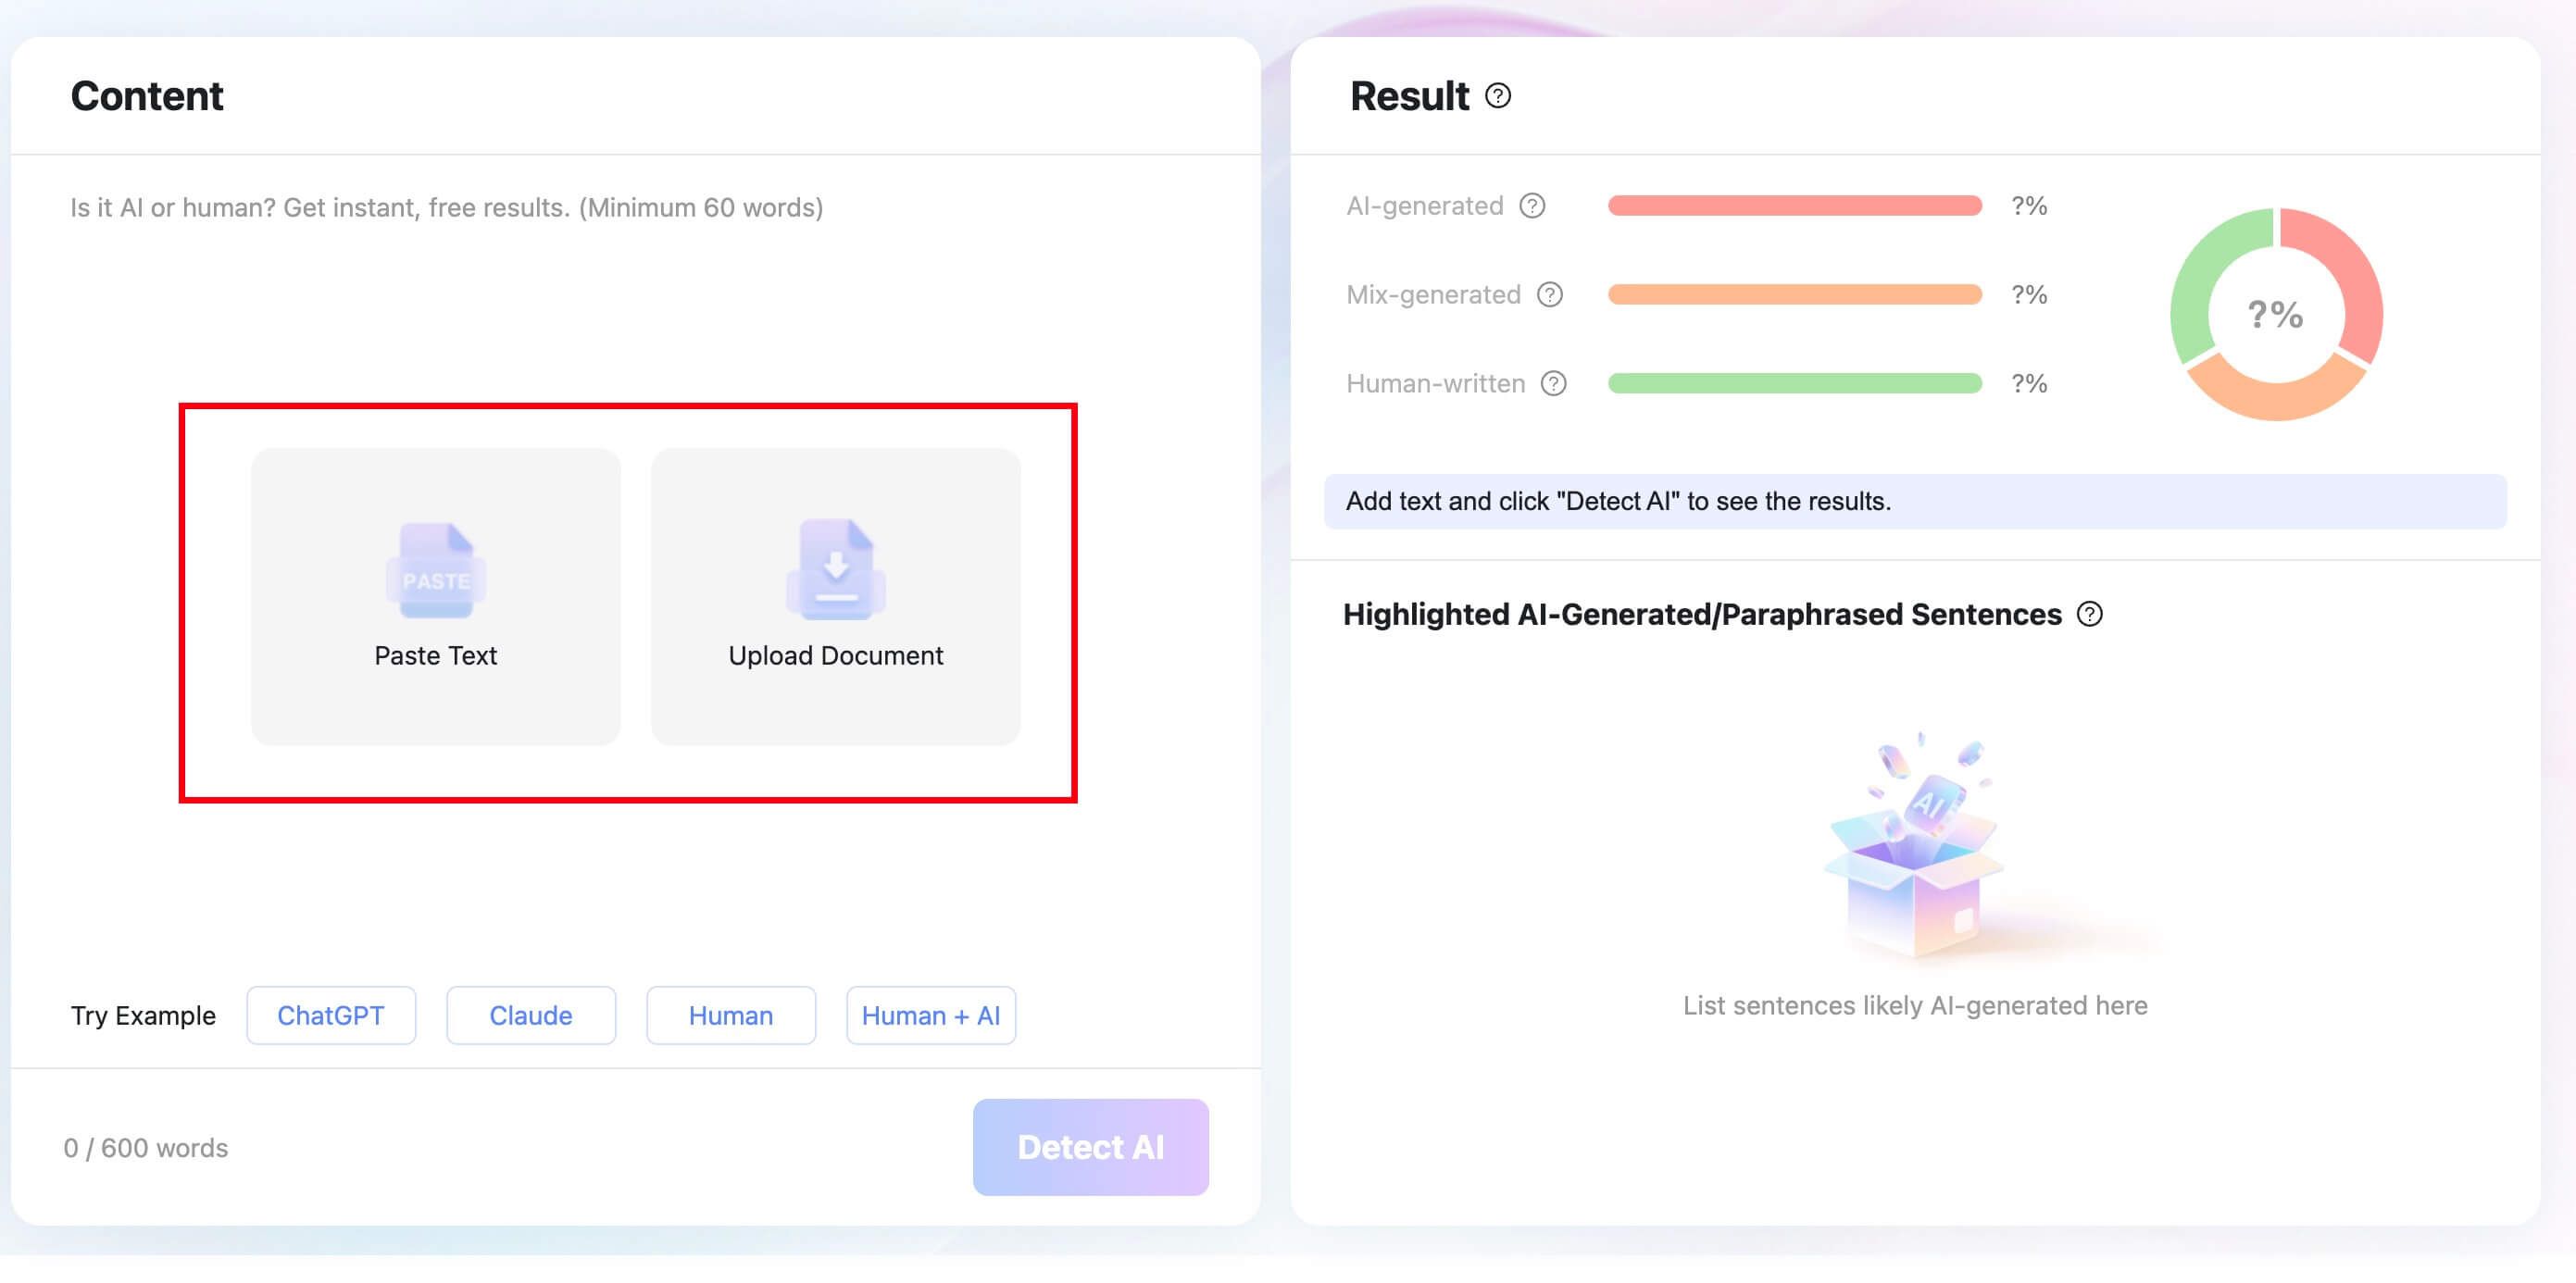
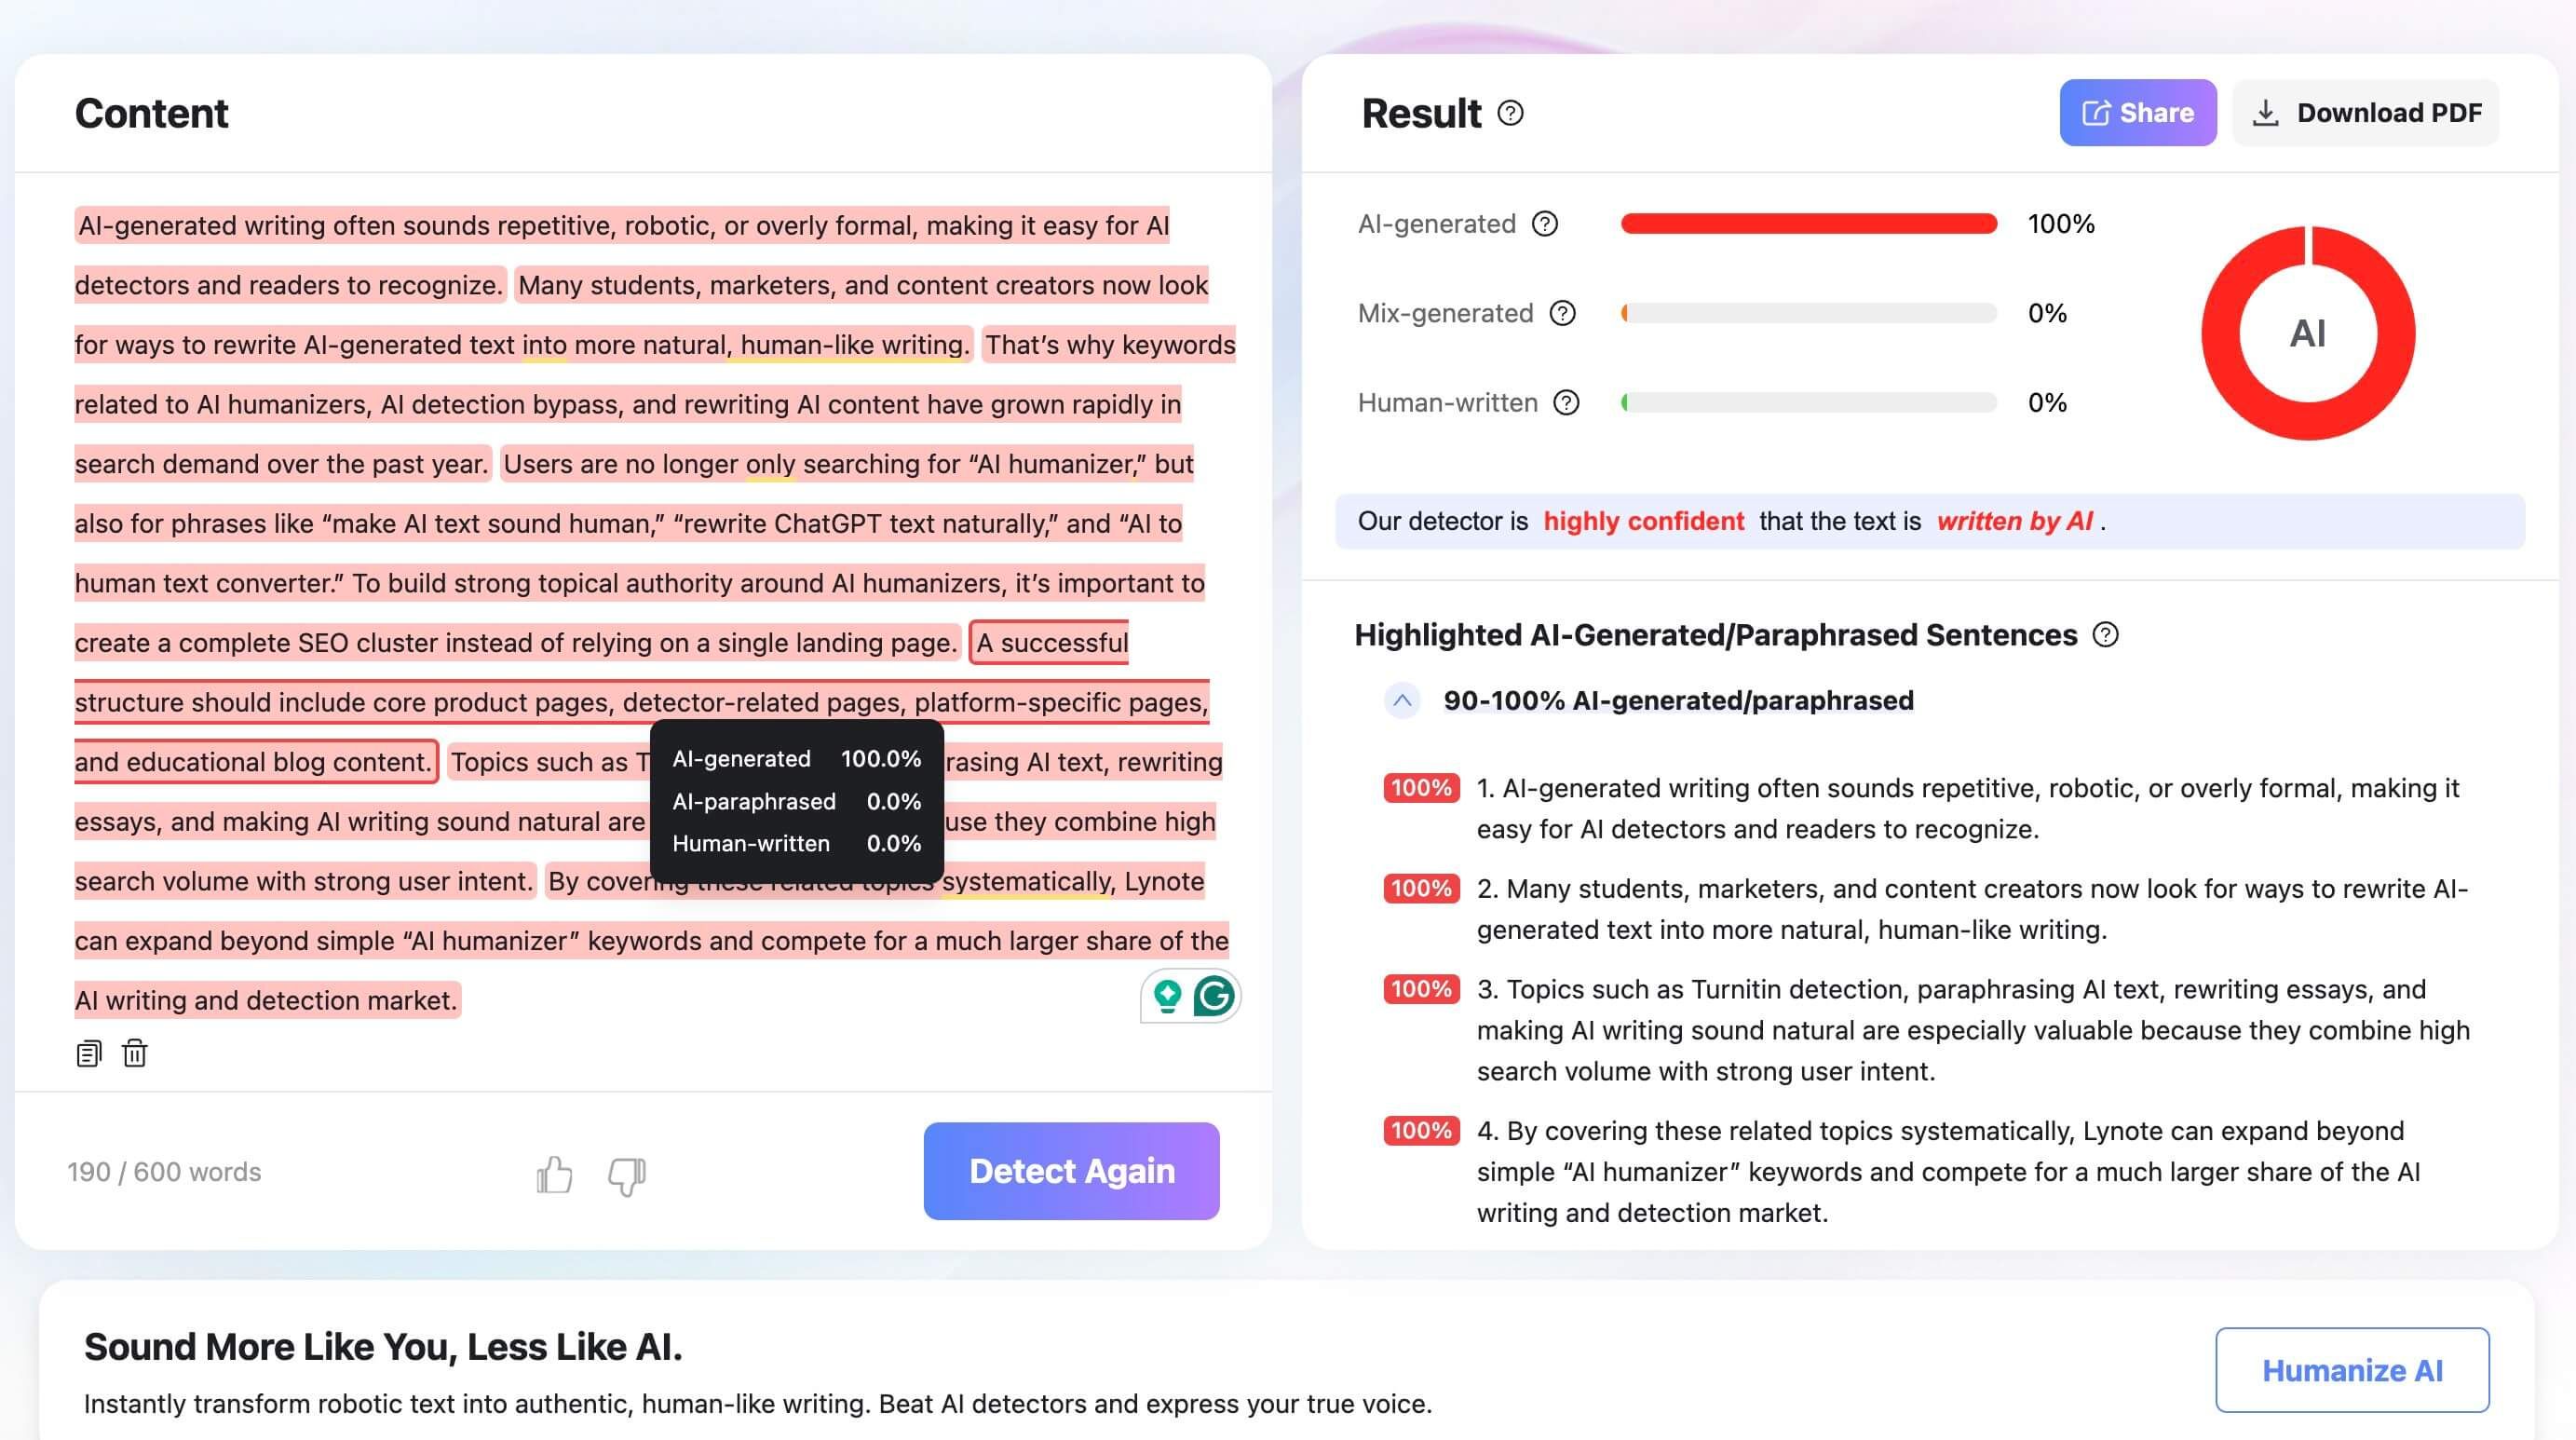
Nếu bạn muốn xem xét một bản nháp hoàn chỉnh thay vì đoán từ vài câu, Lynote AI Detector cung cấp một quy trình làm việc đơn giản ban đầu. Nó phân tách kết quả của mình thành tỷ lệ phần trăm được tạo bởi AI, hỗn hợp và do con người viết, đồng thời làm nổi bật các câu để xem xét kỹ hơn.
-
Dán văn bản hoặc tải lên tài liệu. Sử dụng hộp văn bản để kiểm tra nhanh, hoặc tải lên tệp DOCX, PDF hoặc TXT được hỗ trợ. Gửi một phần có ý nghĩa thay vì một dòng riêng lẻ nếu có thể.
-
Chạy quét. Nhấp vào Detect AI và để công cụ phân tích văn bản đã gửi.

-
Xem lại kết quả đầy đủ. Đọc cùng lúc các tỷ lệ phần trăm AI, hỗn hợp và con người, sau đó kiểm tra các câu được làm nổi bật thay vì chỉ phản ứng với con số lớn nhất.
-
So sánh tín hiệu với bằng chứng bên ngoài công cụ phát hiện. Xem xét các bản nháp, lịch sử phiên bản, nguồn trích dẫn, ghi chú và lời giải thích của người viết trước khi đưa ra kết luận.
Kết quả có thể cho bạn biết nên tìm ở đâu. Nó không thể cho bạn biết ai đã viết tài liệu hoặc liệu việc sử dụng AI của nó có được phép hay không.

Cách diễn giải điểm AI cao hoặc thấp
Một điểm số chỉ trở nên hữu ích khi nó thay đổi những gì bạn xem xét tiếp theo.
| Nếu điểm số cao | Nếu điểm số thấp |
|---|---|
| Đọc các đoạn văn được làm nổi bật trong ngữ cảnh. | Đừng coi kết quả là bằng chứng cho thấy một người đã viết nó. |
| Kiểm tra các tuyên bố, trích dẫn, ví dụ và những thay đổi bất thường trong giọng văn. | Kiểm tra xem đoạn văn có quá ngắn để có kết quả ổn định không. |
| So sánh tài liệu với các bản nháp trước đó hoặc lịch sử phiên bản. | Hãy nhớ rằng các công cụ phát hiện có thể bỏ sót văn bản AI và các bản cập nhật mô hình có thể thay đổi hiệu suất. |
| Hỏi người viết về quy trình thay vì trình bày điểm số như một phán quyết. | Sử dụng các bằng chứng khác nếu quyền tác giả hoặc việc tuân thủ chính sách là quan trọng. |
| Yêu cầu xem xét lại lần thứ hai bởi con người đối với các quyết định quan trọng. | Tránh tuyên bố tài liệu "đã được xác minh là của con người" chỉ từ một lần quét. |
Đối với những người viết tự xem xét công việc của mình, điểm số cao không phải là hướng dẫn để thực hiện các thay thế ngẫu nhiên hoặc thêm lỗi cố ý. Một phản ứng tốt hơn là xác minh mọi tuyên bố, thay thế các phần điền vào chung chung bằng bằng chứng cụ thể và đảm bảo rằng lập luận cuối cùng phản ánh sự hiểu biết của riêng bạn.
Đối với các nhà giáo dục và biên tập viên, công cụ phát hiện nên bắt đầu một quá trình xem xét, chứ không phải kết thúc nó. Bằng chứng về quy trình thường cho bạn biết nhiều hơn một xác suất gắn liền với bản nháp cuối cùng.
Vấn đề dương tính giả vẫn quan trọng
Tỷ lệ phát hiện AI đã biết cao và dương tính giả có thể tồn tại cùng lúc. Một công cụ phát hiện có thể bắt được gần như mọi mẫu Astra trong một tiêu chuẩn nhưng vẫn gặp khó khăn với các loại văn bản do con người viết cụ thể.
Các nhà nghiên cứu Stanford trước đây đã phát hiện ra rằng các công cụ phát hiện GPT được sử dụng rộng rãi thường xuyên phân loại sai văn bản của các tác giả không phải người bản xứ tiếng Anh. Một nghiên cứu gần đây hơn vào năm 2026 đã kiểm tra 135.389 cặp bản thảo do con người viết trước và sau khi được chỉnh sửa tiếng Anh chuyên nghiệp. Trên 13 công cụ phát hiện, tỷ lệ dương tính giả được báo cáo trải dài toàn bộ phạm vi có thể, và cùng một thay đổi chỉnh sửa đã đẩy các công cụ phát hiện khác nhau theo các hướng đối lập.
Điều đó không có nghĩa là mọi công cụ phát hiện đều vô dụng. Nó có nghĩa là phong cách có thể trở thành một biến số gây nhiễu: cách diễn đạt trang trọng, ngữ pháp nhất quán, từ vựng hạn chế hoặc chỉnh sửa chuyên nghiệp có thể ảnh hưởng đến điểm số ngay cả khi quyền tác giả không thay đổi.
Hướng dẫn của chính Turnitin phản ánh sự không chắc chắn này. Nó mô tả báo cáo AI của mình là một điểm dữ liệu và nói rằng nó không nhằm mục đích cung cấp câu trả lời dứt khoát một cách riêng lẻ.
Đó cũng là lời khuyên hợp lý ngoài giáo dục. Một điểm số, công việc, quyết định xuất bản hoặc cáo buộc không nên dựa vào một tỷ lệ phần trăm không rõ ràng.
Câu hỏi thường gặp về phát hiện AI GPT-6 Astra
Turnitin có thể phát hiện GPT-6 Astra không?
Turnitin có thể gắn cờ văn bản được tạo bởi các mô hình ngôn ngữ mới hơn khi văn bản khớp với các mẫu mà hệ thống của nó liên kết với AI. Tuy nhiên, không có tiêu chuẩn Turnitin cụ thể cho Astra nào được xem xét trong bài viết này thiết lập tỷ lệ phát hiện, và Turnitin nói rằng báo cáo của họ không nên được sử dụng làm câu trả lời dứt khoát một mình.
Một công cụ phát hiện AI có thể xác định cụ thể GPT-6 Astra không?
Không. Kết quả của công cụ phát hiện hiện tại thường ước tính liệu văn bản trông giống được tạo bởi AI, hỗn hợp hay giống con người. Chúng không đáng tin cậy xác định Astra là mô hình chính xác hoặc tiết lộ lịch sử lời nhắc và chỉnh sửa.
Chỉnh sửa văn bản GPT-6 Astra có làm thay đổi điểm số của nó không?
Có thể. Chỉnh sửa có ý nghĩa của con người thay đổi cách diễn đạt, cấu trúc, bằng chứng và giọng văn, điều này có thể làm thay đổi ước tính mẫu của công cụ phát hiện. Hướng thay đổi là không thể đoán trước, và việc chỉnh sửa nên cải thiện độ chính xác và chất lượng tác giả hơn là nhằm mục đích thao túng điểm số.
Một công cụ phát hiện cần bao nhiêu văn bản?
Yêu cầu khác nhau tùy theo công cụ. Trong một thí nghiệm Astra, khả năng phát hiện trên cùng các đoạn văn đã tăng từ 9 trên 40 ở 25 từ lên 29 trên 40 ở 50 từ và tất cả 40 ở 100 từ. Kết quả đó thuộc về một công cụ phát hiện, nhưng nó cho thấy tại sao một đoạn văn hoàn chỉnh lại cung cấp nhiều thông tin hơn một câu.
Điểm AI cao nhất có thể có phải là bằng chứng cho thấy Astra đã viết văn bản không?
Không. Đó là phân loại mạnh nhất của công cụ phát hiện theo mô hình và thang đo riêng của nó. Nó không chứng minh mô hình AI nào đã được sử dụng, ai đã sử dụng nó, hoặc liệu một người có chỉnh sửa đáng kể tài liệu hay không.
Văn bản do con người viết có thể bị gắn cờ là nội dung GPT-6 không?
Văn bản do con người viết có thể nhận được điểm giống AI, đặc biệt khi một công cụ phát hiện phản ứng với phong cách hơn là nguồn gốc. Văn bản tiếng Anh không phải bản xứ, văn xuôi học thuật được tiêu chuẩn hóa cao và văn bản được chỉnh sửa chuyên nghiệp cần được đặc biệt thận trọng vì nghiên cứu đã ghi nhận các trường hợp dương tính giả không nhất quán.
Điểm thấp có phải là bằng chứng cho thấy một người đã viết văn bản không?
Không. Điểm thấp có nghĩa là công cụ phát hiện không tìm thấy đủ bằng chứng liên quan đến AI để vượt ngưỡng của nó. Các đoạn văn ngắn, thể loại bất thường và đầu ra AI đã chỉnh sửa đều có thể làm giảm độ tin cậy phát hiện.
Phán quyết cuối cùng
GPT-6 Astra có thể phát hiện được trong các thử nghiệm đã công bố mạnh nhất cho đến nay. Originality.ai đã gắn cờ 999 trên 1.000 đầu ra Astra đã biết, Pangram đã phân loại hoàn toàn 982 trên 986 đầu ra đủ điều kiện là AI, và năm công cụ phát hiện riêng biệt đã đồng ý về một bài luận Astra chưa chỉnh sửa.
Những kết quả đó hỗ trợ một kết luận hẹp: các công cụ phát hiện hiện tại thường có thể nhận ra văn xuôi Astra dạng dài, chưa chỉnh sửa. Chúng không cho thấy rằng mọi công cụ phát hiện đều đáng tin cậy như nhau, rằng văn bản ngắn hoặc đã chỉnh sửa sẽ hoạt động theo cùng một cách, hoặc rằng một điểm số chứng minh quyền tác giả.
Viết bởi Danny
Quản lý Tiếp thị Sản phẩm
Danny giải thích cách các tính năng của Lynote phù hợp với quy trình làm việc thực tế, từ năng suất hàng ngày đến các trường hợp sử dụng viết nội dung định hướng sản phẩm. Xem mọi bài viết →